H13. 웹서버(Apache) 워커 부족·LB 중단 대응
Diátaxis: How-to(목표별 가이드) · 대상: 운영자 / 관리자 ← 목차로
웹서버(Apache 등)는 요청을 워커가 처리합니다. 워커가 모두 바쁘면 새 요청은 대기·거부되고, 로드밸런서(LB)의 워커 그룹이 통째로 멈추면 그 경로의 요청이 **전부 실패(5xx)**합니다. 이 문서는 웹서버 ▸ 웹 성능/대시보드의 워커 지표와 LB 이벤트로 두 상황을 가려 대응하는 순서입니다.
웹서버 차트의 항목별 임계치는 R2.2 웹서버 차트에, 워커·LB 관련 이벤트는 R3.5 웹서버 로드밸런서에 있습니다. WAS 쪽 지연이 의심되면 H6. 느린 트랜잭션 원인 찾기를 보세요.
여는 법 — 좌측 메뉴 ▸ 웹서버 ▸ (호스트 선택) ▸ 웹 성능 · 대시보드
워커 상태(Active/Idle) 읽기 — 워커 부족
워커 상태 차트는 활성(Active, 처리 중) 워커와 유휴(Idle, 대기) 워커 수를 보여 줍니다. Idle 이 0 에 가까워지는가가 핵심입니다.
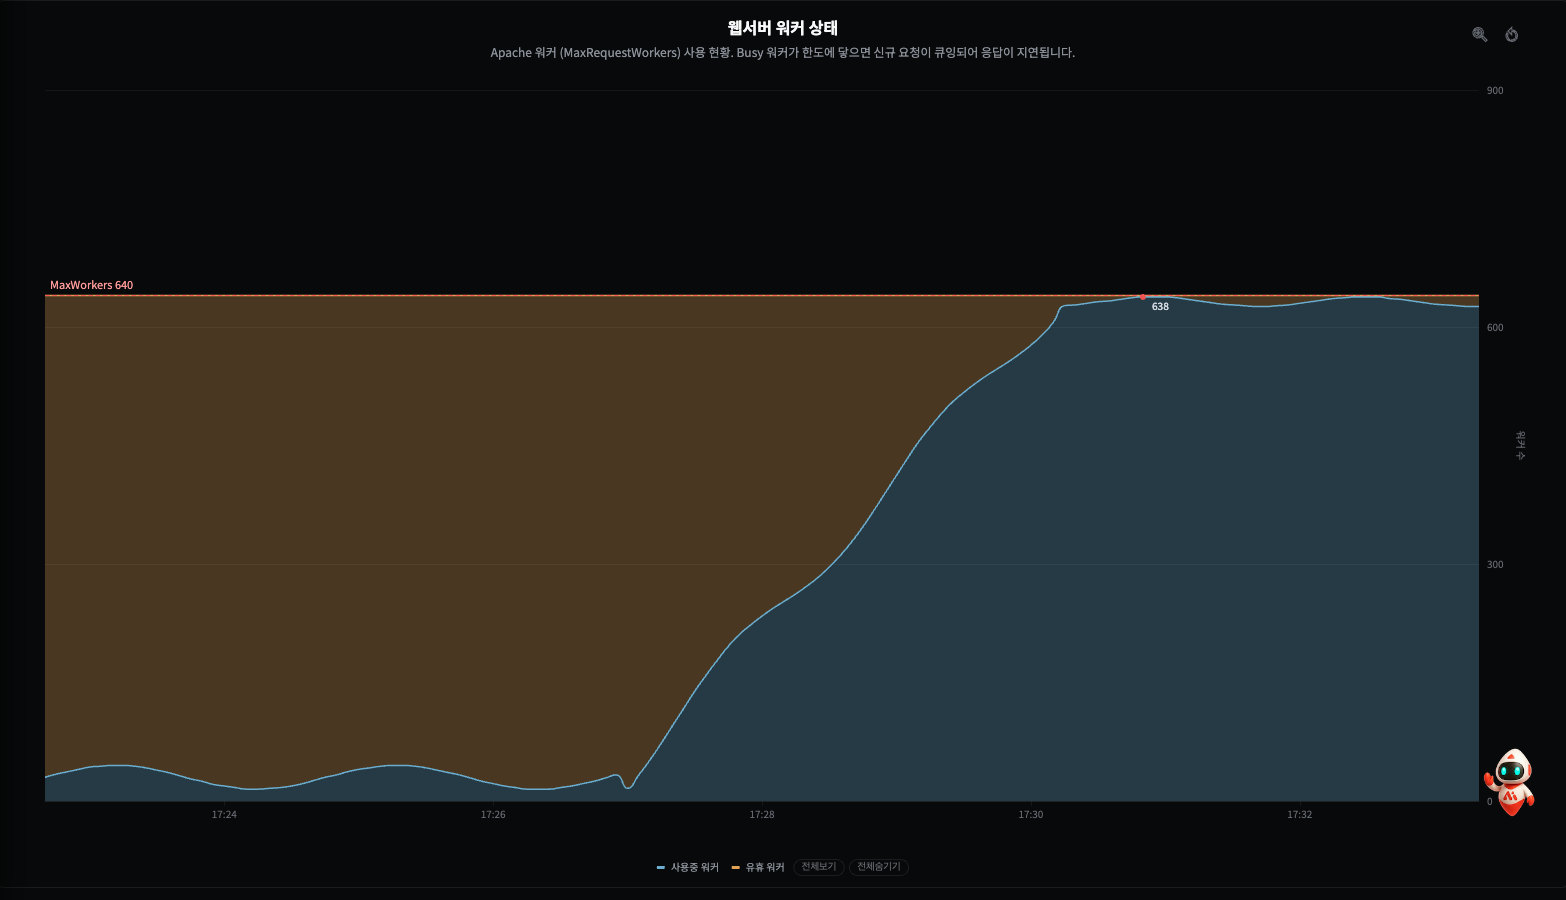
위 화면이 워커 고갈입니다 — 트래픽이 몰리자 사용중 워커(파랑)가 계단처럼 차올라 MaxWorkers(640, 빨강 점선)에 붙고, 그만큼 유휴 워커가 0으로 줄어듭니다. 이 시점부터 새 요청은 받을 워커가 없어 큐에서 대기하다 늦어지거나 거부됩니다.
| 모습 | 해석 |
|---|---|
| Idle 워커가 넉넉히 남음 | 정상 — 새 요청을 즉시 받을 여유가 있음 |
| Idle 이 자주 0 에 닿음(Active가 MaxWorkers 근처) | 주의 — 워커에 여유가 없음. 곧 대기·거부 직전 |
| Active 가 MaxWorkers 에 붙은 채 평탄, Idle 0 | 위험 — 워커 고갈. 새 요청을 못 받아 접속 실패 |
이때 웹 워커 사용률 이벤트(임계 초과)가 함께 뜹니다.
핵심 워커 고갈의 원인은 대개 워커 자체가 모자라서가 아니라, 워커가 백엔드(WAS·DB) 응답을 기다리느라 오래 붙잡혀 있기 때문입니다. 워커 하나가 느린 백엔드 응답을 기다리는 동안 그 워커는 다른 요청을 못 받습니다. 그래서 백엔드 응답시간을 함께 봐야 합니다.
진단 순서
- 워커 상태 차트에서 Active/Idle 비율과 MaxWorkers 대비 위치를 봅니다.
- 연결 상태 차트(Reading/Writing/Keep-alive)를 함께 봅니다 — Writing 이 많으면 느린 백엔드(워커가 백엔드 응답을 쓰는 중 대기), Reading 이 많으면 느린 클라이언트입니다.
- 백엔드가 원인이면 WAS 쪽으로 넘어갑니다 → H6 · H8. DB 풀.
LB 워커 그룹 중단 — 서비스 중단 진단
로드밸런서는 백엔드별 워커 멤버를 묶어 트래픽을 분배합니다. 멤버나 그룹이 멈추면 R3.5 이벤트로 알려 줍니다.
| 이벤트 | 의미 | 영향 |
|---|---|---|
| 그룹 전체 중지 | LB 그룹의 모든 워커가 중지 | 이 그룹 요청이 전부 실패(5xx) — 서비스 중단 |
| 멤버 중지 | 특정 멤버 워커 중지(백엔드 다운·헬스체크 실패) | 잔여 멤버로 재분배 → 과부하 위험 |
| 그룹/멤버 복구 | 가용 워커가 다시 생김 | 재개됐으나 중단 구간 영향이 남아 있음 |
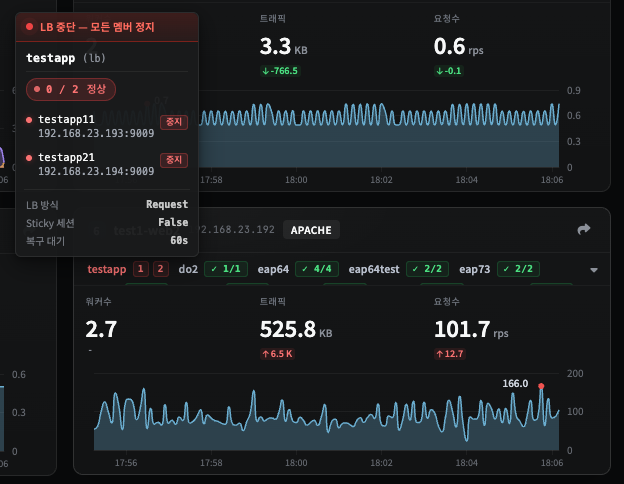
위 화면이 그룹 전체 중지입니다 — testapp LB 그룹이 0 / 2 정상(멤버 2개 모두 중지),
testapp11(192.168.23.193:9009)·testapp21(192.168.23.194:9009)이 나란히 중지로 빨갛게
표시됩니다. 이 그룹으로 가는 요청은 받을 백엔드가 없어 **전부 실패(5xx)**합니다.
- 그룹 전체 중지는 가장 심각합니다 — 모든 백엔드 멤버가 동시에 빠진 것이라, 흔히 직전 배포·일괄 재시작·공통 의존성(DB·인증) 장애가 원인입니다. 배포 이력을 즉시 확인합니다.
- 멤버 중지가 잇따르면, 남은 멤버에 트래픽이 몰려 그 멤버까지 무너지는 **연쇄(cascade)**로 번질 수 있습니다. 잔여 멤버 부하를 함께 봅니다.
조치
| 확인된 상황 | 1차 조치 |
|---|---|
| 워커 고갈인데 백엔드가 느림 | 근본 원인은 백엔드 — 느린 SQL·외부호출·DB 풀 점검 (H6·H8). 워커만 늘리면 미봉책 |
| 백엔드는 정상인데 워커가 작음 | MaxWorkers(MaxRequestWorkers) 상향 — 메모리 여유와 함께 검토 |
| LB 멤버 중지 | 해당 백엔드(WAS) 기동·헬스체크 상태 확인 → H20. 에이전트 점검. 잔여 멤버 과부하 주시 |
| LB 그룹 전체 중지(서비스 중단) | 배포 이력 즉시 확인 + 공통 의존성(DB·인증) 점검. 배포 회귀면 롤백, 의존성이면 그쪽 복구 |
| 급한 불 | 정상 백엔드로 트래픽 우회, 멤버 순차 복구로 용량 회복 |
주의 워커·연결 임계는 이벤트 알림으로도 옵니다. 같은 웹서버에서 워커 고갈이 반복되면 일회성 대응보다 백엔드 용량·알림 정책으로 다룹니다(H15. 알림 정책).
잘 안될 때
| 증상 | 점검 |
|---|---|
| 웹서버 탭에 데이터 없음 | 웹서버 에이전트(Apache 모듈) 연결 상태 — H20. 에이전트 점검 |
| 워커는 여유 있는데 느림 | 워커 문제 아님 — 클라이언트 구간(Reading)·네트워크(H11) 확인 |
| LB 이벤트 원인이 안 보임 | 같은 시간대 WAS 트랜잭션·DB·배포 이력과 교차 — R3 |
관련 문서
- R2.2 웹서버 차트 · R3.5 웹서버 로드밸런서
- H6. 느린 트랜잭션 원인 찾기 · H8. DB 커넥션 풀 고갈 — 백엔드가 워커를 묶을 때
- H11. 서버 소켓 과다 진단 · H20. 에이전트 상태 점검
- H14. AI로 차트·이벤트 분석 받기