H6. 느린 트랜잭션 원인 찾기 — 문제 패턴 20종
Diátaxis: How-to(목표별 가이드) · 대상: 운영자 / 개발자 ← 목차로
"이 트랜잭션이 느린 건 알겠는데, 어디서 시간을 잃었는지 모르겠다"면 이 문서입니다. 트랜잭션 상세의 성능 분석 탭은 느리거나 비정상인 원인을 20가지 문제 패턴으로 자동 분류해 카드로 보여 줍니다. 시간순(waterfall)으로 확인하는 대신 패턴으로 보면 원인이 즉시 보입니다. 이 문서는 카드 하나하나가 무엇을 의미하고, 무엇을 확인하고, 어떻게 조치하는지를 정리합니다.
트랜잭션 추적이 처음이라면 T2. 느린 요청 하나 끝까지 추적해보기를 먼저 따라 해 보세요. 느린 SQL은 T3. AI로 원인 분석하기의 AI 쿼리 진단으로 실행계획까지 바로 분석할 수 있습니다. 서비스 전체의 응답 분포 패턴은 H5. T-Map 패턴으로 진단하기를 보세요.
여는 법 — WAS ▸ 대시보드의 트랜잭션 히트맵(T-Map) 위젯 → 위쪽(느린) 점이 몰린 구간을 드래그 → 목록에서 트랜잭션 클릭 → 성능 분석 탭. (같은 T-Map은 WAS ▸ 애플리케이션 ▸ 트랜잭션 맵 탭에도 있습니다.)
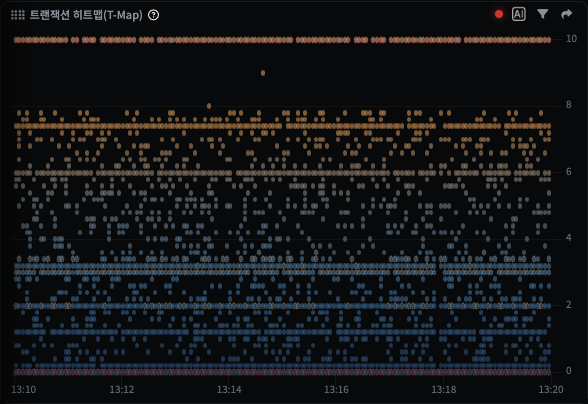
드래그하면 그 구간의 트랜잭션 조회 목록이 열립니다 — 드래그한 시간 범위와 응답시간 범위가 헤더에 표시되고, 목록은 응답시간이 큰(느린) 행부터 확인하면 됩니다.
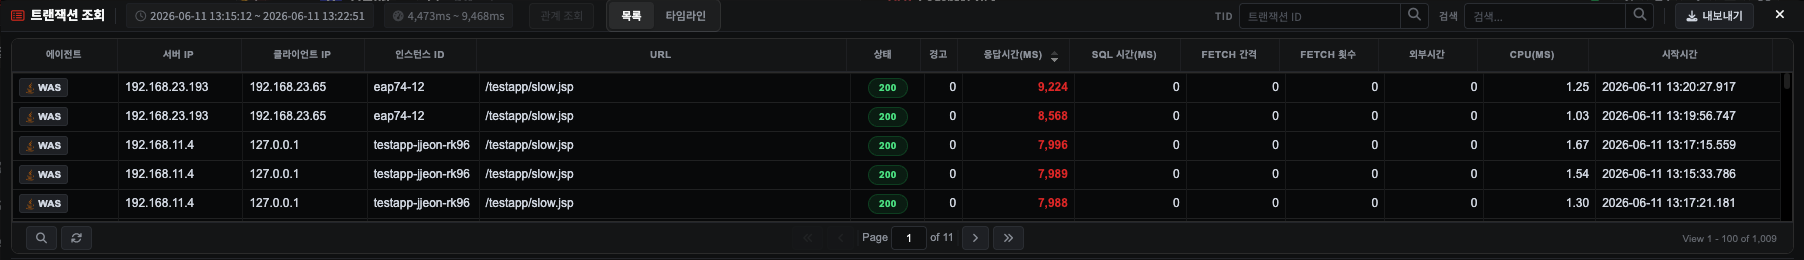
T-Map 없이 WAS ▸ 트랜잭션(가장 느린 트랜잭션) 목록에서 응답시간이 큰 행을 직접 클릭해도 됩니다.
어느 경로로든 트랜잭션을 클릭하면 상세 다이얼로그가 열리고, 성능 분석 탭 상단에 문제 감지 카드가 표시됩니다(감지된 패턴이 없으면 "감지된 문제 없음").
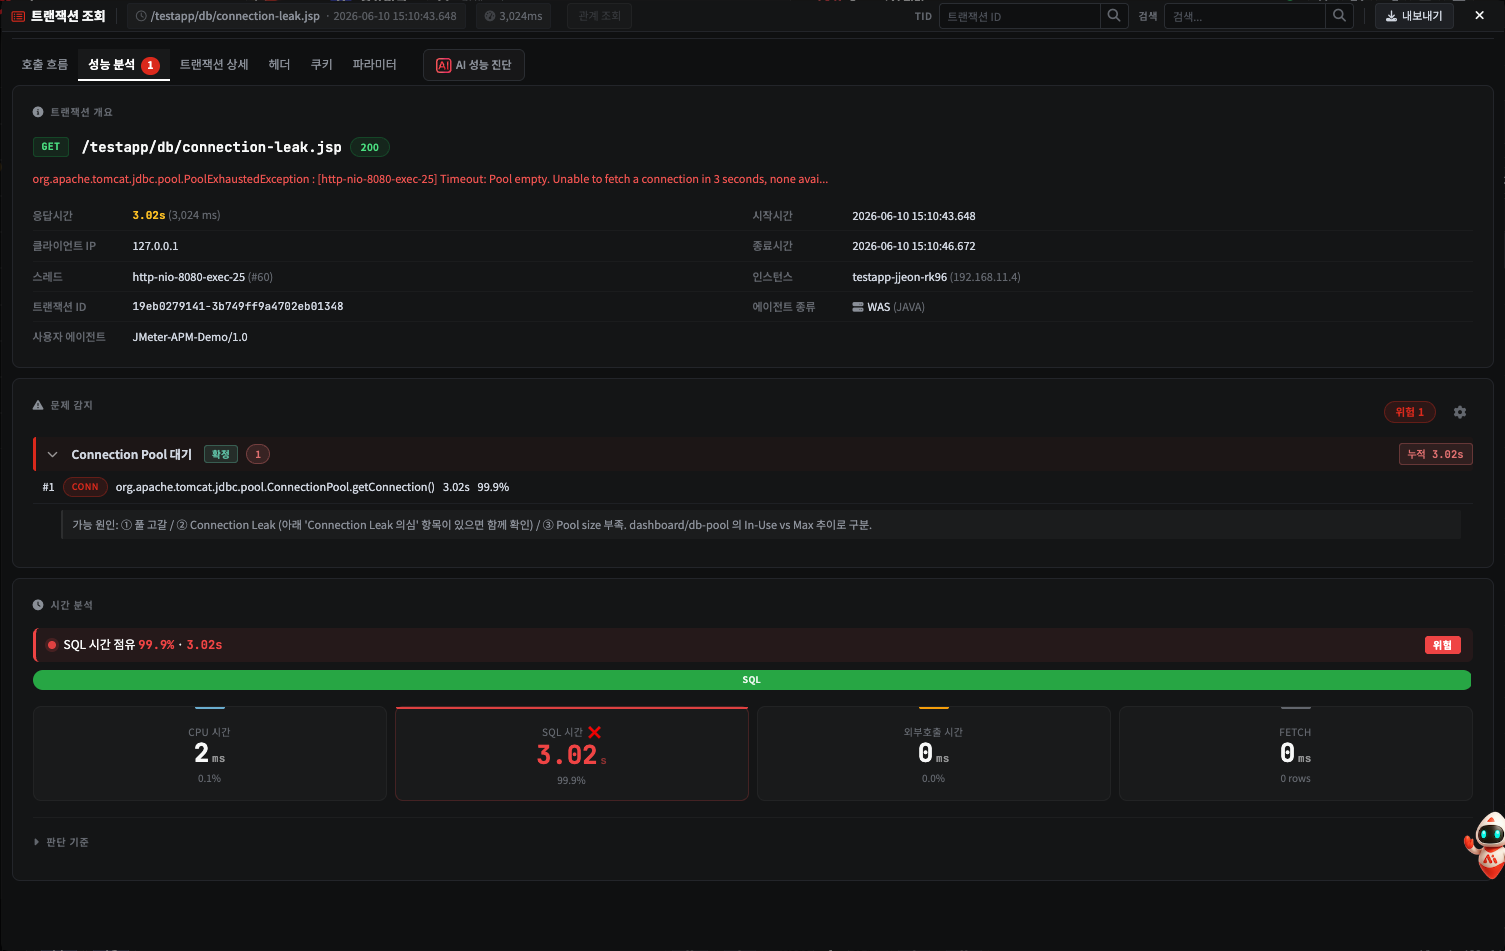
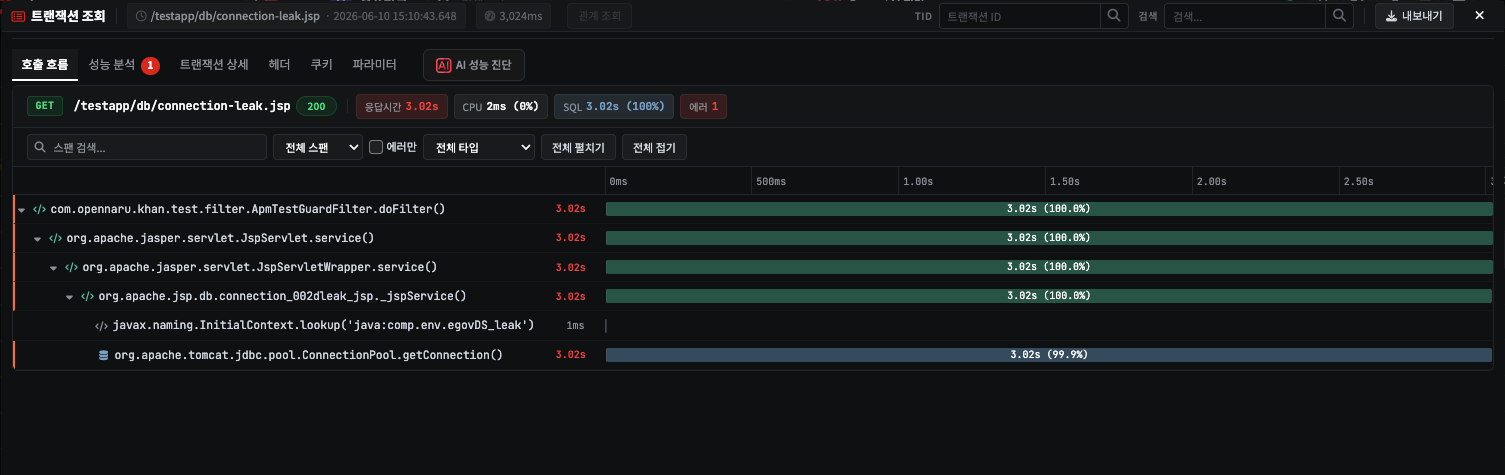
카드를 클릭하면 호출 흐름 탭(waterfall)으로 전환되며 해당 패턴의 구간이 강조됩니다.
아래 예에서는 ConnectionPool.getConnection() 한 줄이 전체 시간(3.02초)을 차지하는 것이
막대로 드러납니다 — SQL이 느린 게 아니라 커넥션을 빌리는 데 시간을 다 쓴 것입니다.
카드 색으로 우선순위 정하기
문제 패턴은 3단계로 색상 분류됩니다. 카드 색만 보고 어디부터 볼지 정하세요.
| 단계 | 색 | 의미 | 패턴 수 |
|---|---|---|---|
| Tier 1 | 빨강 | 즉시 조치 — 사용자 영향 직접 / 인프라 차단 / 데이터 무결성 | 8 |
| Tier 2 | 주황 | 깊이 확인 — 성능 저하, 코드 수정으로 해결 가능 | 5 |
| Tier 3 | 회색·파랑 | 분석 정보 — 잠재 위험 또는 보조 신호 | 6 |
핵심 Tier 1부터 봅니다. Tier 1이 없으면 Tier 2로, Tier 2도 없으면 Tier 3로 내려갑니다.
패턴 20종 한눈에 보기
| # | 패턴 모양 | 제목 · 한 줄 의미 |
|---|---|---|
| Tier 1 | 빨강 — 즉시 조치 | |
| 1 |  | DB 연결 실패 — JDBC 드라이버가 DB에 못 닿음 (네트워크/방화벽/DB down) |
| 2 |  | SQL 문법 오류 — SQL 문장 자체가 파싱 안 됨 (코드 수정) |
| 3 |  | SQL 객체 참조 오류 — column/table 없음 (마이그레이션 누락 / ORM 매핑) |
| 4 |  | 데이터 무결성 위반 — unique/FK/not-null/check 위반 (validation / race) |
| 5 |  | 에러 — 일반 예외 / ERROR 로그 |
| 6 |  | 반복 에러 — 동일 에러 3회 이상 (downstream 장애 / retry storm) |
| 7 |  | Connection Pool 대기 — getConnection() 대기 — leak/풀 부족 ★ |
| 8 |  | DB Lock 대기 — SQL lock 경합 / deadlock / SELECT FOR UPDATE |
| Tier 2 | 주황 — 깊이 확인 | |
| 9 |  | N+1 의심 쿼리 — 동일 SQL 5회 이상 반복 (ORM lazy loading) |
| 10 |  | 누적 핫스팟 — 동일 SQL/URL의 누적 시간이 큼 |
| 11 |  | 느린 SQL 쿼리 — 단일 쿼리 100ms 초과 (인덱스 / 실행계획) |
| 12 |  | 느린 외부 호출 — 단일 외부 호출 200ms 초과 |
| 13 |  | 깊은 외부 호출 chain — 외부 호출 깊이 3+ 또는 호출 10+ |
| 20 |  | N개 반복 쿼리 — 동일 SQL 5회 이상이나 앞선 목록 조회를 찾지 못함 |
| Tier 3 | 회색·파랑 — 분석 정보 | |
| 14 |  | 느린 메소드 — CPU bound / Wait·IO bound 자동 분류 |
| 15 |  | 대량의 데이터 Fetch — 1,000행 이상 + fetch 시간 > 실행 시간 |
| 16 |  | 느린 데이터 처리 — 행당 fetch 1ms 이상 (fetchSize 미설정) |
| 17 |  | 외부 호출 직렬화 — 병렬 의도였으나 순차 실행 |
| 18 |  | 트리 구조 이상 — 호출 깊이 30+ 또는 한 부모의 자식 200+ |
| 19 |  | Connection Leak 의심 — 획득 1·해제 0 ★ (기본 비활성, 설정에서 켬) |
번호(#)는 아래 패턴 상세의 번호와 동일합니다. 각 도식의 우측 상단 배지가 Tier(색 우선순위)입니다. 20번은 나중에 더해진 패턴이라 번호는 끝이지만 자리는 Tier 2 입니다 — 기존 1~19번의 번호를 그대로 두려고 뒤에 붙였습니다.
★ 패턴 7과 19는 함께 뜨는 일이 잦습니다 — leak의 원인(19)과 결과(7). 동시에 떴으면 leak를 강력히 의심하세요.
Tier 1 — 빨강: 즉시 조치
1. DB 연결 실패
DB 서버 자체에 연결할 수 없어 SQL 실행이 시작도 못 한 상태입니다. 드라이버별 연결 실패
예외(MySQL CommunicationsException, ORA-12541 등)와 SQLState 08*, "Connection refused"
같은 메시지를 자동 인식합니다 (MySQL · MariaDB · Oracle · PostgreSQL · MS SQL Server ·
CUBRID · DB2 지원).
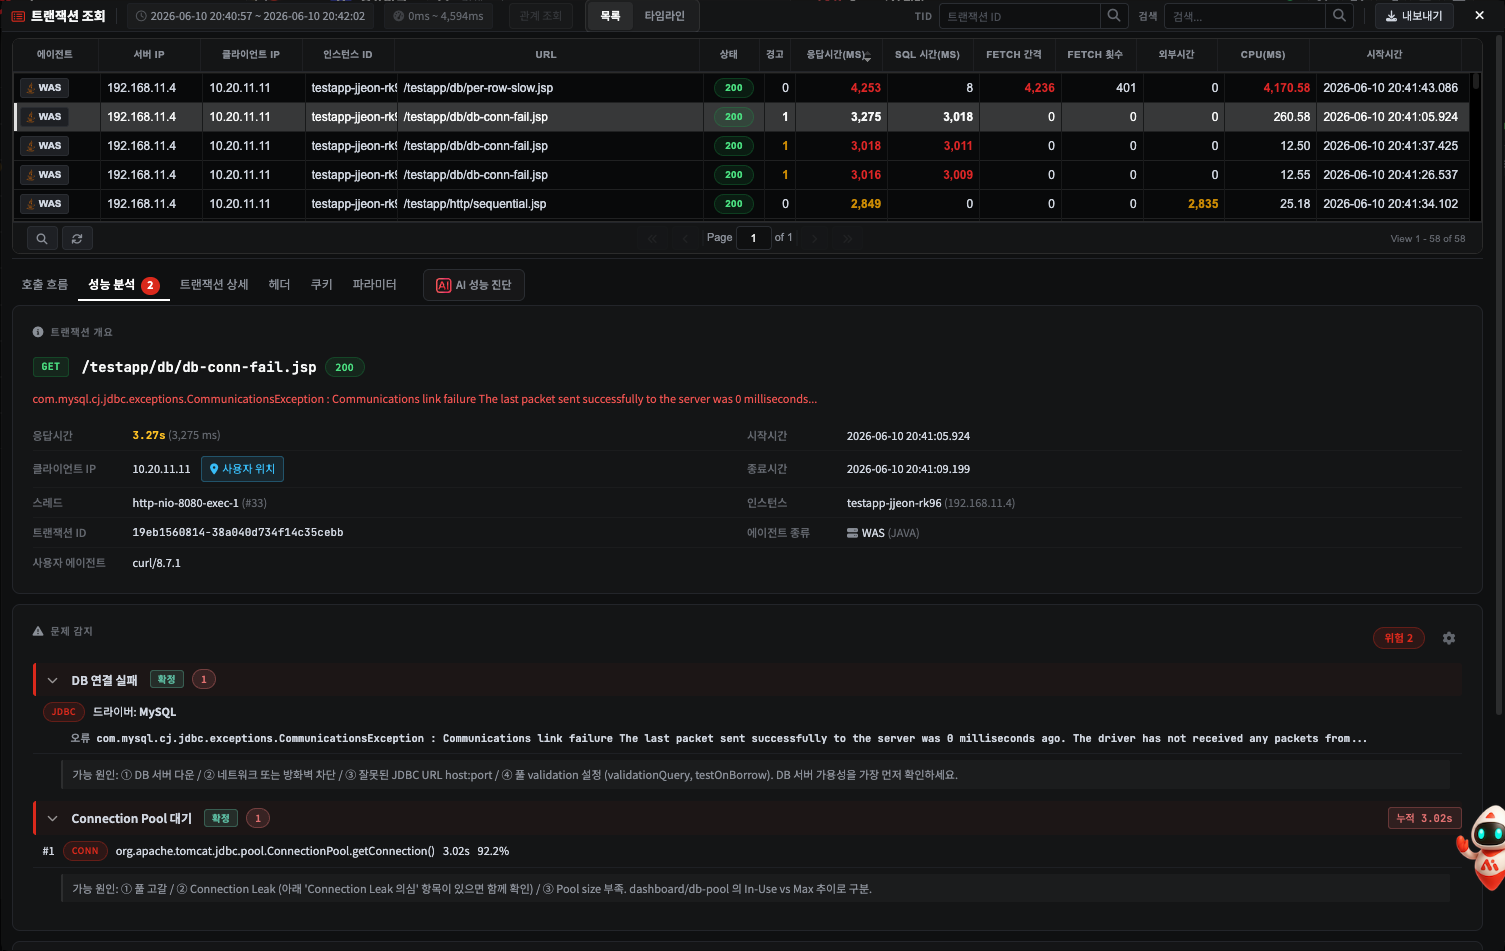
- 원인 — DB 다운·재시작 중 / 네트워크·방화벽 차단 / 잘못된 JDBC URL / 풀 validation 실패
- 조치 — DBMS 대시보드에서 해당 인스턴스 상태 확인 → WAS 호스트에서
nc -zv host port로 도달 확인 → JDBC URL(host·port·SID)·방화벽 룰 검증. DB가 다운이면 즉시 재기동.
구분 패턴 7(Connection Pool 대기)과 다릅니다 — 이 패턴은 DB 자체에 못 닿는 상태, 패턴 7은 DB는 정상인데 애플리케이션 안의 풀에서 대기하는 상태입니다.
2. SQL 문법 오류
SQL 문법이 잘못돼 DB가 쿼리를 파싱조차 못 했습니다. DB가 반환하는 vendor 코드(MySQL 1064,
ORA-00936 계열, SQLState 42*)로 분류합니다.
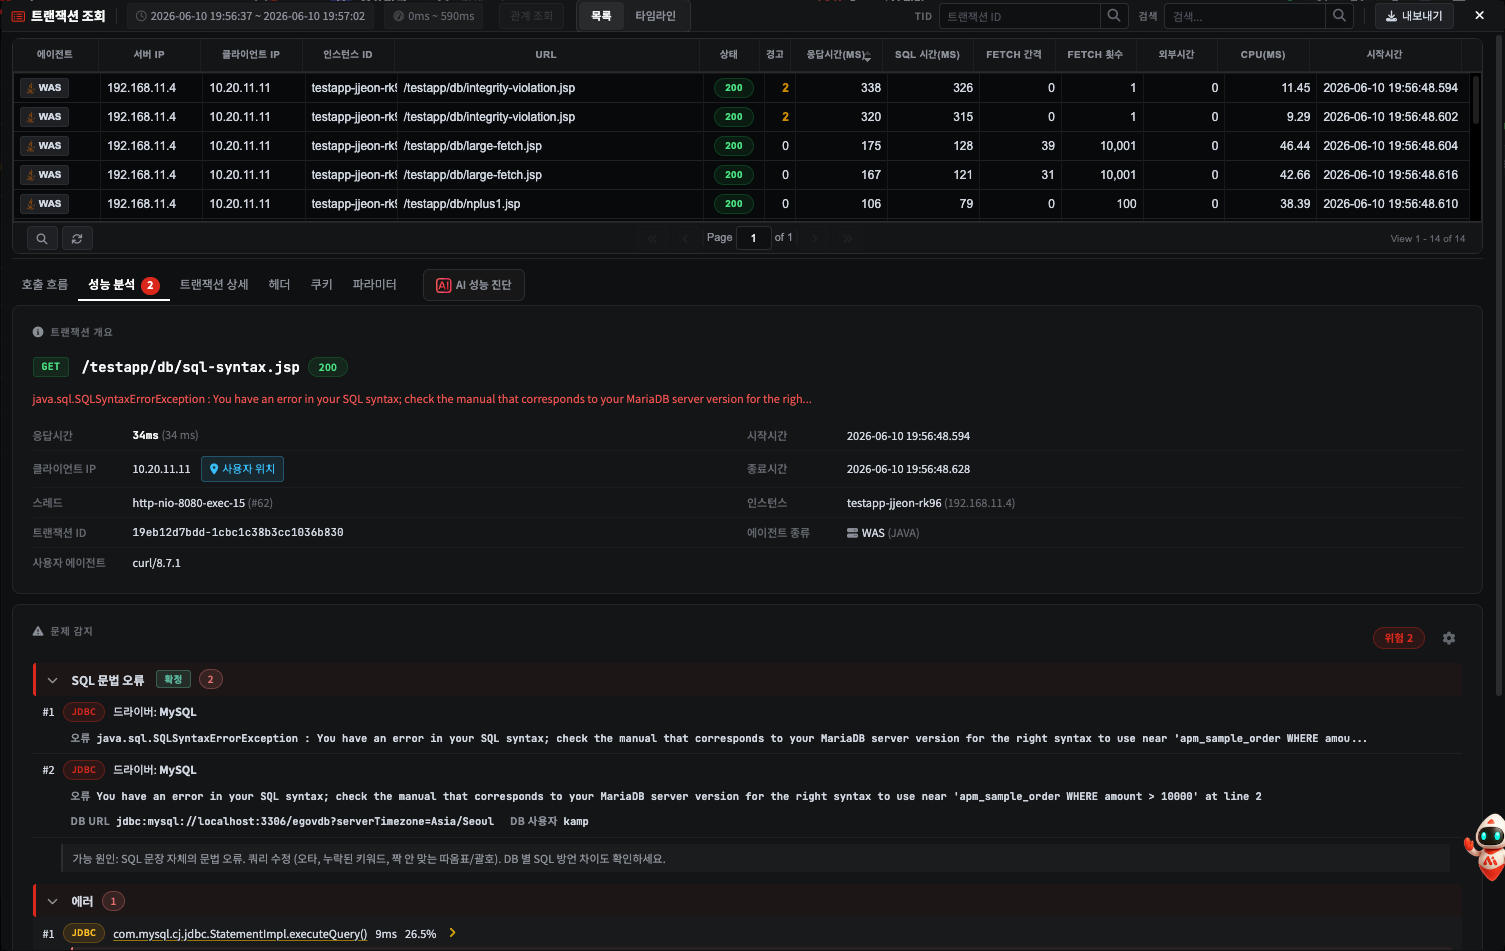
- 원인 — 하드코딩 SQL 오타 / 쿼리 빌더의 잘못된 조합 / 동적 SQL 조건 분기 누락 / DB 이관 후 dialect 차이
- 조치 — 에러 메시지의
near '...'위치를 보고 쿼리·코드 수정 후 재배포. 최근 배포 직후라면 회귀를 의심하세요.
3. SQL 객체 참조 오류
문법은 맞지만 참조하는 column/table이 DB 스키마에 없습니다 (MySQL 1054/1146,
ORA-00904/ORA-00942, SQLState 42703/42P01 등).
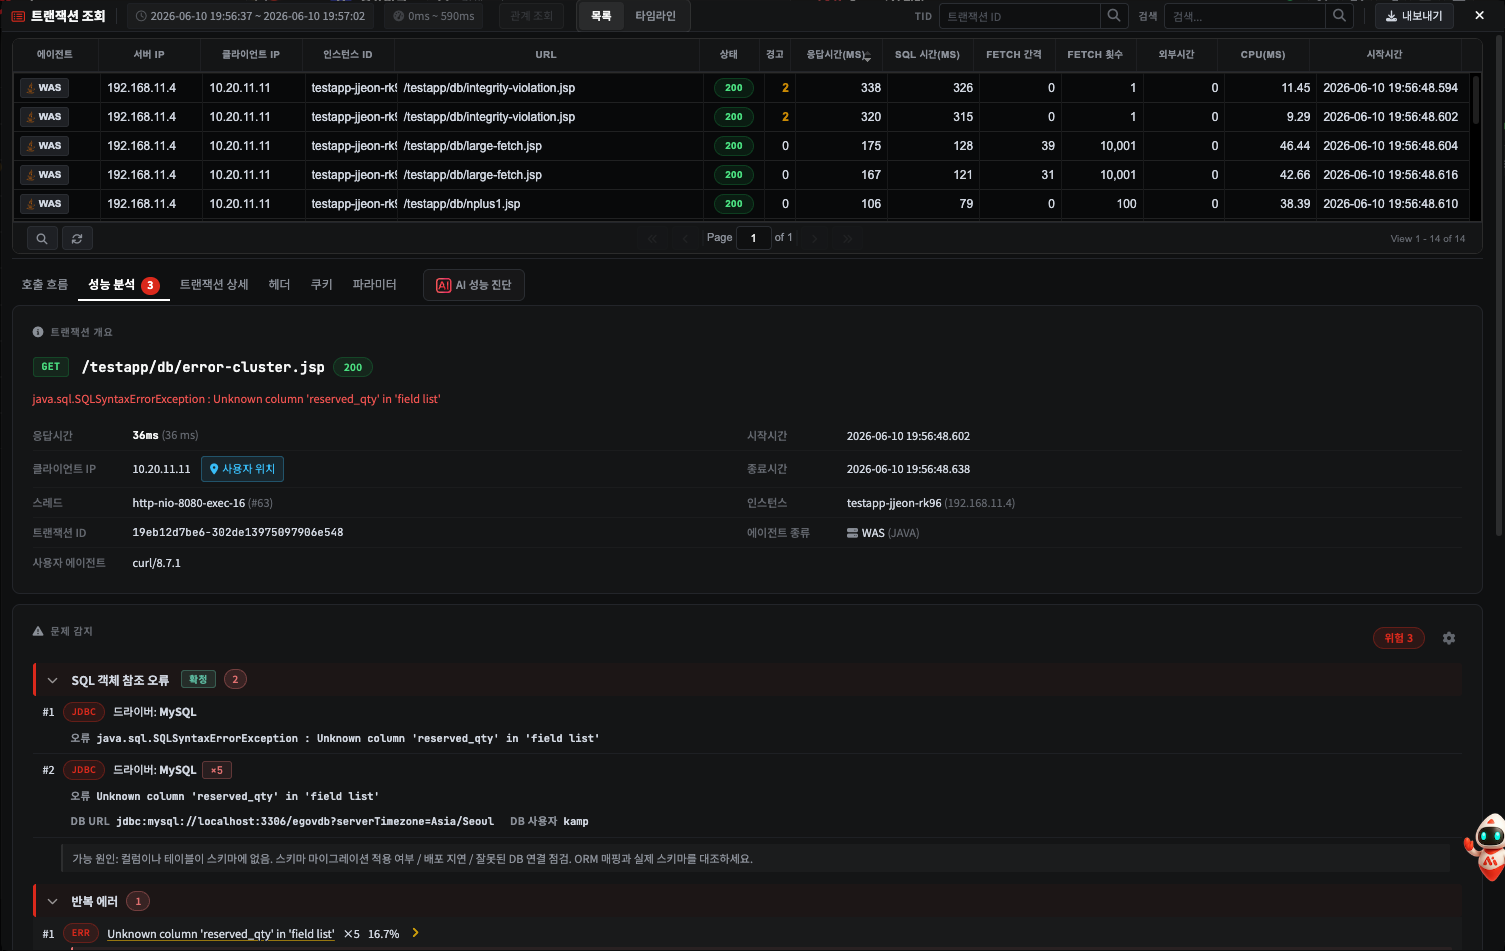
- 원인 — 스키마 마이그레이션 누락(가장 흔함) / 잘못된 DB에 연결(staging↔prod) / 이름 변경 후 ORM 매핑 미수정 / schema prefix 누락
- 조치 — 운영 DB의 실제 스키마(
SHOW TABLES,DESC)와 ORM 매핑을 대조 → 마이그레이션 누락이면 즉시 적용, 잘못된 연결이면 DataSource 설정 정정.
4. 데이터 무결성 위반
INSERT/UPDATE가 unique · FK · not-null · check 제약에 걸려 거부됐습니다 (SQLState 23*,
MySQL 1062 등).
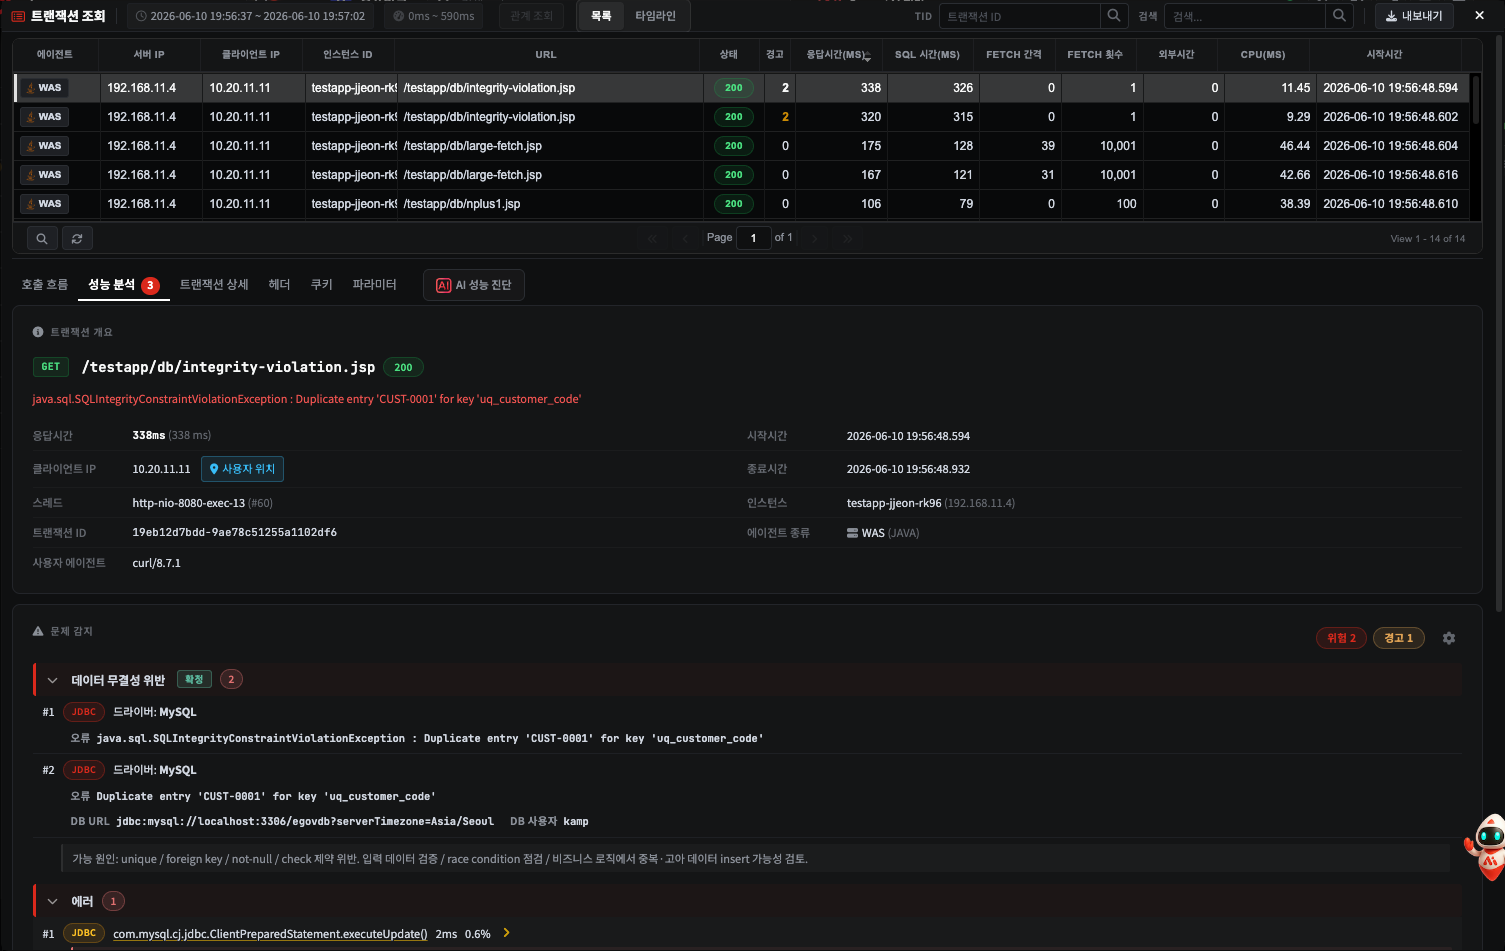
- 원인 — 중복 키 INSERT(이미 가입된 사용자 등 정상 케이스일 수도 있음) / 부모 없는 자식 INSERT / null 값 / 두 트랜잭션이 동시에 같은 키를 쓰는 race
- 조치 — 메시지의 제약 이름·컬럼으로 정상 케이스인지 버그인지 구분 → 정상 케이스면
사전 검증과 정중한 사용자 메시지, race 의심이면
INSERT ... ON CONFLICT(또는INSERT IGNORE)나 명시적 lock.
5. 에러
위 패턴에 해당하지 않는 일반 예외 또는 ERROR 로그입니다. span에 errorMessage가 있거나 로그 레벨이 ERROR/CRITICAL이면 표시됩니다.
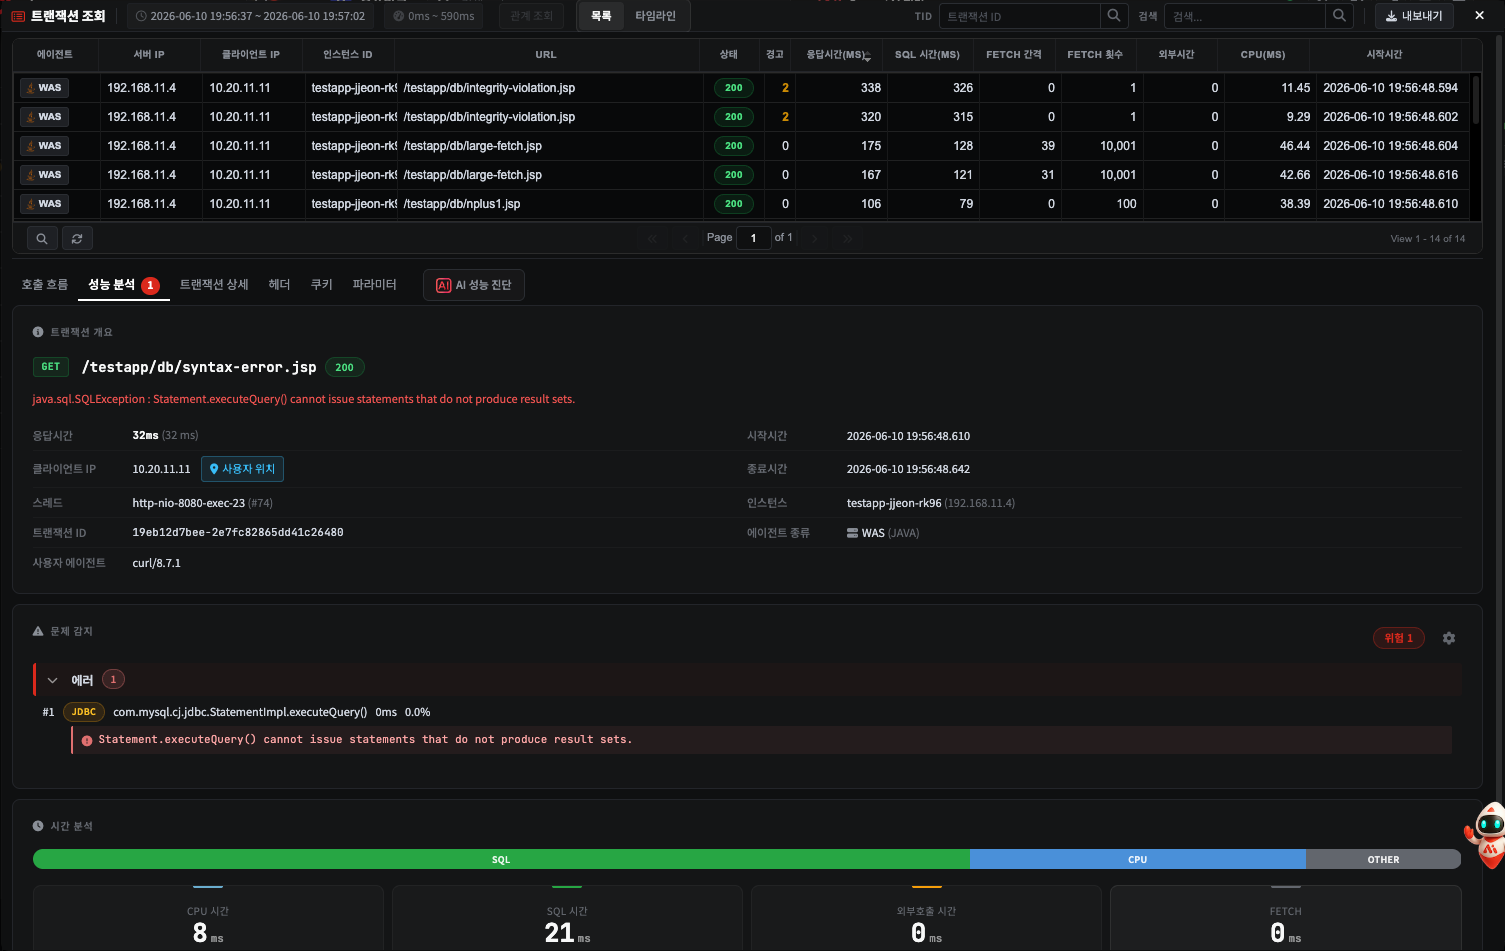
- 확인 — 카드를 클릭해 호출 흐름 탭에서 해당 span의 stack trace·SQL·파라미터를 봅니다. 같은 에러가 반복되면 패턴 6(반복 에러)으로도 묶입니다.
- 조치 — errorMessage와 파라미터로 재현 → 빈 결과/null 처리 같은 로직 확인. 배포 직후면 회귀 의심, 필요 시 rollback.
6. 반복 에러
같은 에러(예외 클래스 + 정규화된 메시지)가 한 트랜잭션 안에서 3회 이상 반복됐습니다.
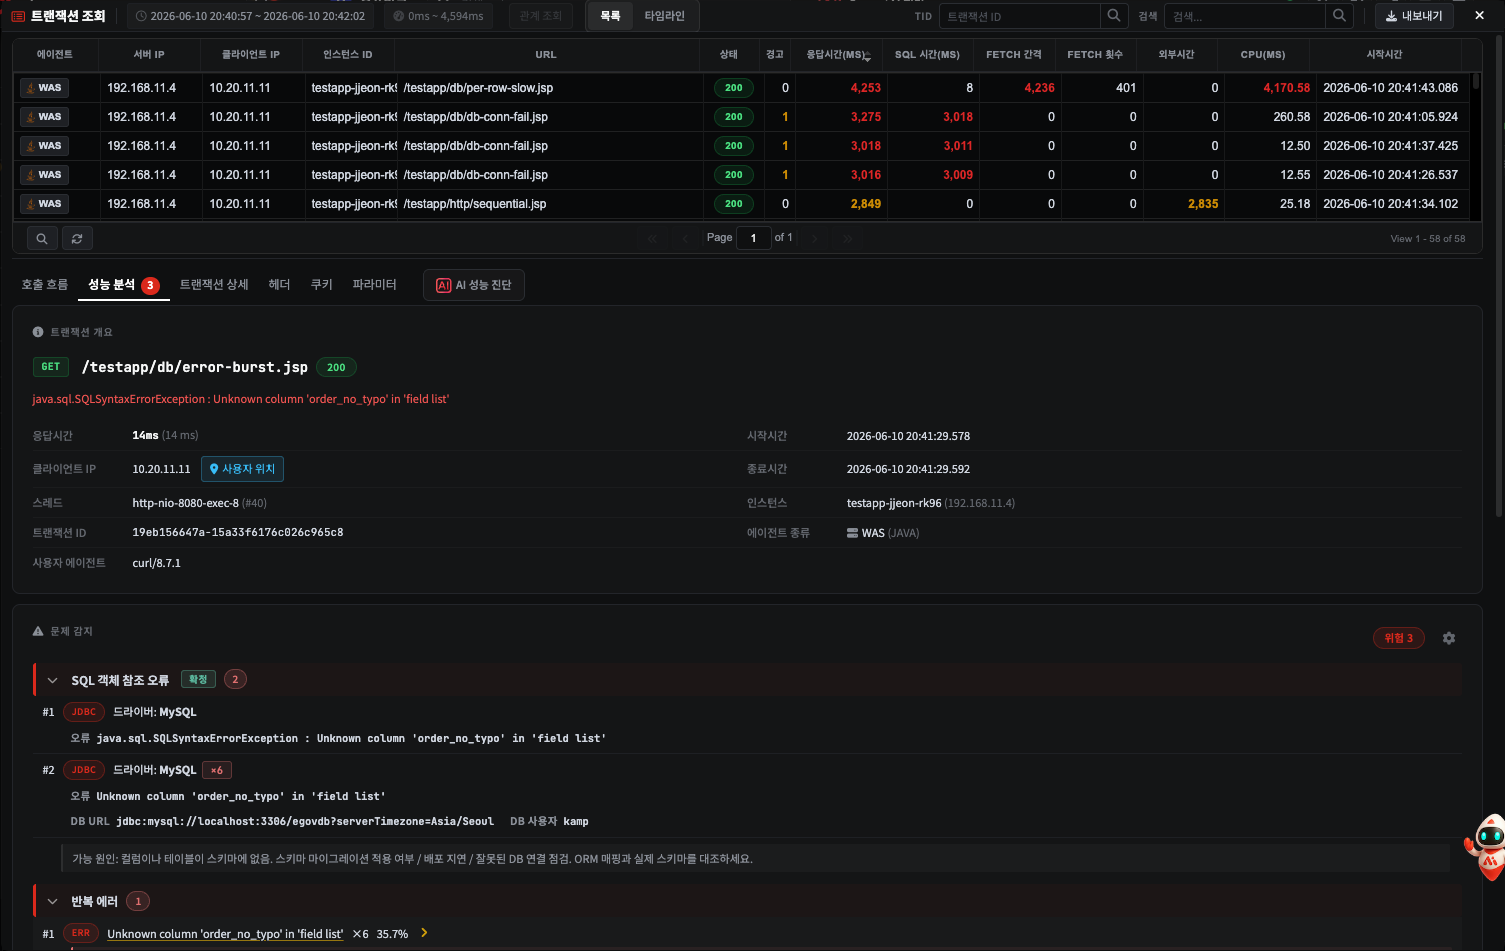
- 원인 — downstream 서비스 일시 장애 / retry 로직이 같은 오류로 N회 시도(retry storm) / 순회 중 같은 데이터에서 반복 실패
- 조치 — downstream 정상화가 우선 → retry에 backoff·circuit breaker 적용 → 재시도가 의미 없는 오류(validation 등)는 retry 대상에서 제외.
7. Connection Pool 대기
SQL 실행 자체는 빠른데 풀에서 커넥션을 빌리기까지(getConnection()) 오래 걸렸습니다.
겉보기엔 "SQL이 느리다"처럼 보이지만 실제로는 DB는 한가하고 애플리케이션이 커넥션 부족으로
줄을 서는, 놓치기 쉬운 패턴입니다. 가장 오래 기다린 getConnection 류 span이 100ms 이상이거나 대기 시간의 합이 200ms
이상이면 표시됩니다 (Tomcat JDBC · HikariCP · DBCP · C3P0 · Oracle UCP · JBoss/WildFly ·
WebLogic · WebSphere 등 지원). 주의와 심각을 나누지는 않습니다 — 뜨거나 뜨지 않거나입니다.
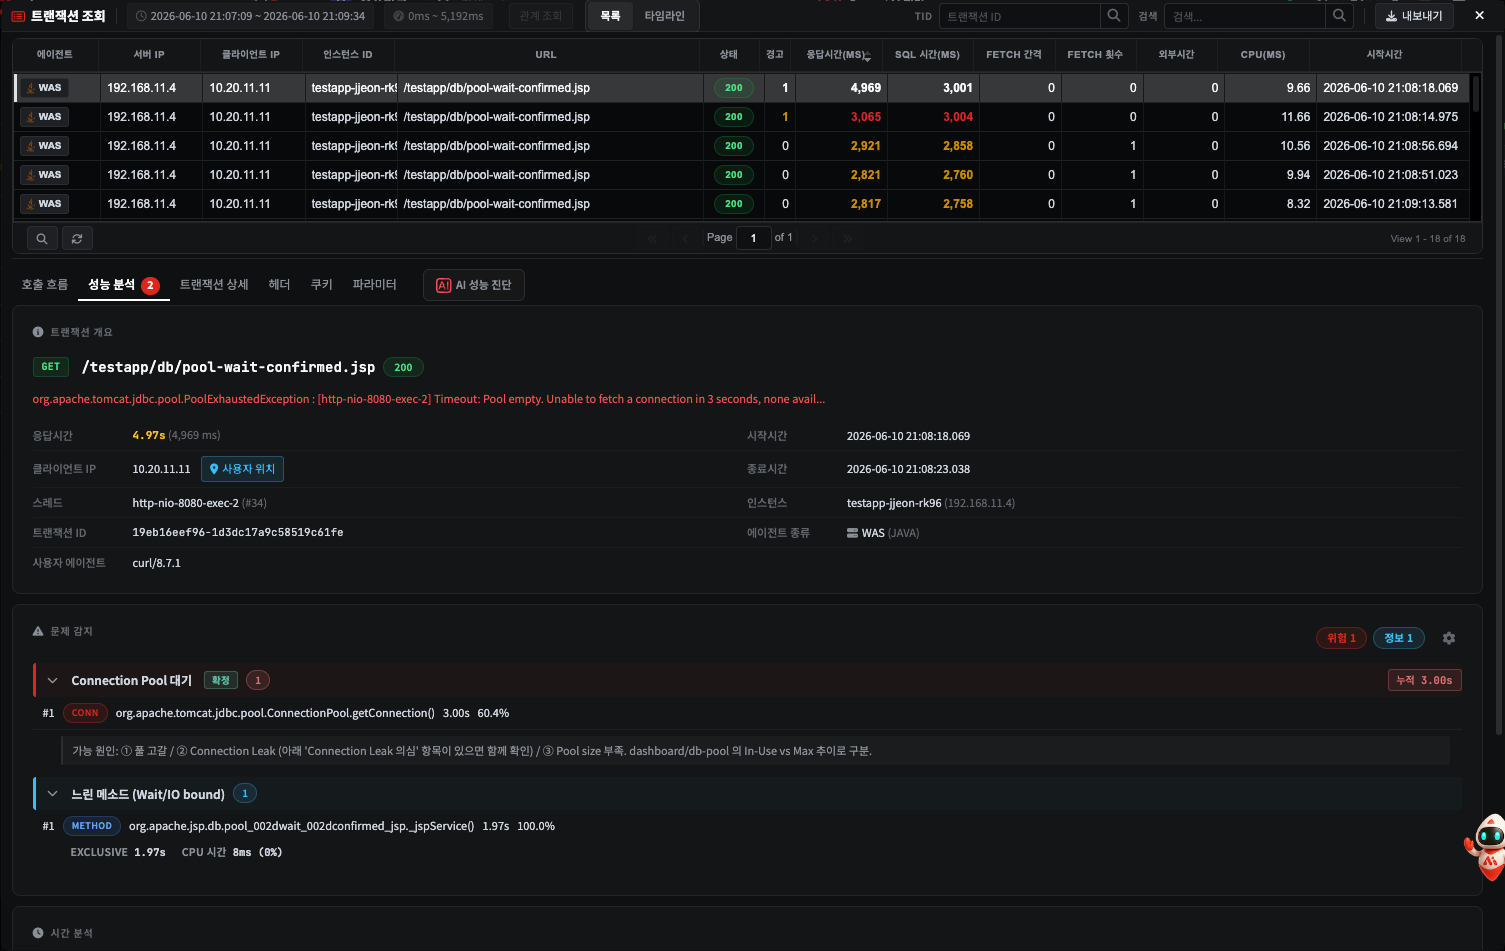
카드에서 바로 보는 풀 사용량 — 카드 머리줄 오른쪽에 그 시각의 풀 사용량이 표시됩니다.
| 표시 | 뜻 |
|---|---|
풀 사용량 <풀 이름> 사용 중 N / 최대 M | 트랜잭션 시각이 들어 있는 5초 구간에서 그 인스턴스 풀의 사용 중 연결 수와 최대 풀 크기 |
| 풀 고갈 (경고 색) | 사용 중이 최대에 닿았습니다(N ≥ M) |
| 풀 여유 | 사용 중이 최대보다 작습니다. 풀에 여유가 있는데도 기다렸다면 새 연결 생성이나 연결 검사 쿼리 쪽을 봅니다 |
| 차트 보기 → | 트랜잭션 상세 창을 닫고 WAS ▸ 데이터소스 화면의 풀 수 탭을 엽니다. 같은 인스턴스·같은 풀, 트랜잭션 앞뒤 5분 구간이 조회 모드로 열립니다 |
- 데이터소스(풀)가 여럿이면 사용 비율(사용 중 / 최대)이 가장 높은 풀 하나만 보입니다.
- 이 값은 그 시각 그 인스턴스의 풀 사용량입니다. 트랜잭션이 어느 풀에서 기다렸는지는
알 수 없습니다 —
getConnection기록에 풀 이름이 남지 않기 때문입니다. - 그 시각의 지표가 없으면 풀 사용량과 차트 보기가 함께 표시되지 않습니다. 예: 에이전트 기동 직후, 풀 정보를 수집하지 못하는 환경, 원본 지표 보관 기간이 지난 오래된 트랜잭션. 1시간 단위로 합친 값은 평균이라 짧은 고갈이 드러나지 않으므로 대신 쓰지 않습니다.
카드의 가능 원인 — 카드 아래 가능 원인 목록은 풀 사용량에 따라 둘로 나뉩니다.
-
풀이 가득 참 → 작은 풀 크기 / 닫지 않은 연결(커넥션 누수,
close()누락 — 패턴 19와 함께 발생) / 긴 연결 사용(느린 SQL, 긴 트랜잭션, 커넥션을 쥔 채 외부 호출·무거운 연산) -
풀에 여유 있음 → 새 연결 생성 지연(여유 연결이 없어 DB에 새로 접속) / 연결 검사 쿼리 (
testOnBorrow가 켜져 있으면 연결을 빌릴 때마다 검사 쿼리 시간이 더해짐) -
구분 방법 → 위 풀 사용량, WAS ▸ 데이터소스의 사용 중 / 최대 추이
-
확인 — 먼저 카드의 풀 사용량을 보고, 차트 보기로 데이터소스 풀 차트를 열어 사용 중(Active/InUse)이 최대(Max)에 닿아 있는지 앞뒤 추이를 봅니다. 닿아 있으면 고갈 확정입니다 — 진단 절차는 H8. DB 커넥션 풀 고갈 진단에 있습니다.
-
조치 — 풀이 가득 찬 경우 즉시: maxActive 임시 증설로 영향 최소화. 근본: try-with-resources / Spring
JdbcTemplate같은 자동 close 패턴 적용, Tomcat JDBC라면removeAbandoned=true+logAbandoned=true로 누수 지점 추적. 풀에 여유가 있는 경우: DB 접속 시간과 데이터소스의 연결 검사 설정(testOnBorrow)을 점검합니다.
참고 agent가 getConnection을 계측하지 않는 예외적 경로(raw
DriverManager직접 호출 등)에서는 같은 현상이 "부모 메소드 시작 → 첫 SQL 시작 gap" 기반의 (Suspected) 카드로 추정 표시될 수 있습니다. 풀(DataSource)을 거치는 일반 환경에서는 항상 이 확정 카드로 잡힙니다. 풀 사용량과 차트 보기는 확정 카드에만 표시됩니다.
8. DB Lock 대기
SQL 실행이 비정상적으로 길고 lock 관련 신호가 보입니다 — 에러 메시지에 lock wait timeout /
deadlock이 있거나, SELECT ... FOR UPDATE 같은 명시적 lock 구문이 1초 이상 걸린 경우.
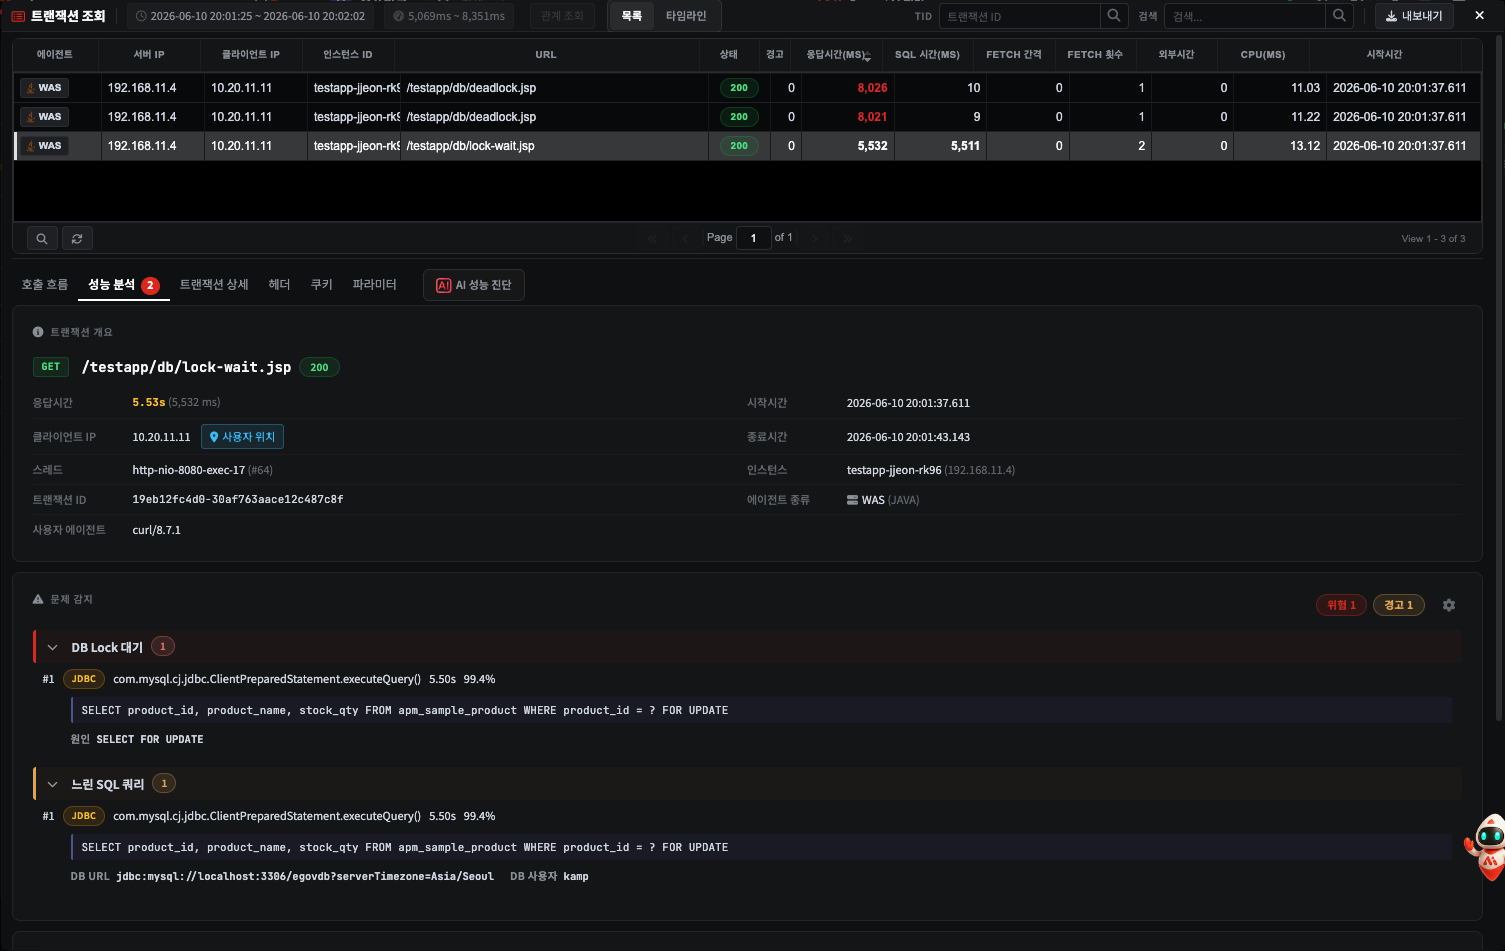
- 원인 — 다른 long transaction이 같은 row를 점유 / 두 경로의 lock 순서가 달라
deadlock / 인덱스 부재로 lock 범위가 row → range로 확장 /
FOR UPDATE후 무거운 로직 - 조치 — 즉시: DBA와 함께 lock holder 트랜잭션을 찾아 종료. 근본:
@Transactional범위 최소화, lock 순서 통일(예: id 오름차순), optimistic lock(@Version) 검토, 인덱스 추가로 range lock 회피. DBMS 대시보드의 Lock/Wait 이벤트와 교차 확인하세요.
Tier 2 — 주황: 깊이 확인
9. N+1 의심 쿼리
동일한 SQL이 수십~수백 번 반복 실행됐습니다 — ORM lazy loading의 전형적 안티패턴입니다. 같은(정규화된) SQL이 5회 이상 반복되고, 그 앞에 반복 횟수만큼의 행을 읽은 목록 조회가 확인되면 이 카드로 들어옵니다. 같은 부모 메소드 안인지는 보지 않고 트랜잭션 전체에서 셉니다. 누적 시간은 판정에 쓰지 않습니다 — 그 기준은 10번(누적 핫스팟)입니다.
목록 조회를 찾지 못했으면 20번(N개 반복 쿼리)으로 갑니다. 확인된 사실만 N+1 이라고 부르기 위해 나눠 두었습니다.
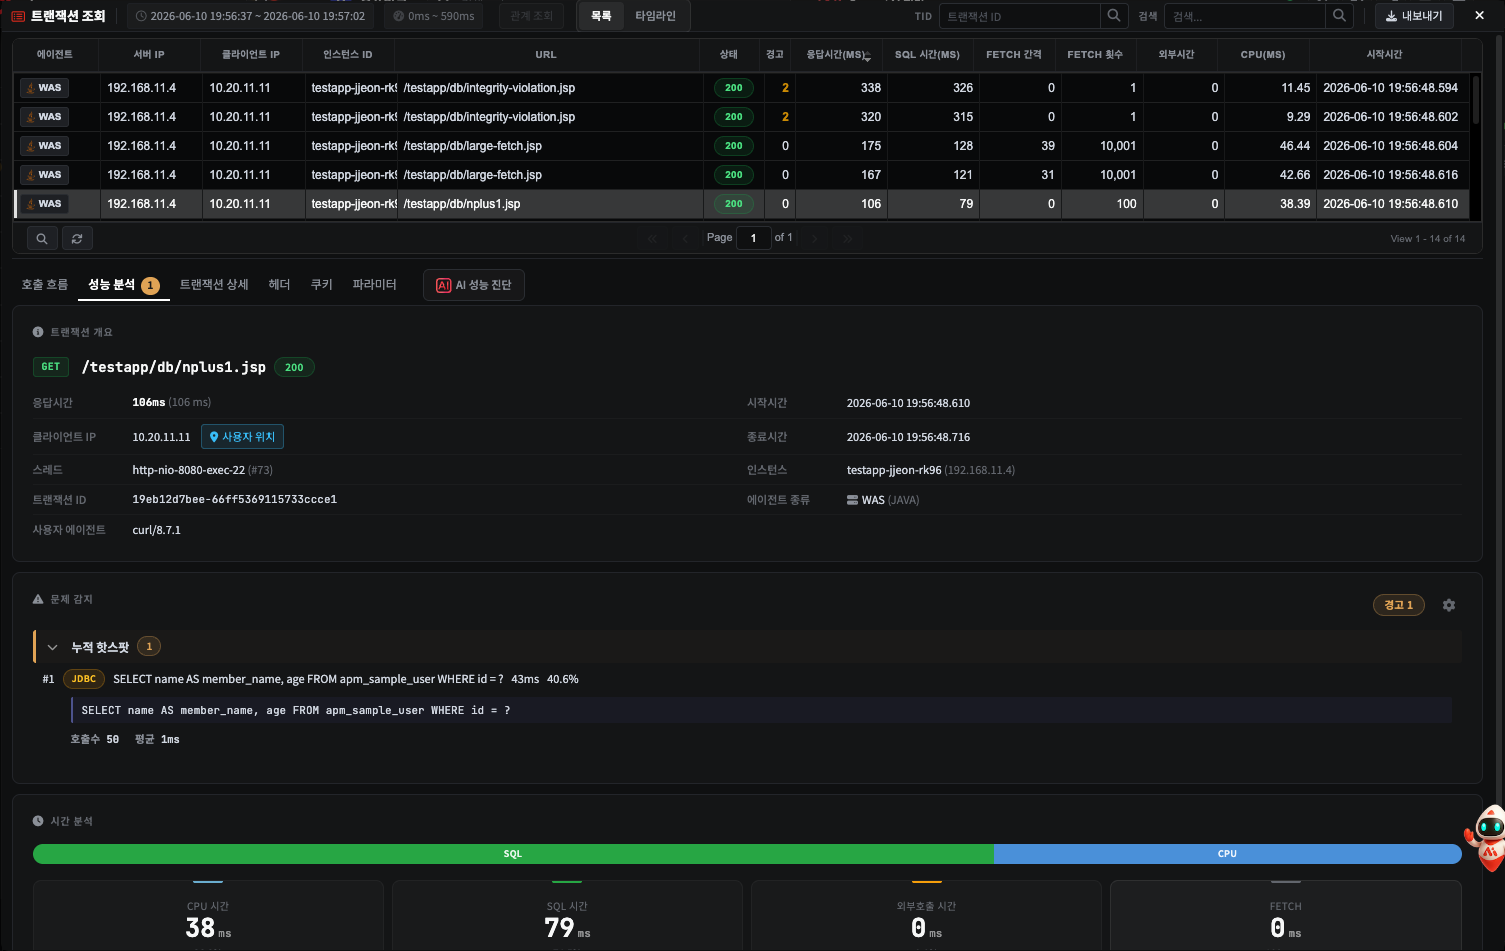
카드에 함께 나오는 근거 — 반복된 SQL 아래에 선행 조회 줄로 앞선 목록 조회 SQL이 한 줄 표시되고, 항목 정보 줄에 선행 조회 행 수(그 목록 조회가 읽은 행 수)가 표시됩니다. 반복 횟수와 선행 조회 행 수가 같으면 "목록 한 번 + 행마다 한 번"의 N+1 모양입니다.
카드의 개선 방안 — SQL 반복 항목이 하나 이상 있으면 카드 아래에 개선 방안 목록이 붙습니다. (외부 호출(HTTP) 반복만 있는 카드에는 붙지 않습니다.)
-
목록 조회에 JOIN 을 추가해 한 번에 조회
-
목록의 ID 를 모아 IN 절로 한 번에 조회
-
ORM 사용 시 fetch join 또는 batch fetch size 설정
-
원인 — JPA
@OneToManylazy loading + 컬렉션 순회 / MyBatis 자식 entity 개별 select / 반복문 안 SQL 호출 -
조치 — JPA는
JOIN FETCH또는@EntityGraph(또는 batch fetch size), MyBatis는<collection>join 쿼리, 응급으로는 ID를 모아WHERE id IN (...)일괄 조회.
참고 파라미터만 다른 쿼리는 자동으로 정규화돼 묶입니다 (
WHERE id = 123→WHERE id = ?, IN 리스트 압축). 외부 URL도/users/123→/users/{id}로 묶입니다.
10. 누적 핫스팟
개별 호출은 빠르지만 같은 SQL이나 외부 API가 여러 번 호출돼 누적 시간이 큽니다. 호출 수가 5회 미만이면서 누적이 1초를 넘거나 트랜잭션 응답시간의 30% 이상이면 표시됩니다. 5회 이상 반복은 9번 또는 20번이 맡습니다.
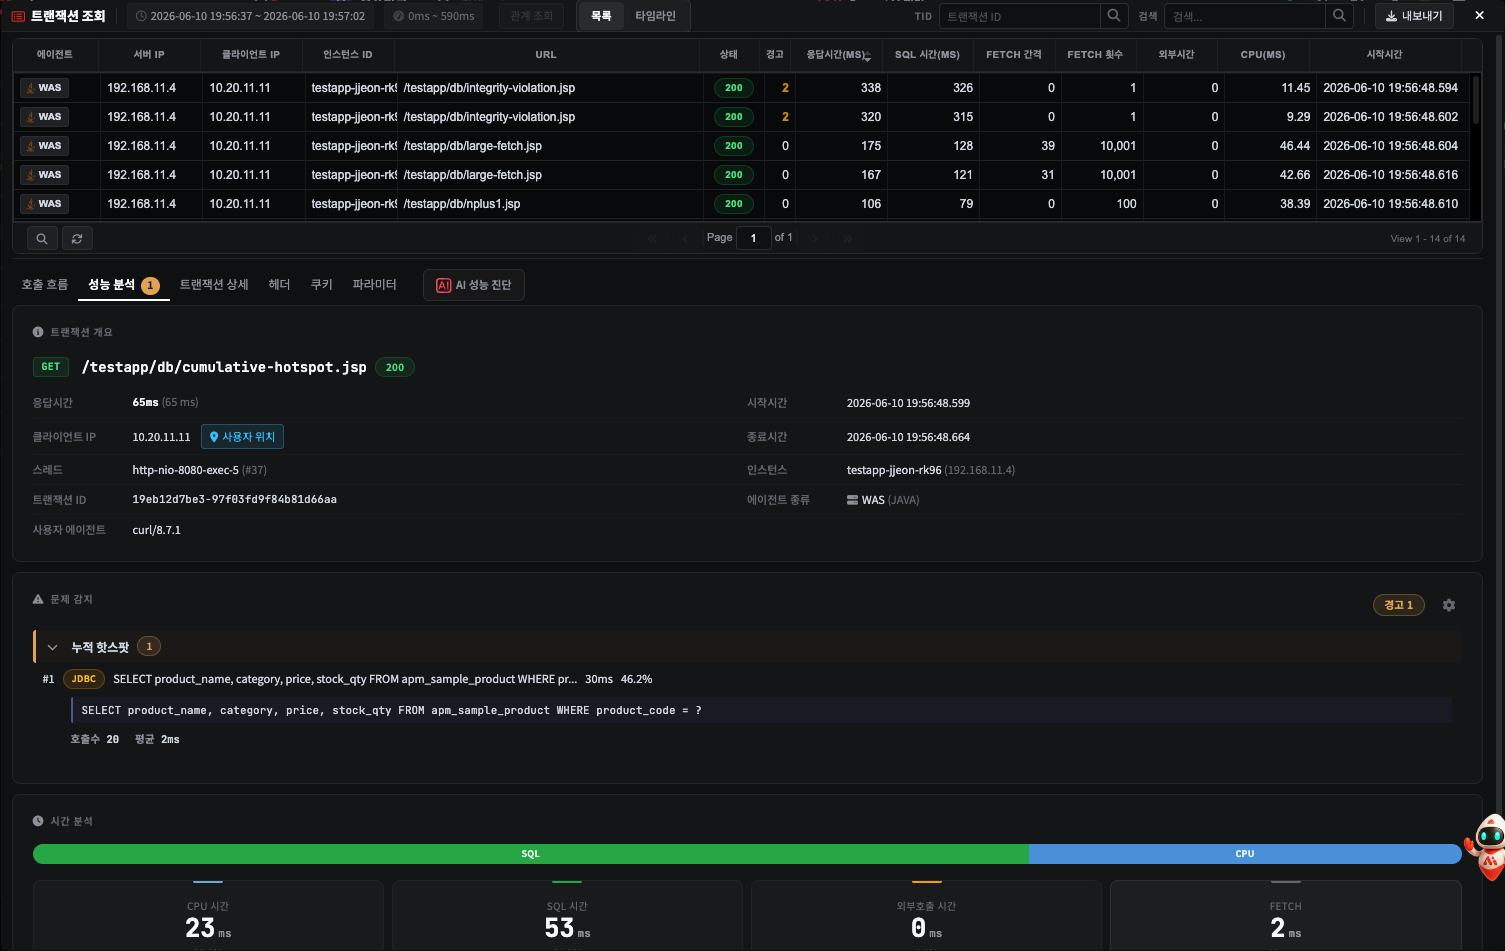
- 원인 — 매 호출마다 인증·권한 검증 / 캐시 가능한 조회를 매번 DB·외부에서 / 같은 리소스의 중복 fetch
- 조치 — 로컬 캐시(Caffeine 등, 짧은 TTL) → 분산 캐시(Redis) → batch API 순으로 검토.
11. 느린 SQL 쿼리
단일 SQL 한 건이 100ms를 초과했습니다. 가장 전통적인 DB 튜닝 대상입니다.
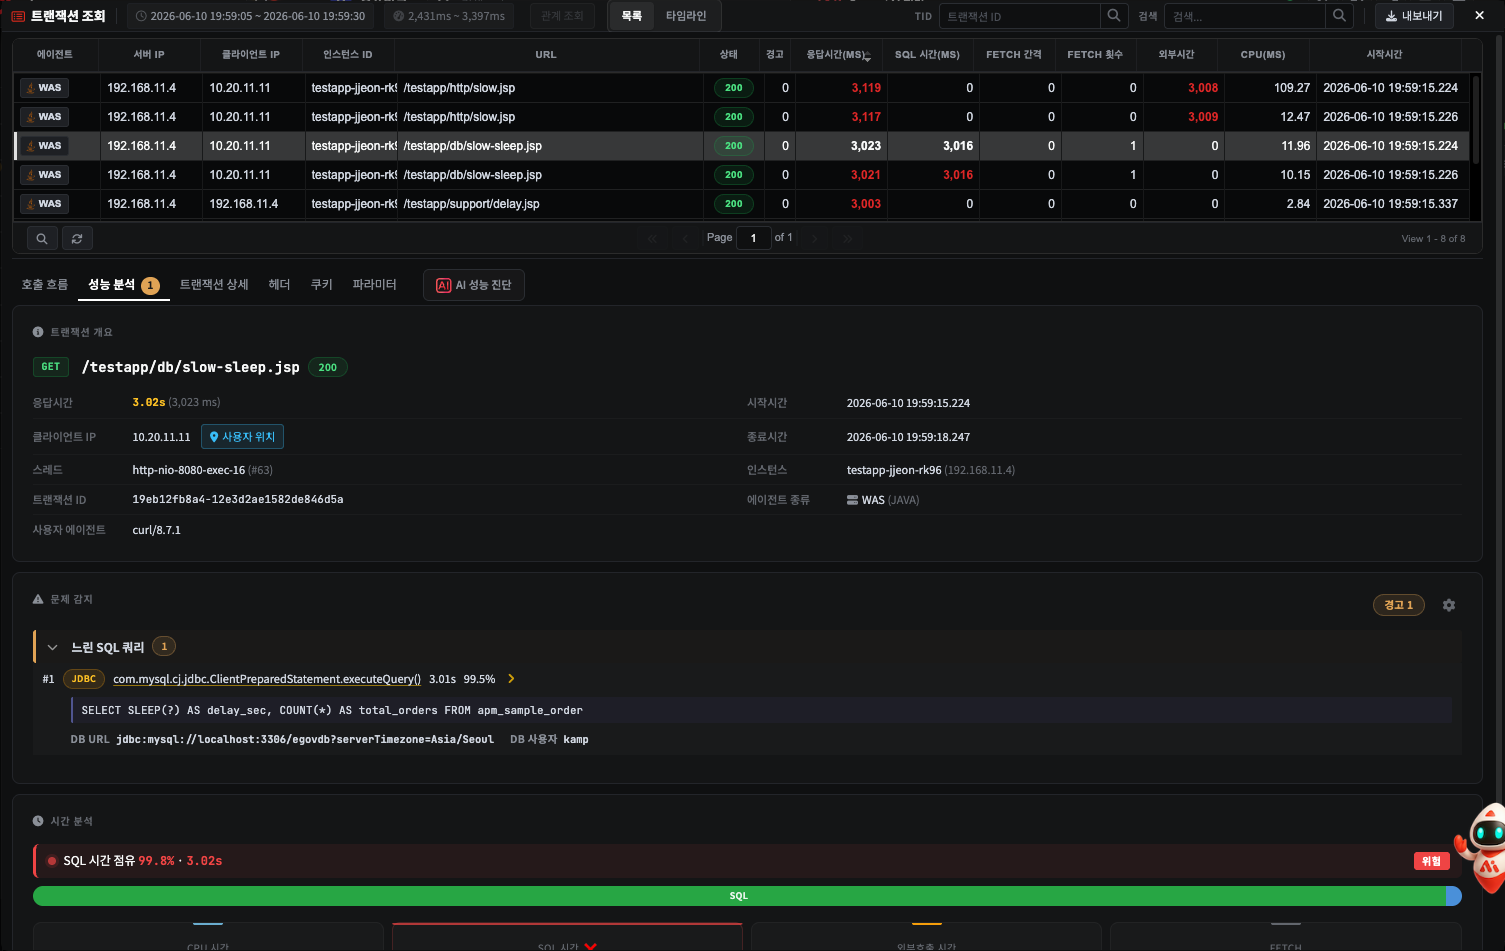
- 원인 — 인덱스 부재·미사용 / 잘못된 실행계획(table scan) / 통계 오래됨 / JOIN 순서 비효율
- 조치 — 해당 SQL을
EXPLAIN으로 분석해 인덱스를 보완합니다. 워터폴에서 그 SQL의 [SQL] 버튼을 누르면 AI 쿼리 진단이 실행계획·인덱스까지 분석해 줍니다 — T3. AI로 원인 분석하기.
12. 느린 외부 호출
단일 외부 HTTP/RPC/gRPC 호출 한 건이 200ms를 초과했습니다 — 외부 서비스 자체가 느린 경우입니다.
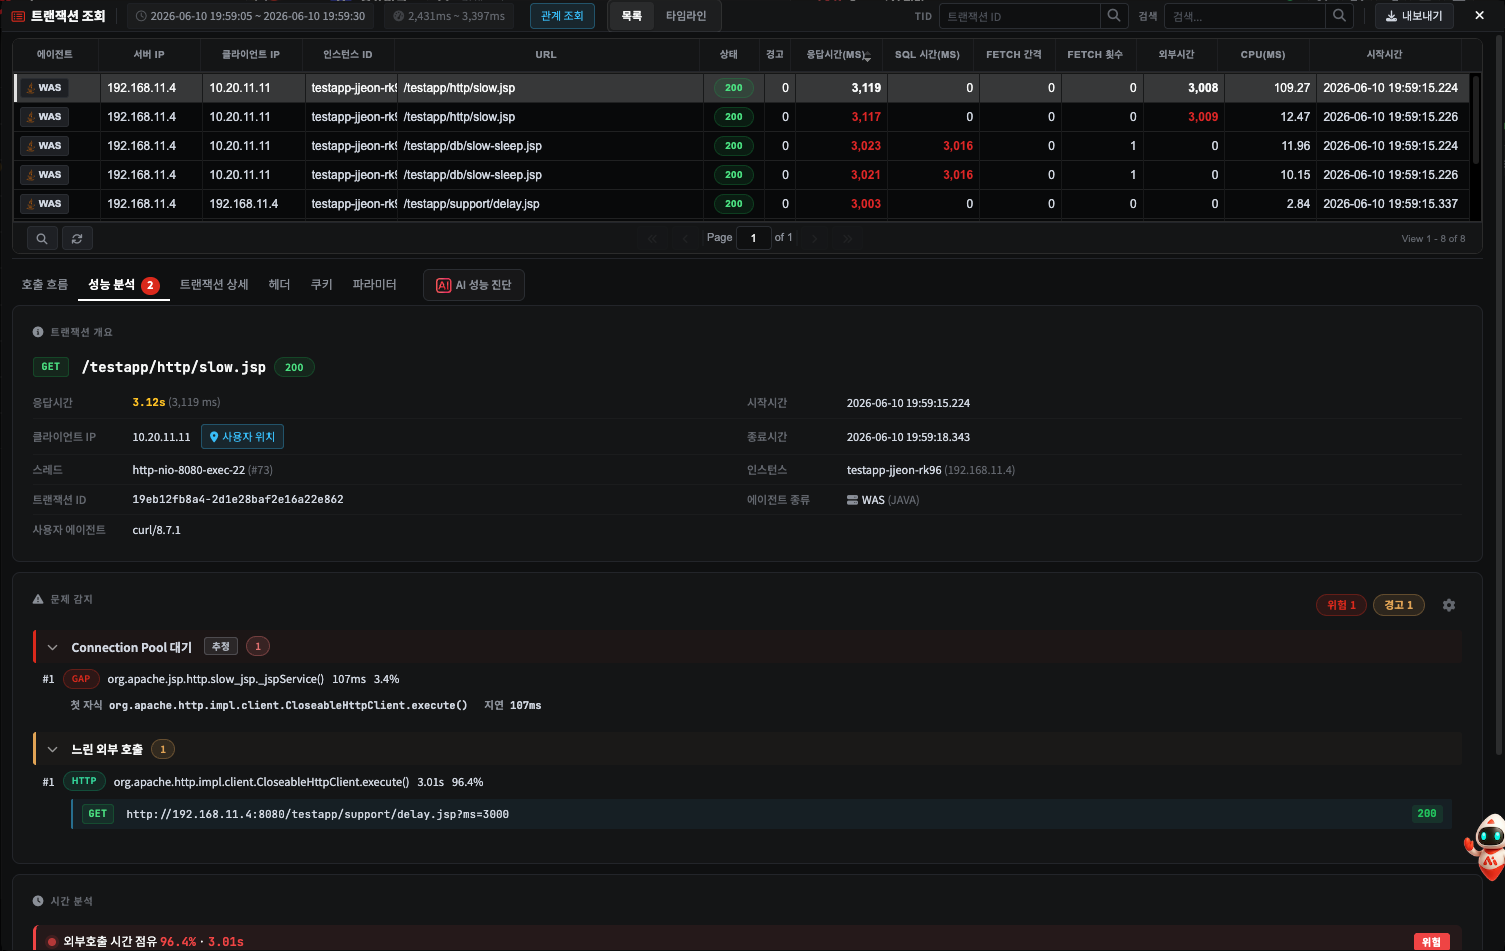
- 원인 — 외부 서비스 성능 저하 / 그쪽 downstream 문제 / 네트워크 지연 / 커넥션 재사용 안 됨(SSL handshake·DNS 반복)
- 조치 — timeout 설정으로 무한 대기 차단 → circuit breaker(Resilience4j 등) → 응답 캐싱 → HTTP client connection pooling. 반복되면 외부 서비스와 SLA를 협의하세요.
구분 패턴 10(누적 핫스팟)은 개별은 빠른데 여러 번 호출, 패턴 13(깊은 chain)은 깊이· 호출 수가 많은 경우입니다. 이 패턴은 한 건 자체가 느린 경우 — 셋은 동시에 뜰 수 있습니다.
13. 깊은 외부 호출 chain
HTTP 호출이 다른 HTTP 호출을 연쇄로 트리거합니다 — microservice cascade 장애의 전조입니다. chain 깊이 3 이상이거나 한 트랜잭션의 외부 호출이 10개 이상이면 표시됩니다.
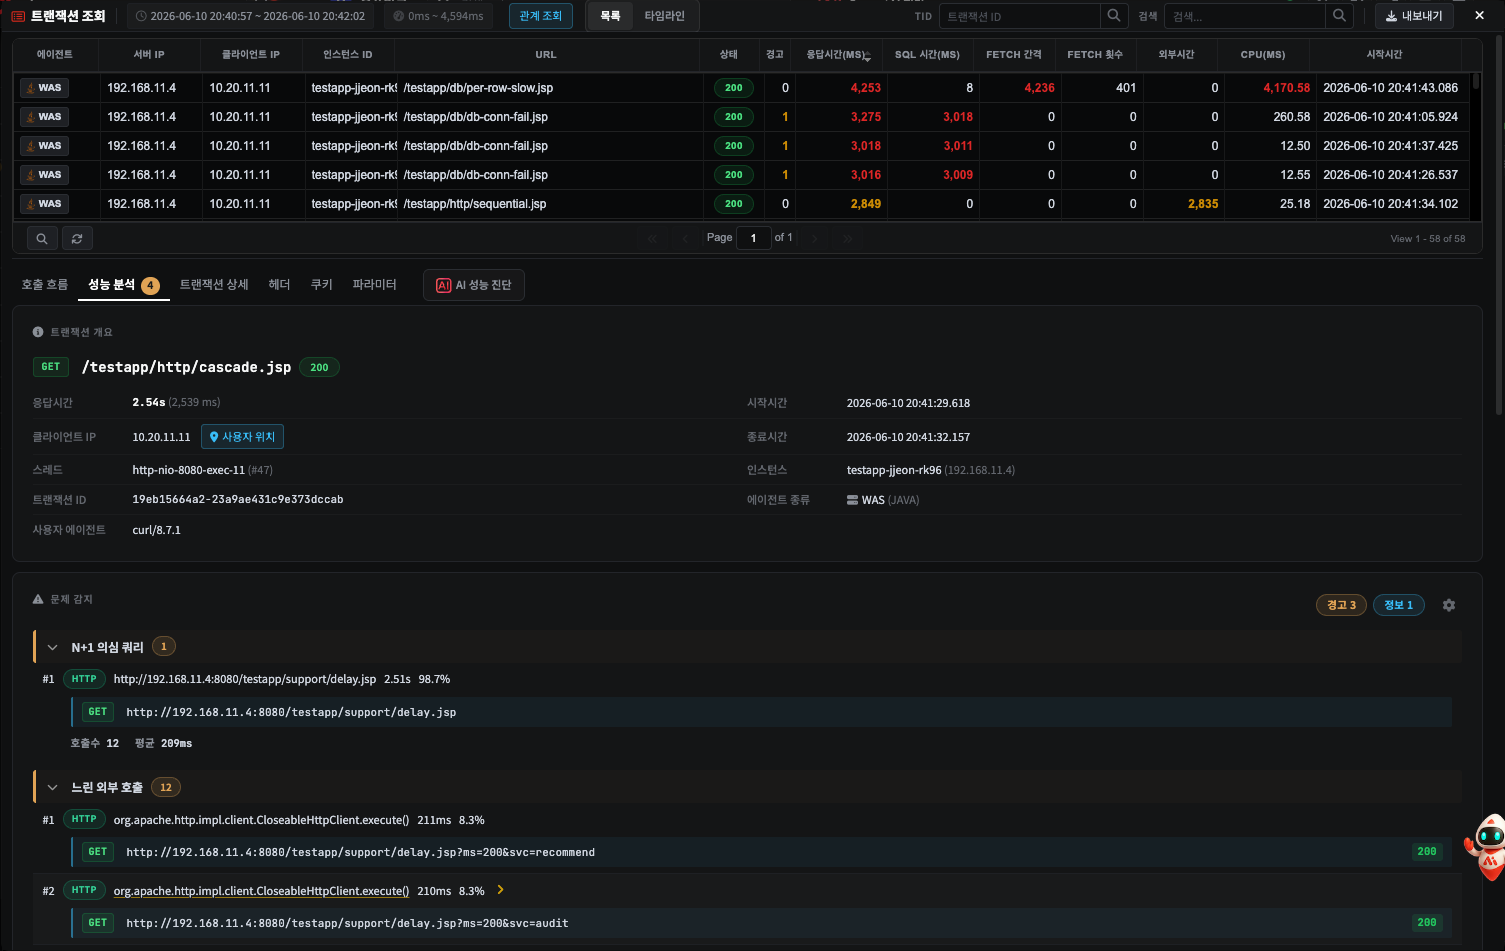
- 원인 — 서비스 경계가 너무 세밀 / cross-service 호출이 동기(
@FeignClientchain) / 같은 정보를 여러 서비스가 중복 조회 - 조치 — gateway가 병렬 호출 + 응답 조합(BFF 패턴) → 의존성 없는 호출은
CompletableFuture로 병렬화 → 각 단계에 timeout + circuit breaker. chain의 한 서비스만 죽어도 전체가 실패합니다.
20. N개 반복 쿼리
같은 질의가 5회 이상 반복됐지만, 그 앞에 반복 횟수만큼의 행을 읽은 목록 조회가 보이지 않습니다. 목록 조회 없이 같은 조회를 되풀이한 경우, 넣기·고치기·지우기(INSERT · UPDATE · DELETE)를 되풀이한 경우, 질의 종류나 앞선 조회를 판정할 수 없는 경우가 여기로 들어옵니다.
9번과 나눠 둔 이유는 카드 이름이 확인된 사실만 말하게 하기 위해서입니다. "같은 질의를 N번 실행했다"는 기록에 남은 사실이고, "그 앞에 목록 조회가 있었다"는 실행 순서와 행 수로 세운 추정입니다. 근거가 확인됐을 때만 N+1이라고 부릅니다.
- 원인 — 반복문 안에서 건별로 조회·저장 / 한 건씩 보내는 저장 / 같은 조회를 조건만 바꿔 되풀이
- 조치 — 식별자를 모아 한 번에 조회(
WHERE id IN (...))하거나, 여러 건을 묶어 한 번에 보내는 방식(executeBatch)으로 바꿉니다. 반복 자체가 필요한 로직이면 횟수를 줄일 수 있는지부터 봅니다.
카드 아래 개선 방안 목록은 반복 원인별 후보입니다. 카드에 나온 SQL 종류(조회·저장)에 맞춰 줄을 골라 주지는 않으므로, 반복된 SQL을 보고 맞는 줄을 고릅니다.
- 값만 바뀌는 조회 → IN 절로 한 번에 조회
- 같은 값 반복 조회 → 결과 캐시
- INSERT·UPDATE·DELETE 반복 → JDBC Batch
참고 외부 호출(HTTP) 반복은 이 카드로 나뉘지 않고 9번에 그대로 남습니다. 목록 조회에 해당하는 개념이 없기 때문입니다.
Tier 3 — 회색·파랑: 분석 정보
14. 느린 메소드 (CPU bound / Wait·IO bound)
SQL·HTTP가 아닌 일반 메소드 자체가 오래 걸렸습니다. CPU 사용 비율로 자동 분류되며, 두 경우는 해결 방법이 정반대라 라벨을 꼭 확인하세요.
| 라벨 | 판정 | 의미 → 조치 방향 |
|---|---|---|
| CPU bound | CPU 비율 ≥ 70% | 실제 연산이 무거움 → 알고리즘·직렬화·정규식 최적화, CPU 프로파일링 |
| Wait/IO bound | CPU 비율 < 10% | sleep · lock · blocking I/O 대기 → lock 영역 축소, I/O 비동기·캐시 |
| (혼재) | 그 외 | 양쪽 모두 점검 |
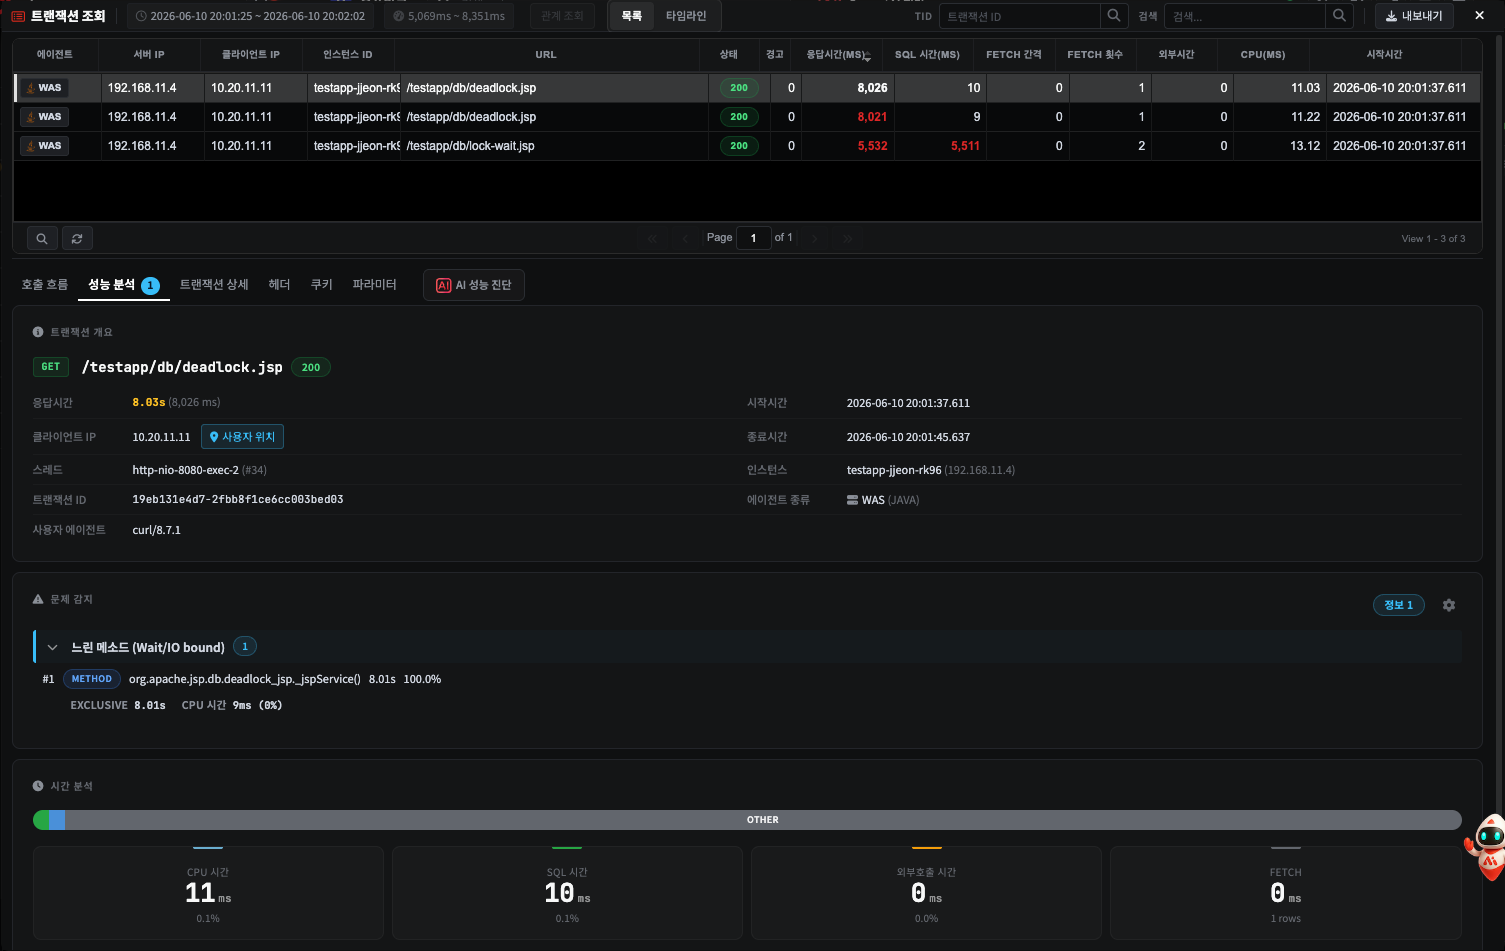
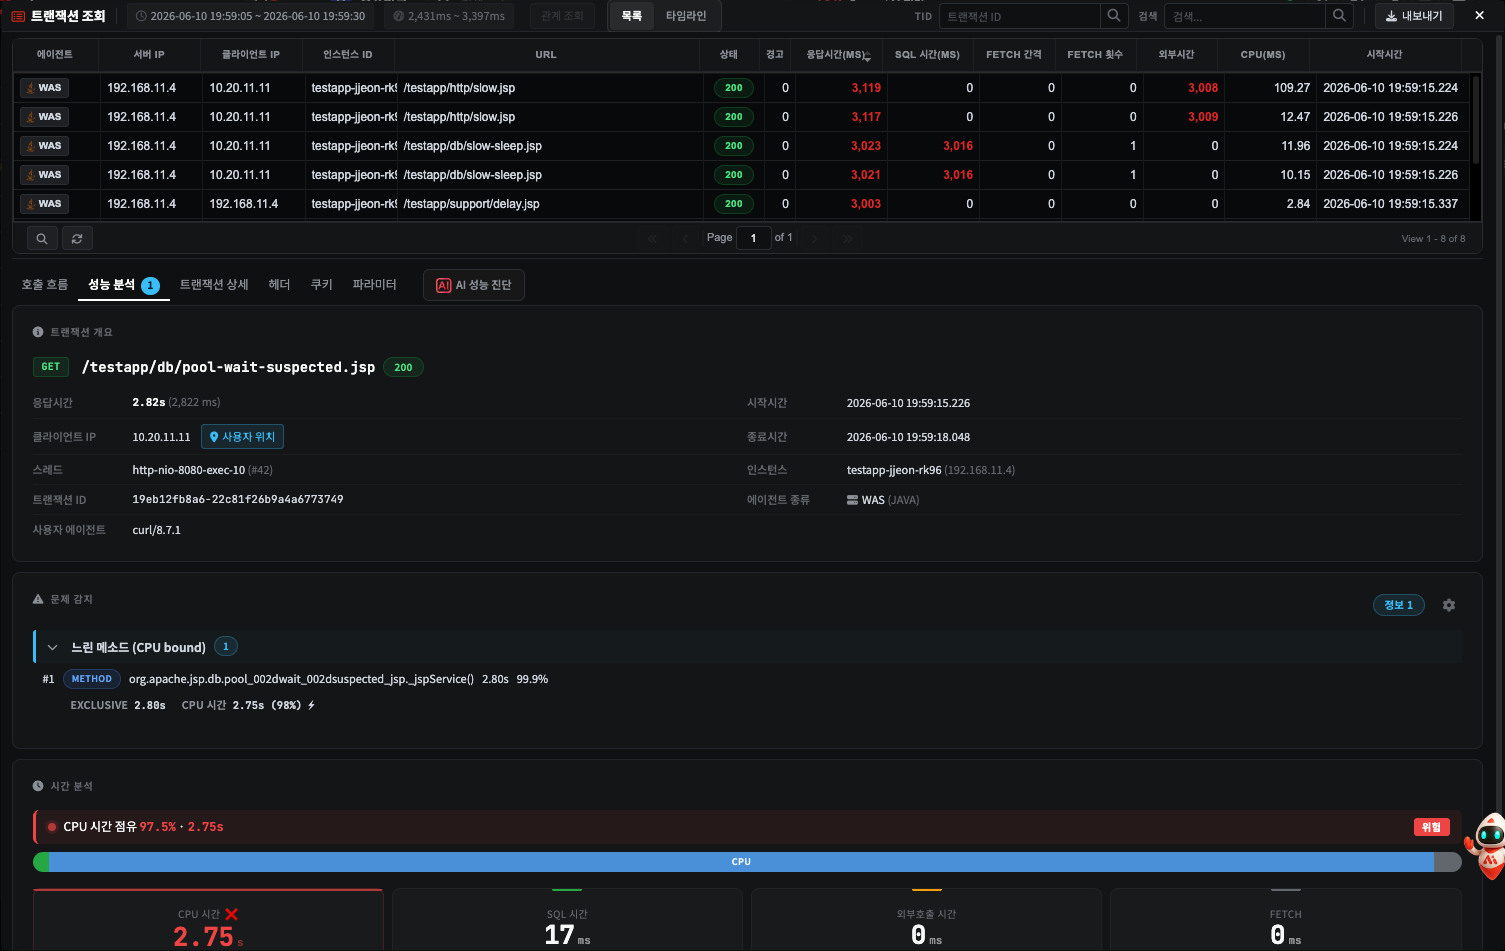
- 확인 — 호출 흐름에서 해당 메소드의 stack trace를 보거나 스레드 덤프로 BLOCKED/WAITING 상태를 확인합니다.
참고 한 트랜잭션에서는 분포에 따라 하나의 라벨만 표시됩니다 — CPU bound와 Wait/IO bound가 동시에 뜨지는 않습니다.
15. 대량의 데이터 Fetch
SQL 한 건이 매우 큰 결과셋을 반환했습니다 — 1,000행 이상이면서 행을 가져오는 시간(fetch)이 쿼리 실행 시간(execute)보다 큽니다.
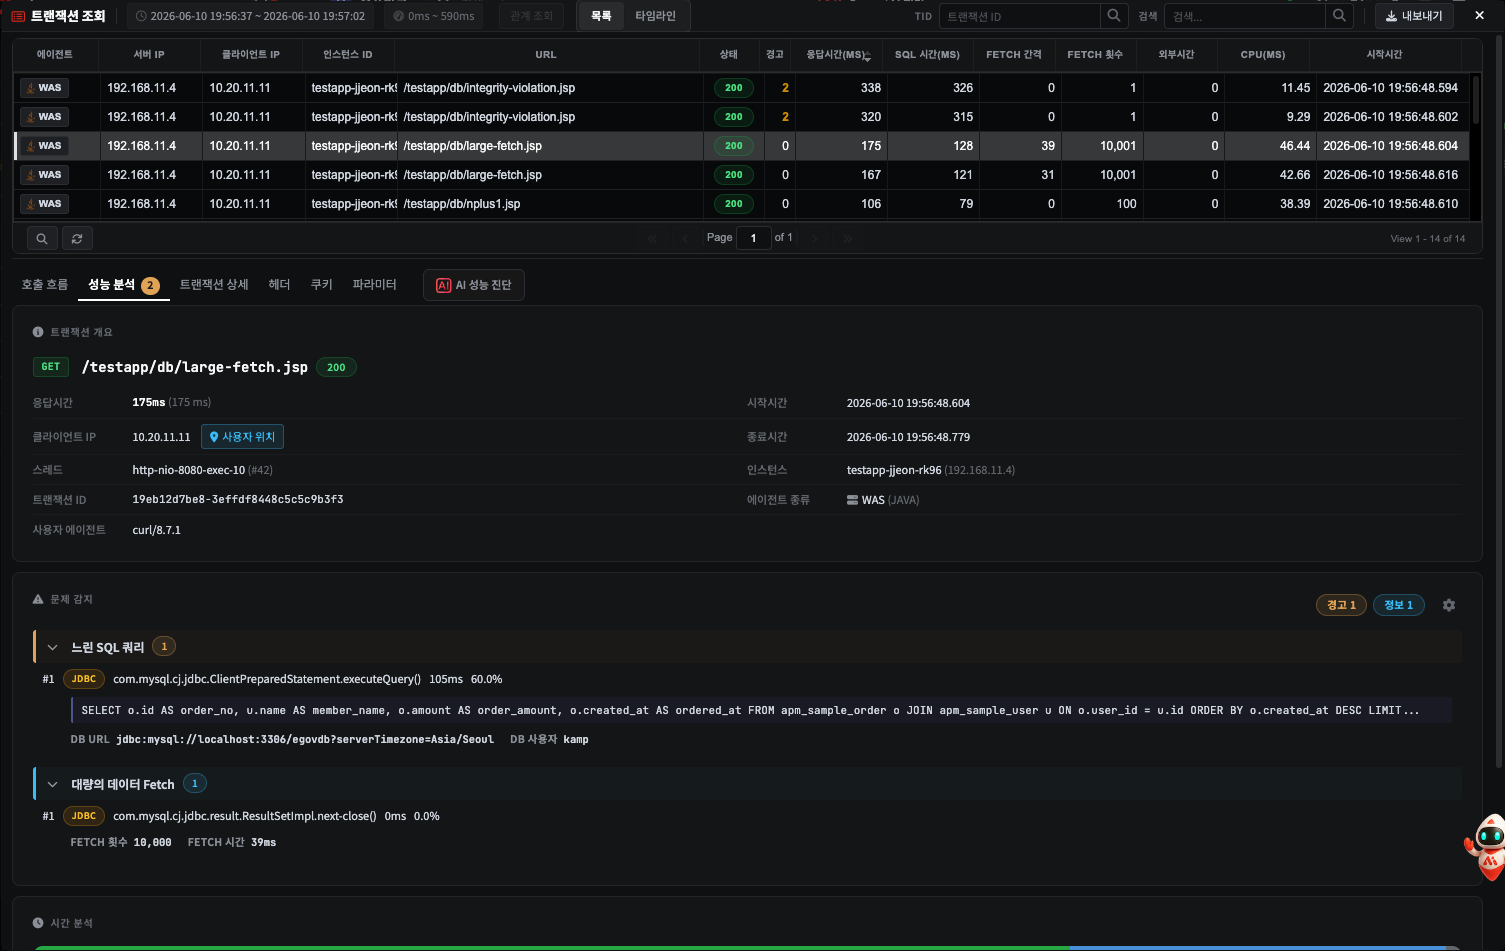
- 원인 — 페이징 누락 / JPA eager loading /
SELECT *(BLOB·큰 TEXT 포함) / 검색 조건 누락 - 조치 —
LIMIT/keyset 페이징 → 필요한 컬럼만 SELECT → 대량 export는 JDBCsetFetchSize+ cursor streaming 또는 비동기 파일 다운로드 전용 경로.
16. 느린 데이터 처리
행 수는 많지 않은데(1,000행 미만) 행 1개당 가져오는 시간이 1ms 이상으로 비정상적으로 큽니다 (정상은 0.01~0.1ms).
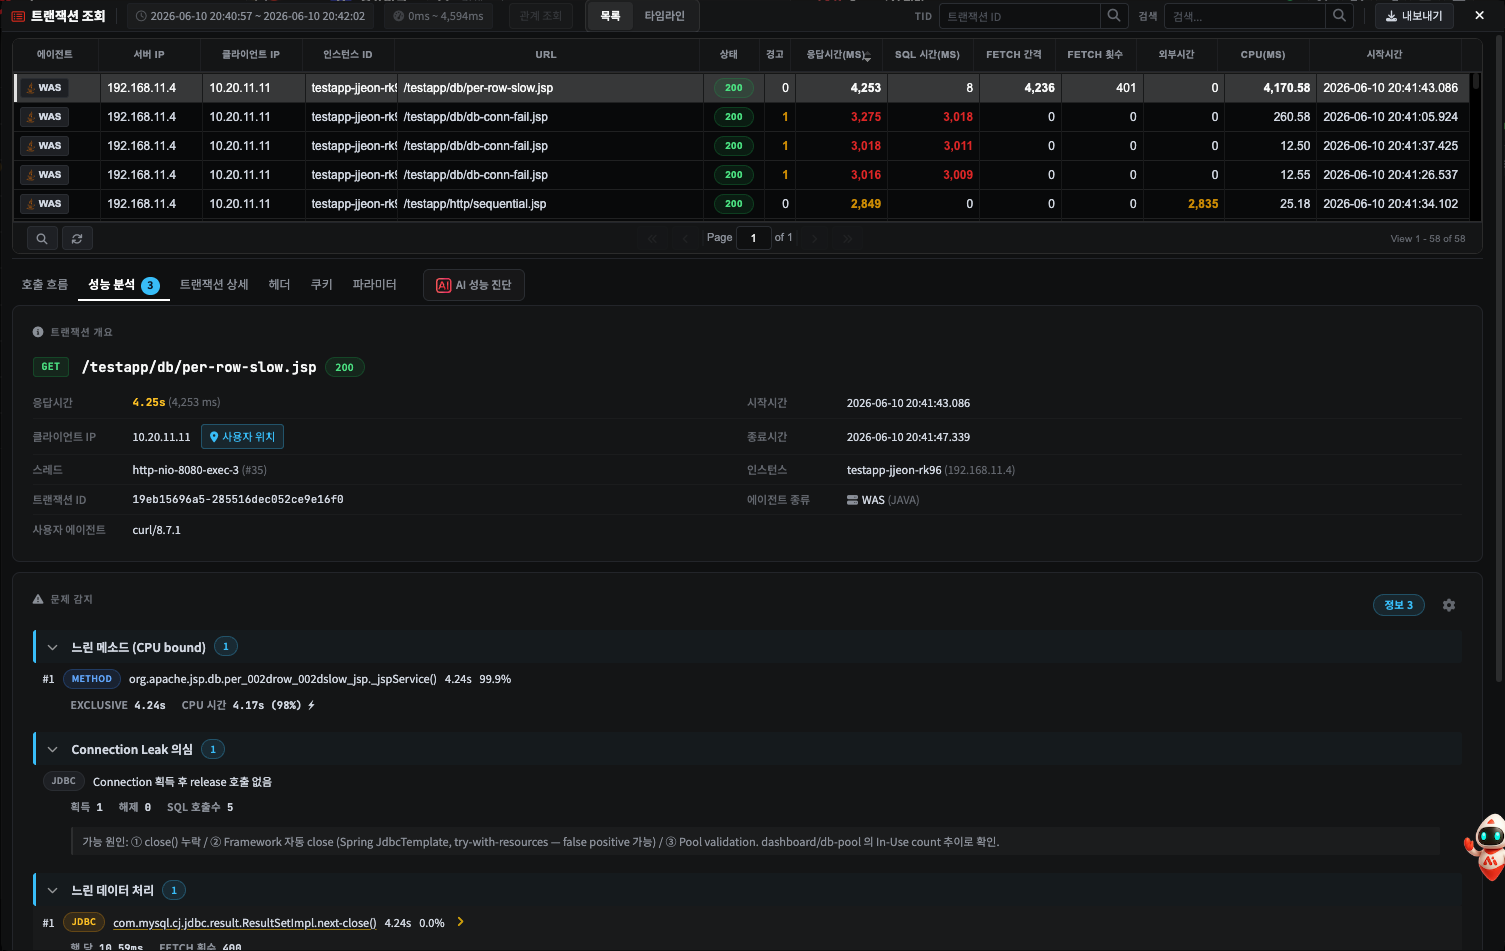
- 원인 — JDBC
fetchSize미설정(드라이버 기본 1이면 행마다 round-trip) / BLOB·CLOB 컬럼 / DB-WAS 네트워크 지연 - 조치 —
statement.setFetchSize(100)등 fetchSize 증가 → BLOB은 lazy fetch로 분리 → DB와 WAS를 같은 네트워크 구간에.
17. 외부 호출 직렬화
병렬로 처리될 것으로 기대한 외부 호출들이 실제로는 순차로 실행돼 시간이 합산됐습니다. 같은 부모 아래 외부 호출 3개 이상이 90% 이상 순차일 때 표시되며, 병렬화했을 때 절감 가능한 시간을 함께 보여 줍니다.
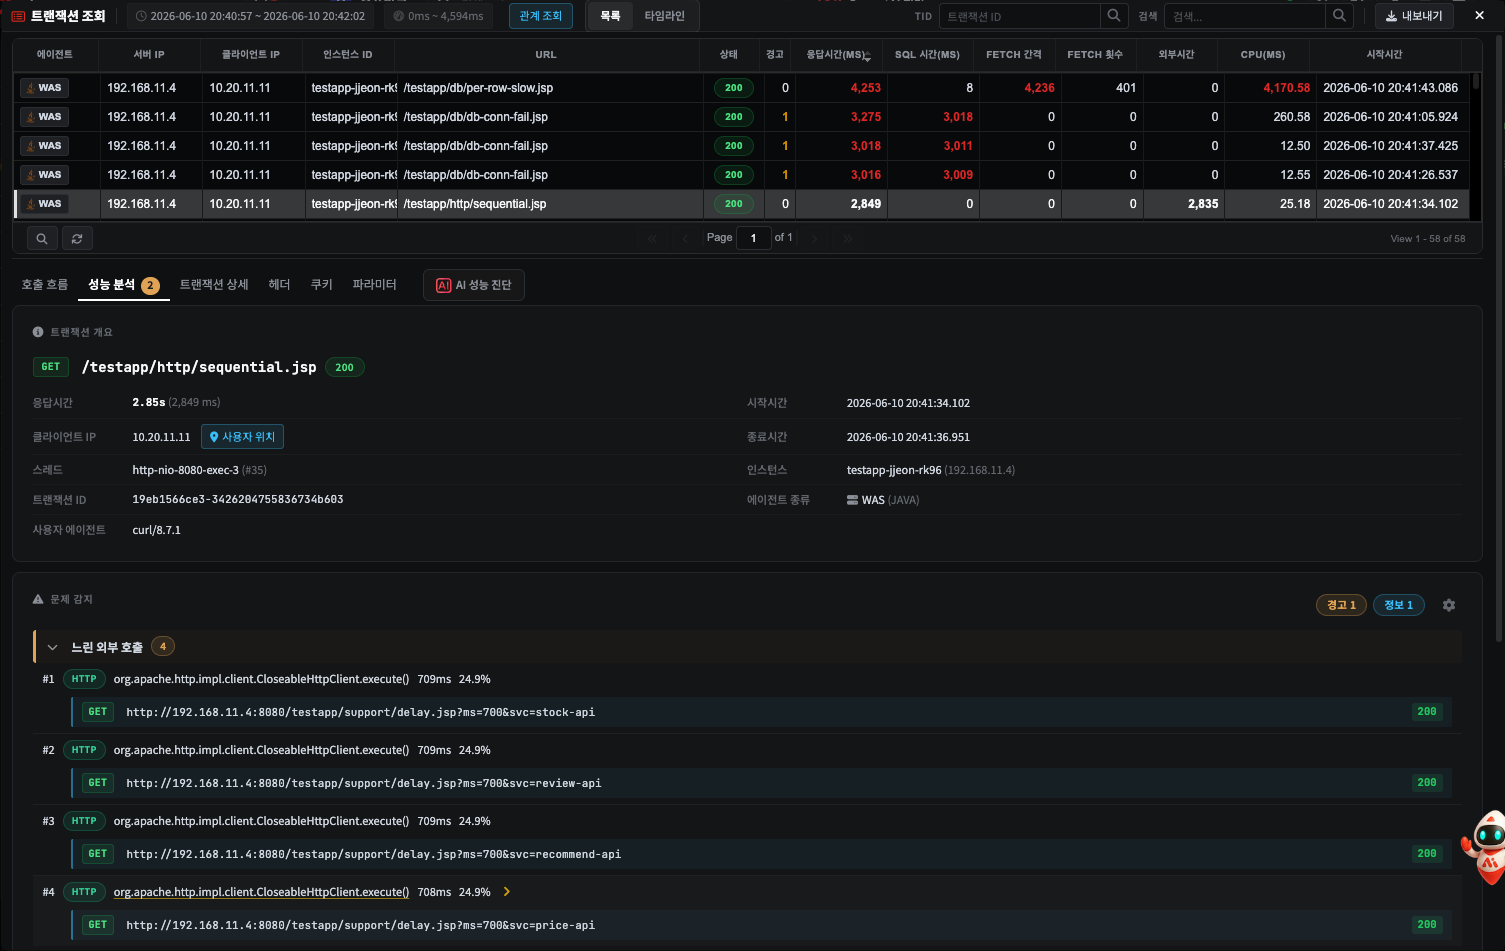
- 원인 —
CompletableFuture의.get()을 호출 직후마다 await /@Asyncthread pool 크기 1 / Reactorblock()남용 - 조치 — future를 모두 시작한 뒤 마지막에 일괄 대기(
allOf패턴) → thread pool 크기 확보 → Reactor는Mono.zip/Flux.merge.
18. 트리 구조 이상
호출 흐름이 비정상적으로 깊거나(깊이 30 초과) 넓습니다(한 부모의 직속 자식 200 초과) — 재귀 폭주나 호출 설계 문제의 신호입니다.
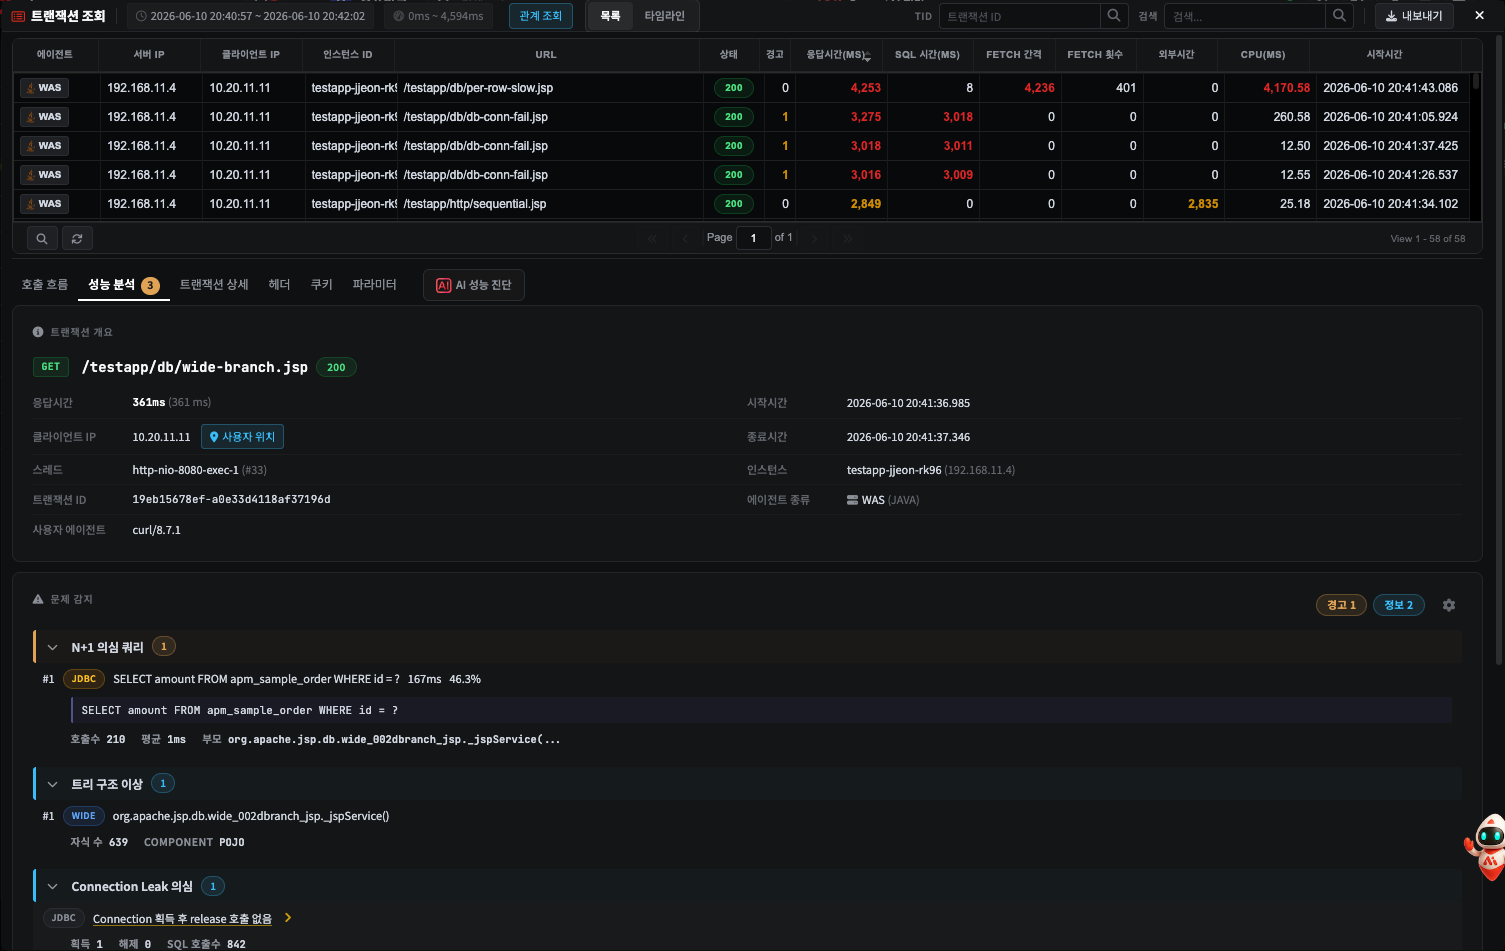
- 원인 — 재귀의 base case 누락 / 그래프 순회가 같은 노드 재방문 / 자식 다수를 평면 나열
- 조치 — 재귀 → 반복·DP, cycle 검출(visited set), memoization.
참고 자식이 많아도 모두 같은 SQL이면 패턴 9(N+1)로, 모두 같은 fetch면 패턴 15(대량 Fetch)로 표시되고 이 패턴에서는 제외됩니다 — 중복 표시를 피하기 위한 흡수 규칙입니다.
19. Connection Leak 의심
한 트랜잭션 안에서 커넥션을 getConnection()으로 획득했는데 close/release 호출이
trace에 보이지 않습니다. 패턴 7(Connection Pool 대기)과 짝으로 자주 발생합니다 — 누수가
누적되면 풀이 고갈되고, 후속 트랜잭션이 패턴 7로 대기합니다. 이 카드는 누수를 일으킨
트랜잭션 자체를 가리킵니다.
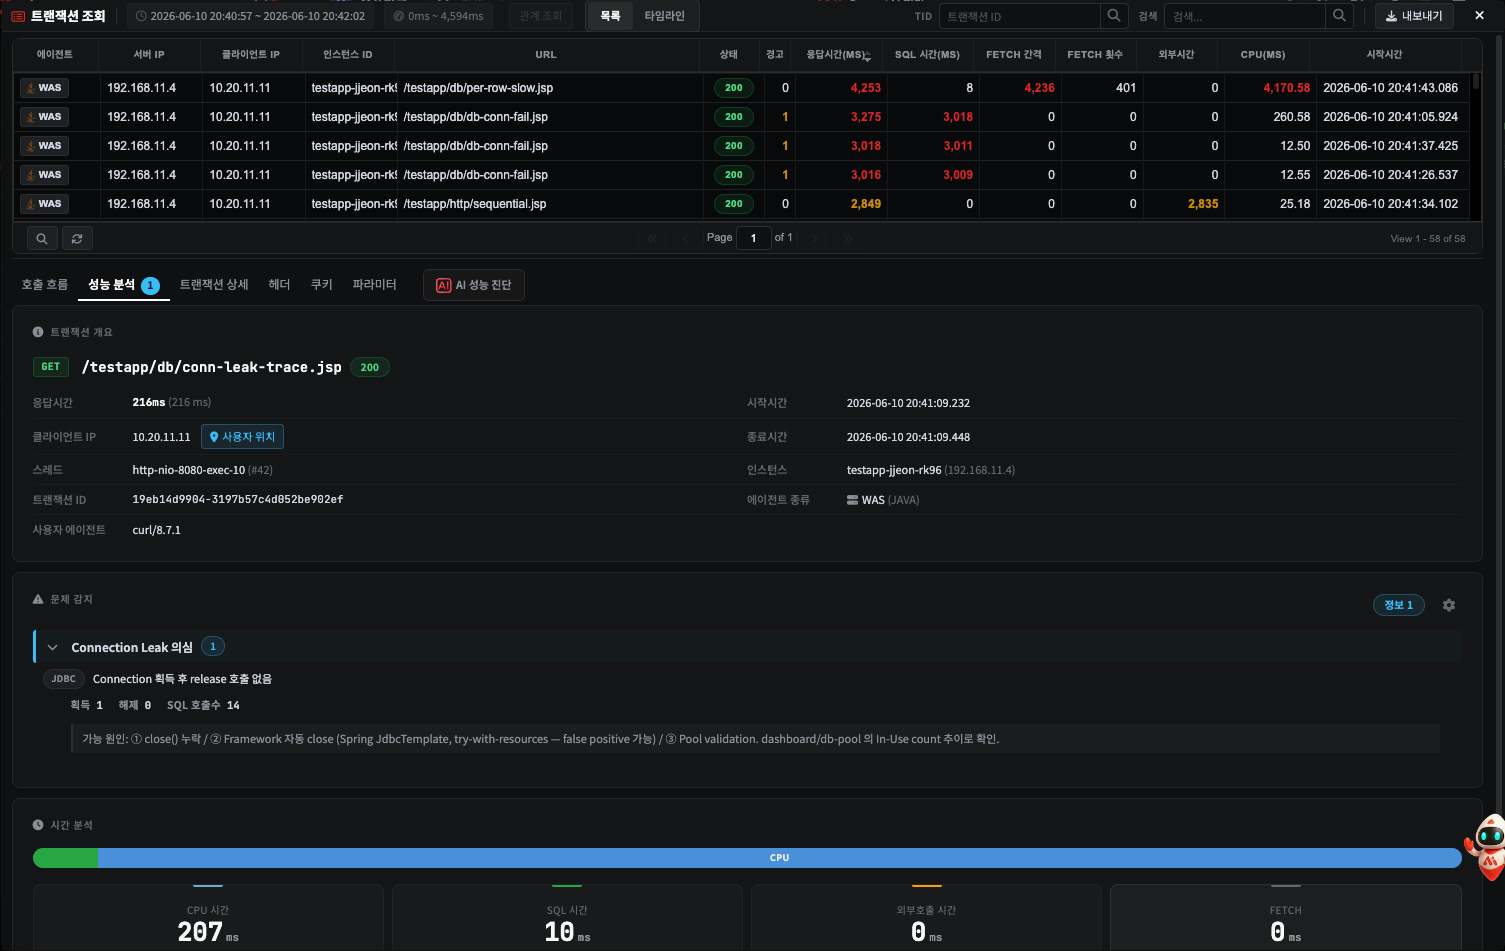
| 항목 | 패턴 7 Connection Pool 대기 | 패턴 19 Connection Leak 의심 |
|---|---|---|
| getConnection 시간 | 느림 (수백 ms) | 빠르게 성공 |
| 의미 | 풀 고갈의 결과 (영향을 받는 쪽) | leak의 원인 (원인이 되는 쪽) |
- 확인 — WAS ▸ 데이터소스 풀 차트의 사용 중 연결 수 추이. 트래픽이 줄어도 내려오지 않고 계속 증가하면 진짜 leak입니다 (H8. DB 커넥션 풀 고갈 진단).
- 조치 — try-with-resources 또는 Spring template로 자동 close → 명시적
try-finallyclose → Tomcat JDBC abandoned tracking 활성화.
주의 이 카드는 기본 비활성입니다 — 문제 감지 헤더의 설정(설정) 에서 켜야 표시됩니다. Spring
JdbcTemplate처럼 framework가 내부에서 close하는 환경에서는 false positive가 날 수 있어, 사용자가 그 가능성을 인지한 상태에서만 보이도록 한 설계입니다. 풀 차트의 사용 중 추이가 정상이면 무시해도 됩니다.
진단 워크플로
느린 트랜잭션을 열었을 때의 실전 순서입니다.
- 성능 분석 탭에서 Tier 1(빨강) 카드부터 확인합니다 — 있으면 그것이 원인입니다.
- DB 관련 카드가 여러 장이면 가장 뿌리부터 봅니다: ① DB 연결 실패(패턴 1)가 있으면 다른 DB 카드는 무시하고 연결부터 회복 → ② SQL 객체 참조 오류(패턴 3)는 마이그레이션 누락, 다른 카드는 그 영향으로 나타났을 가능성 → ③ DB Lock 대기(패턴 8)는 lock holder 추적 → ④ Connection Pool 대기(7) + Leak 의심(19)이 함께면 leak가 root.
- Tier 1이 없으면 Tier 2(주황) 에서 누적 시간이 가장 큰 카드부터 — N+1은 ORM fetch 전략, 핫스팟은 캐시, 느린 SQL은 EXPLAIN, 느린 외부 호출은 외부 서비스를 봅니다.
- Tier 2도 없으면 Tier 3은 잠재 위험 신호로 기록해 둡니다.
- 같은 카드가 여러 트랜잭션에서 반복되면 시스템성 문제(코드 회귀/인프라)입니다 — 이벤트·알림에서 빈도를 확인하세요. 단일 트랜잭션만이면 데이터·시나리오 특수성입니다.
잘 안될 때
| 증상 | 점검 |
|---|---|
| 문제 감지 카드가 하나도 없음 | "감지된 문제 없음"이면 정상 트랜잭션 — 시간 분석의 구간 비중과 H5. T-Map 패턴으로 전환 |
| Connection Leak 의심이 안 보임 | 기본 비활성 — 문제 감지 헤더의 설정(설정)에서 활성화 (패턴 19 참고) |
| 패턴 7이 떴는데 DB는 안 느림 | 그게 이 패턴의 정상 동작 — DB가 아니라 풀이 문제 (패턴 7 참고) |
| 패턴 7 카드에 풀 사용량·차트 보기가 없음 | 그 시각의 지표가 없는 경우(에이전트 기동 직후, 오래된 트랜잭션 등)이거나 추정 카드입니다 — WAS ▸ 데이터소스에서 기간을 직접 골라 봅니다 (패턴 7 참고) |
| 패턴 7 카드가 "풀 여유"인데 대기가 길었음 | 새 연결 생성 지연이나 연결 검사 쿼리(testOnBorrow) 쪽 — 또는 다른 풀에서 기다렸을 수 있습니다. 표시된 풀은 사용 비율이 가장 높은 하나뿐입니다 |
| 카드가 예상과 다른 패턴으로 분류됨 | 흡수 규칙 — N+1이 정확히 식별되면 트리 이상에서 제외되는 등 더 구체적 패턴이 우선 |
| 카드 클릭해도 이동이 안 됨 | 호출 흐름 탭이 로드된 뒤 다시 시도, 안 되면 다이얼로그를 다시 여세요 |
관련 문서
- T2. 느린 요청 하나 끝까지 추적해보기 — 트랜잭션 추적 따라하기
- T3. AI로 원인 분석하기 — 느린 SQL의 AI 쿼리 진단
- H8. DB 커넥션 풀 고갈 진단 — 패턴 7·19의 풀 차트 교차 확인
- H5. T-Map 패턴으로 진단하기 — 서비스 전체의 응답 분포 패턴
- R3. 이벤트 종류 레퍼런스 — 같은 패턴의 반복 발생 확인