10.2. Cache PromQL 쿼리 가이드
커스텀 대시보드·보고서 패널에서 사용하는 PromQL 쿼리 문법과 지원 범위를 안내합니다.
개요
Cache PromQL은 커스텀 대시보드와 SRE 보고서의 커스텀 보고서에서 패널이 표시할 지표를 기술하는 데 쓰는 Prometheus 호환 쿼리 언어입니다. 표준 PromQL의 널리 쓰이는 하위 집합을 지원하며, 제품이 미리 계산해 둔 지표 캐시를 대상으로 평가합니다.
다음 세 곳에서 이 쿼리를 작성합니다.
- 커스텀 대시보드 패널의 PromQL 쿼리
- 커스텀 보고서의 PromQL 패널
- 변수(Variable) 의
query유형 쿼리(label_values(...))
이 문서는 패널을 직접 만드는 사용자를 위한 참고서입니다. 어떤 연산자·함수를 쓸 수 있는지, 무엇이 지원되지 않는지, 그리고 자주 겪는 함정을 정리합니다.
참고: PromQL 문법 자체를 몰라도 커스텀 대시보드·SRE 보고서의 템플릿으로 시작하면 대부분의 화면을 만들 수 있습니다. 이 문서는 템플릿을 수정하거나 직접 지표를 조합할 때 참고하세요.
어떻게 동작하나
Cache PromQL은 일반 Prometheus 서버가 아니라, 제품이 수집·집계해 캐시에 저장한 지표를 대상으로 쿼리를 평가합니다. 이 때문에 몇 가지 실용적인 특성이 있습니다.
- 시계열 중심: 결과는 시간 범위에 대한 시계열입니다. 단일 값(stat)·표(table) 패널은 시계열의 가장 최근 값을 사용합니다.
- 캐시 해상도: 값은 캐시에 저장된 간격(스텝)의 해상도를 따릅니다. 원시(raw) 샘플 단위가 아닙니다.
- 값의 정밀도: 캐시는 값을 유효 숫자 약 7자리로 저장하고 계산합니다. 그래서 아주 큰 값(약 3.4×10³⁸ 초과)은 무한대가 됩니다. 큰 누적 값의 작은 차이(예: 10¹² 근처 값에서 1 차이)는 계산 결과에서 사라질 수 있습니다. 시각 값의 정밀도는 시간·날짜 함수를 참고하세요.
Metric Explorer — 어떤 지표가 있는지 찾기
쿼리를 쓰려면 먼저 어떤 지표(metric)가 있는지 알아야 합니다. 지표 이름을 외울 필요는 없습니다. 아래 방법으로 캐시에 저장된 지표를 직접 탐색하세요.
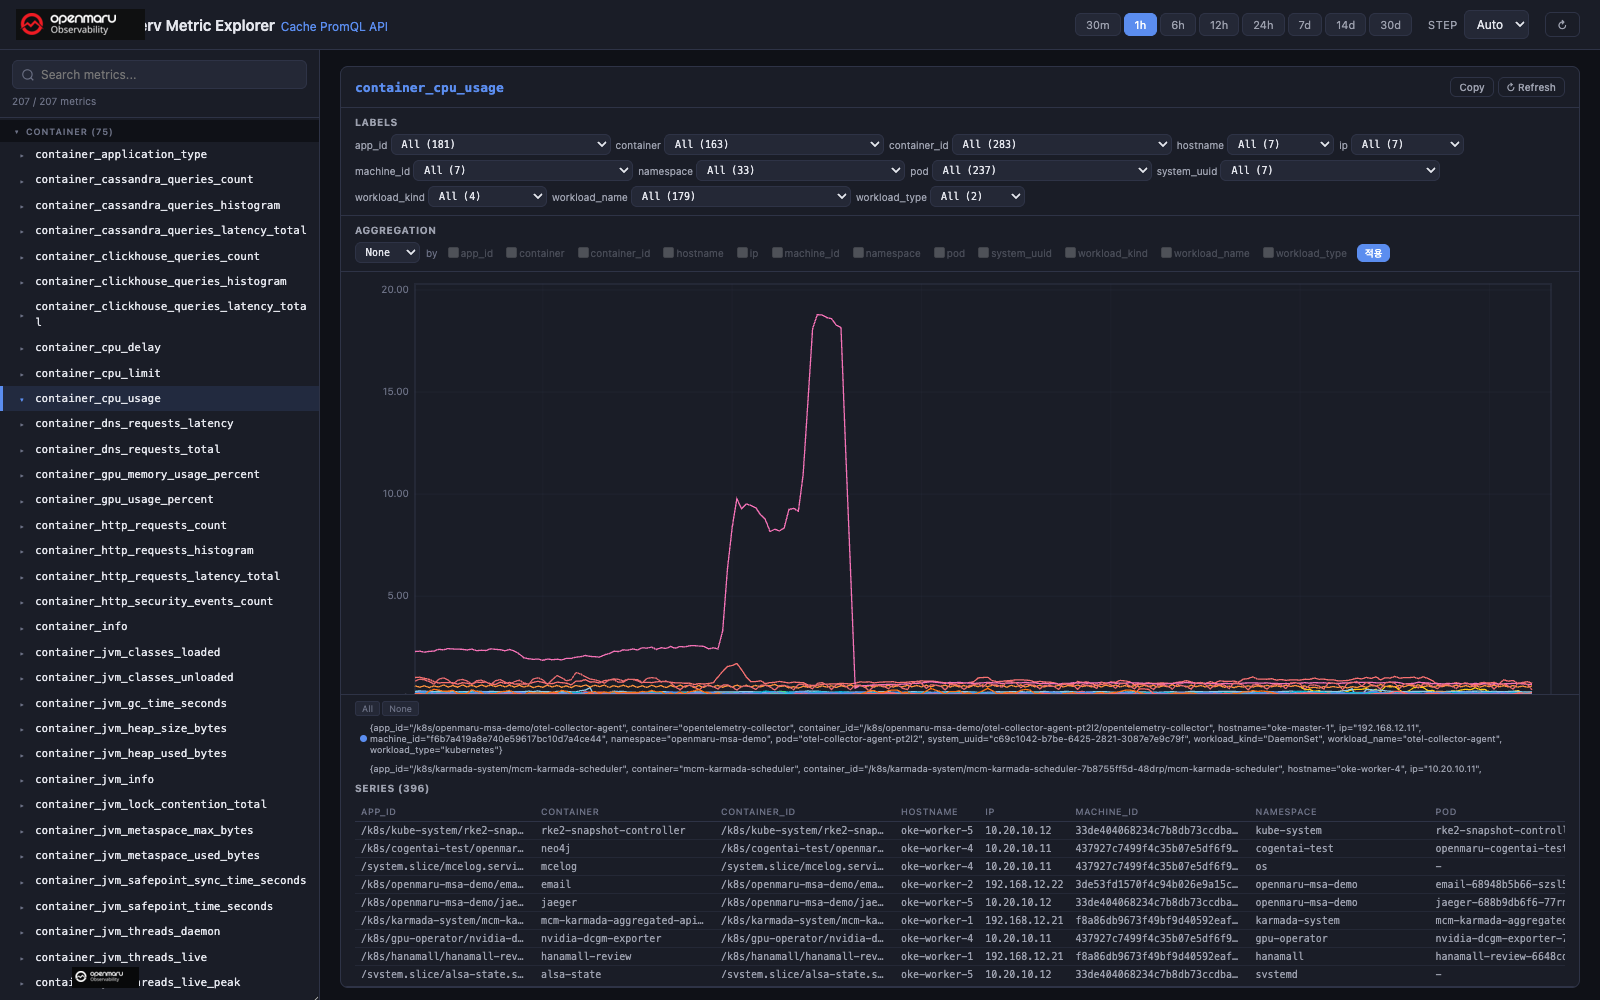
Metric Explorer(주소창
/api/v1/metrics-explorer)는 캐시에 저장된 전체 지표를 탐색하는 전용 화면입니다. 좌측에서 지표를 검색·선택하면 우측에 해당 지표의 라벨(차원) 과 각 라벨의 값 개수, 집계(Aggregation) 옵션, 시계열 차트, 그리고 개별 시리즈 목록이 표시됩니다. 지표 이름을 외우지 않고도 어떤 지표가 있고 어떤 라벨로 좁힐 수 있는지 한눈에 확인할 수 있습니다.
지표 이름을 목록으로 확인하기
캐시에는 표준 Prometheus 의 메타 레이블 __name__(지표 이름)이 그대로 들어 있습니다. 이를 이용하면 사용 가능한 모든 지표 이름을 값 목록으로 뽑을 수 있습니다.
- 커스텀 대시보드에서 변수(Variable) 를 하나 만들고, 유형을 질의로 가져오기, 쿼리를
label_values(__name__)로 지정합니다. - 저장하면 헤더의 변수 콤보에 캐시의 전체 지표 이름 목록이 드롭다운으로 나타납니다. 여기서 이름을 훑어보며 원하는 지표를 찾습니다.
- 특정 접두만 보고 싶으면 콤보에 검색어를 입력해 좁힙니다(예:
container_http,node_,kube_).
이 변수는 탐색 전용입니다. 원하는 지표를 확인한 뒤에는 삭제해도 됩니다. 변수 만드는 방법은 커스텀 대시보드의 "변수로 필터링하기" 절을 참고하세요.
지표의 레이블(차원) 확인하기
지표를 골랐다면, 그 지표가 어떤 레이블(예: namespace·pod·app_id)을 갖는지 확인해 매처·집계 기준으로 씁니다.
- 미리보기로 확인: 커스텀 대시보드의 패널 편집 다이얼로그에서 지표 이름만 입력하고 미리보기를 누르면, 결과 시계열의 범례에 레이블이 표시됩니다.
- 레이블 값 열거:
label_values(<지표>, <레이블>)로 특정 레이블의 값 목록을 뽑습니다. 예)label_values(container_http_requests_count, namespace)— 이 지표가 존재하는 네임스페이스 목록.
주요 지표 카탈로그
자주 쓰는 지표를 범주별로 정리했습니다. 전체 목록은 위의 label_values(__name__) 로 확인하세요.
노드(호스트) — node_*
| 지표 | 설명 |
|---|---|
node_cpu_usage_percent · node_cpu_used · node_cpu_cores | CPU 사용률(%)·사용 코어·전체 코어 |
node_memory_usage_bytes · node_memory_usage_percent · node_memory_available_bytes | 메모리 사용량·사용률·가용량 |
node_disk_read_bytes · node_disk_written_bytes · node_disk_space_bytes · node_disk_io_time | 디스크 읽기·쓰기·용량·I/O 시간 |
node_net_rx_bytes · node_net_tx_bytes · node_net_rx_dropped · node_net_tx_dropped | 네트워크 수신·송신 바이트·드롭 |
node_load_average_1m · node_load_average_5m · node_load_average_15m | 부하 평균 |
node_gpu_utilization_percent_avg · node_gpu_memory_used_bytes · node_gpu_power_usage_watts · node_gpu_temperature_celsius | GPU 사용률·메모리·전력·온도 |
node_uptime_seconds · node_info | 가동 시간·노드 메타 |
컨테이너·애플리케이션 리소스 — container_*
| 지표 | 설명 |
|---|---|
container_cpu_usage · container_cpu_limit · container_throttled_time | CPU 사용·한도·스로틀 시간 |
container_memory_rss · container_memory_cache · container_memory_limit | 메모리 RSS·캐시·한도 |
container_restarts · container_oom_kills_total | 재시작 횟수·OOM Kill |
container_net_tcp_bytes_sent · container_net_tcp_bytes_received · container_net_tcp_active_connections · container_net_latency | TCP 송·수신 바이트·활성 연결·지연 |
container_volume_used · container_volume_size | 볼륨 사용·전체 용량 |
container_log_messages | 로그 메시지 수(레벨 레이블 포함) |
container_info · container_application_type | 컨테이너·앱 유형 메타 |
L7 요청·쿼리(프로토콜별) — container_<프로토콜>_*
eBPF 로 계측한 애플리케이션 트래픽입니다. 프로토콜별로 같은 이름 패턴을 씁니다.
| 지표 패턴 | 설명 |
|---|---|
container_http_requests_count | HTTP 요청률(초당, 이미 rate 반영 — 감쌀 필요 없음) |
container_http_requests_total | HTTP 요청 누적 수 |
container_http_requests_histogram · ..._duration_seconds_total_bucket | 응답시간 히스토그램(분위수 계산용) |
container_http_requests_latency_total | 요청-초 합계(평균 지연 근사용) |
container_http_security_events_count · container_http_geo_country_pct | 보안 이벤트 수·요청 지역 분포 |
HTTP 외에 데이터베이스·메시징 프로토콜은 각각 _requests_ 또는 _queries_ 계열로 동일 패턴을 따릅니다.
- 요청형(
_requests_):container_kafka_requests_*·container_zookeeper_requests_* - 쿼리형(
_queries_):container_postgres_queries_*·container_mysql_queries_*·container_mongo_queries_*·container_oracle_queries_*·container_cassandra_queries_*·container_clickhouse_queries_*·container_memcached_queries_* - 기타:
container_dns_requests_total·container_dns_requests_latency·container_nats_messages_total
접미어 규칙: 같은 계열에서
_count(초당 비율, rate 반영) ·_total(누적 수) ·_histogram/_bucket(분위수용) ·_latency_total(요청-초 합계) 로 나뉩니다._count계열에는 rate 가 이미 반영되어 있으므로rate()/increase()로 감쌀 필요가 없습니다(아래 rate · irate · increase 참조).
언어 런타임 — container_jvm_* · container_dotnet_* · container_python_*
| 지표(예) | 설명 |
|---|---|
container_jvm_heap_used_bytes · container_jvm_heap_size_bytes · container_jvm_gc_time_seconds · container_jvm_threads_live | JVM 힙·GC·스레드 |
container_dotnet_memory_heap_size_bytes · container_dotnet_gc_count_total · container_dotnet_thread_pool_size | .NET 힙·GC·스레드풀 |
container_python_thread_lock_wait_time_seconds | Python 스레드 락 대기 |
Kubernetes 상태(kube-state) — kube_* · pod_*
| 지표 | 설명 |
|---|---|
kube_pod_info · kube_pod_status_phase · kube_pod_container_status_ready | Pod 메타·상태·컨테이너 준비 |
kube_pod_container_resource_limits · kube_pod_container_resource_requests | 컨테이너 요청·한도(CPU·메모리) |
kube_deployment_spec_replicas · kube_statefulset_replicas · kube_daemonset_status_desired_number_scheduled | 워크로드 레플리카 |
pod_count · pod_pending · pod_failed | Pod 수·대기·실패 |
kube_node_info · kube_service_info | 노드·서비스 메타 |
참고: 위 표는 대표 지표만 추린 것입니다. 언어·프로토콜·GPU 등 세부 지표는 환경에 따라 존재 여부가 다르므로, 실제 사용 가능한 목록은 항상
label_values(__name__)로 확인하는 것이 정확합니다.
지원하는 문법
아래 항목은 기본 설정에서 사용할 수 있습니다. 일부 고급 함수는 관리자가 서버 옵션으로 끌 수 있습니다(아래 참고 참조).
지표 셀렉터와 레이블 매처
지표 이름 뒤에 중괄호로 레이블 조건을 붙여 대상을 좁힙니다.
| 매처 | 의미 | 예 |
|---|---|---|
label="value" | 정확히 일치 | {namespace="prod"} |
label!="value" | 일치하지 않음 | {namespace!="kube-system"} |
label=~"regex" | 정규식 일치 | {pod=~"web-.*"} |
label!~"regex" | 정규식 불일치 | {pod!~"canary-.*"} |
변수를 함께 쓸 수 있습니다: {namespace="{{namespace}}"}. 다중 선택 변수는 namespace=~"a|b" 형태로 자동 치환됩니다.
지표 이름도 정규식으로 고를 수 있습니다. 예) {__name__=~"container_(cpu_usage|memory_rss)", namespace="prod"}. 결과 시계열마다 자기 지표 이름(__name__)이 붙습니다. 한 쿼리에서 고를 수 있는 지표는 20개까지입니다. 20개를 넘으면 오류가 표시되므로 정규식을 좁히세요. 지표 이름 없이 레이블만 쓴 셀렉터({namespace="prod"})는 지원하지 않습니다.
여러 지표를 고른 뒤 지표 이름을 지우는 함수나 연산(예: ceil, abs, x * 2)을 적용하면, 지표만 다르고 레이블이 같은 시계열들이 서로 구분되지 않습니다. 이때는 Prometheus 와 같이 오류(HTTP 400, "vector cannot contain metrics with the same labelset")가 납니다. 지표마다 쿼리를 나누거나, by (__name__) 처럼 지표 이름을 남기는 집계를 쓰세요.
집계 연산자
여러 시계열을 하나로 묶습니다. by(...)로 묶을 기준을, without(...)로 제외할 레이블을 지정합니다.
| 연산자 | 설명 |
|---|---|
sum | 합계 |
avg | 평균 |
min / max | 최소 / 최대 |
count | 시계열 개수 |
topk(k, ...) / bottomk(k, ...) | 상위 / 하위 k개. 시간 범위 쿼리에서는 시점마다 순위를 따로 매기므로, 순위에서 빠진 시점은 선이 끊기고 범례에 k개보다 많은 시계열이 보일 수 있습니다 |
quantile(φ, ...) | 분위수 |
stddev / stdvar | 표준편차 / 분산 |
group | 그룹 존재 여부(모든 값을 1로) |
count_values("레이블", ...) | 같은 값을 가진 시계열 개수. 값이 지정한 레이블에 들어감 |
예) sum by(namespace)(container_memory_rss) — 네임스페이스별 메모리 합계.
without(...) 은 나열한 레이블만 지우고 나머지 레이블은 모두 남깁니다. 따라서 container_id 같은 레이블이 남아 있으면 결과 시계열이 그 단위로 나뉩니다.
by(...) 에는 레이블을 여러 개 쓸 수 있습니다. 예) count by (namespace, pod) (kube_pod_info) — 네임스페이스·Pod 조합별 개수. 고유 조합의 개수는 count(count by (namespace, pod) (kube_pod_info)) 로 셉니다.
집계 결과에는 by(...) 에 쓴 레이블만 남습니다. 지표 이름(__name__)도 남지 않습니다. 지표별로 나누려면 by (__name__) 처럼 __name__ 을 함께 쓰세요. 예) count by (__name__) ({__name__=~"container_(cpu_usage|memory_rss)"}).
어떤 시점에 값이 있는 시계열이 하나도 없으면, 그 시점의 sum · count · avg 결과는 0 이 아니라 빈 구간으로 표시됩니다. 수집이 끊긴 구간을 실제 0 과 구분하기 위해서입니다. 범례에 workload_name 같은 레이블을 표시하려면 by (app_id, workload_name) 처럼 by(...) 에 함께 쓰세요.
이항 연산과 비교
- 산술:
+-*/%^(거듭제곱)atan2. 단항-로 부호를 바꿀 수 있습니다. 예)-sum(metric) - 비교:
><>=<===!=— 조건을 만족하는 시계열만 남깁니다. 남은 시계열은 원래 레이블과 지표 이름을 그대로 가집니다.bool수식자를 붙이면 참/거짓을 0/1 값으로 바꿉니다. - 논리·집합:
andorunless
예) sum(rate_metric) / sum(total_metric) * 100 — 비율(%) 계산.
벡터 매칭
서로 다른 지표를 레이블로 짝지어 연산합니다.
| 수식자 | 설명 |
|---|---|
on(labels) | 나열한 레이블만으로 매칭 |
ignoring(labels) | 나열한 레이블을 제외하고 매칭 |
group_left(labels) | 왼쪽이 다대일(오른쪽에서 레이블 가져오기) |
group_right(labels) | 오른쪽이 다대일 |
예) pod_metric * on(node) group_left(role) node_meta.
함수
수학 함수
abs · ceil · floor · round · exp · ln · log2 · log10 · sqrt · sgn · clamp(v, min, max) · clamp_min(v, min) · clamp_max(v, max)
삼각함수: sin · cos · tan · asin · acos · atan · sinh · cosh · tanh · asinh · acosh · atanh · deg(라디안 → 도) · rad(도 → 라디안) · pi()
pi() · 1 + 1 처럼 식 전체가 상수이면, 모든 시점에 같은 값을 가진 레이블 없는 시계열 하나로 표시합니다.
레이블 함수
label_replace(v, dst, replacement, src, regex)— 정규식으로 레이블 값을 바꾸거나 새 레이블 생성label_join(v, dst, sep, src1, src2, ...)— 여러 레이블을 합쳐 새 레이블 생성
시간·날짜 함수
time()— 각 시점의 시각(초)timestamp(v)— 샘플의 타임스탬프hour(v)·minute(v)·day_of_week(v)·day_of_month(v)·days_in_month(v)·month(v)·year(v)— 인자를 주면 그 값을, 인자를 생략하면 각 시점을 기준으로 계산합니다
날짜 함수는 기본으로 한국 표준시(KST) 로 계산합니다. Prometheus 는 UTC 로 계산하므로, 같은 쿼리라도 결과가 9시간 다를 수 있습니다. 예) UTC 03:00 에 hour() 는 이 서버에서 12, Prometheus 에서 3 입니다. 관리자는 서버의 환경 변수 OBSERV_PROMQL_TIMEZONE 에 IANA 시간대 이름(예: UTC, America/New_York)을 넣어 시간대를 바꿀 수 있습니다. 값이 없으면 KST 이고, 잘못된 값이면 서버가 경고를 기록하고 KST 를 씁니다.
time()·timestamp(v)·vector(<시각>) 의 결과와, 이 값에 스칼라를 더하거나 빼는 계산은 초 단위까지 정확합니다. 저장된 지표 값은 유효 숫자 약 7자리로 저장됩니다. 그래서 값 자체가 시각인 지표(예: process_start_time_seconds)는 최대 1분 정도 어긋날 수 있습니다.
범위 집계(_over_time)
지정한 시간 창 안의 값을 집계합니다. 예) avg_over_time(metric[5m]).
avg_over_time · sum_over_time · min_over_time · max_over_time · count_over_time · last_over_time · present_over_time · stddev_over_time · stdvar_over_time · quantile_over_time
변화량 함수
지정한 시간 창 안에서 값이 얼마나 바뀌었는지 계산합니다. 예) changes(container_restarts[1h]).
delta(v[창])— 창의 처음과 끝 값의 차이(창 경계까지 보정)deriv(v[창])— 초당 변화율(최소제곱 기울기)idelta(v[창])— 창 안 마지막 두 값의 차이changes(v[창])— 값이 바뀐 횟수resets(v[창])— 값이 줄어든 횟수
이 함수들은 게이지(현재 값을 나타내는 지표)에 씁니다. 요청 수처럼 비율 계산이 이미 들어간 지표 별칭에 쓰면 "변화율의 변화량" 이 되므로 뜻이 달라집니다.
참고: 범위 집계와 변화량 함수는 읽는 지표의 저장 간격의 값으로 창을 계산합니다. 대부분의 지표는 15초로 저장되고, 사용자 수 추정 지표(
rr_ue_active_*)만 60초로 저장됩니다. 조회 간격(스텝)이 저장 간격보다 길어도 창 안의 저장 값을 모두 씁니다.
- 범위 창(예:
[5m])은 저장 간격과 같거나 길어야 합니다. 더 짧으면 오류입니다.- 쿼리 하나가 읽는 저장 값이 상한(기본 5천만 개,
OBSERV_PROMQL_WINDOW_MAX_POINTS)을 넘거나, 이렇게 계산 중인 쿼리 수가 상한(기본 4개,OBSERV_PROMQL_WINDOW_MAX_CONCURRENT)에 이르면, 서버는 조회 간격으로 줄인 값으로 근사 계산합니다. 이때 응답의warnings에 근사했다는 경고를 넣고, 커스텀 대시보드는 패널에 경고 아이콘을 표시합니다. 예) 모든 컨테이너의 5일 범위avg_over_time(container_memory_rss[1h])(약 1억 개)는 근사되고, 1일 범위(약 530만 개)는 정확하게 계산됩니다.- 근사 계산을 할 때는 범위 창이 조회 간격과 같거나 길어야 합니다. 더 짧으면 오류입니다.
absent_over_time은 범위 창이 조회 간격보다 짧으면 오류입니다.- 서브쿼리 안에서는 근사하지 않고 오류를 냅니다(서브쿼리 참고).
기타 함수
histogram_quantile(φ, ...)— 히스토그램에서 분위수(예: P95) 계산vector(s)— 스칼라를 레이블 없는 시계열로scalar(v)— 단일 시계열을 스칼라로absent(v)·absent_over_time(m[5m])— 값이 없으면 1을 반환(누락 감지)sort·sort_desc·sort_by_label— 시간 범위 쿼리에서는 정렬이 의미가 없어 그대로 통과합니다
기간 대비(offset)
offset으로 과거 같은 구간의 값을 가져와 비교합니다.
예) metric / (metric offset 1d) — 하루 전 대비 비율.
offset 이 조회 간격(스텝)의 배수가 아니면, 과거 방향으로 가장 가까운 스텝 배수로 올려 계산합니다. 예) 스텝 60초에 offset 90s 는 offset 120s 로 계산합니다. 캐시는 스텝 경계에 저장된 값만 있기 때문입니다.
시간 범위 쿼리의 시작 시각이 스텝 경계와 맞지 않으면, 응답의 시각은 스텝 경계(예: 정분)로 맞춰집니다.
서브쿼리
서브쿼리는 식을 일정 간격으로 계산한 결과에 범위 집계나 변화량 함수를 적용합니다. 형식은 <식>[<범위>:<해상도>] 입니다.
예) max_over_time(sum by (namespace) (container_memory_rss)[1d:5m]) — 네임스페이스별 메모리 합계의 하루 중 최댓값.
- 쓸 수 있는 자리: 범위 집계(
*_over_time·quantile_over_time), 변화량 함수(changes·resets·deriv·delta·idelta),absent_over_time의 범위 인자입니다. 서브쿼리 안에 서브쿼리를 둘 수 있고, 괄호와offset도 쓸 수 있습니다. - 해상도를 생략하면 (
[1h:]) 1분입니다. Prometheus 기본값과 같습니다. - 계산 시각: 서버는 안쪽 식을 해상도의 배수가 되는 시각(예: 5분 해상도면 정각·5분·10분)에 계산합니다. 그래서 같은 서브쿼리는 조회 시각과 상관없이 같은 값을 냅니다.
- 저장 간격보다 짧은 해상도: 저장된 값이 없는 시각에는 5분 안의 가장 최근 저장 값을 씁니다. Prometheus 와 같습니다. 단, 캐시는 시계열이 끊긴 시점을 따로 기록하지 않습니다. 그래서 데이터가 끊긴 뒤에도 5분 동안 마지막 값이 이어집니다.
- 계산량 상한: 안쪽 식이 만드는 점 수가 쿼리당 상한(기본 5천만,
OBSERV_PROMQL_WINDOW_MAX_POINTS)을 넘으면 오류가 납니다. 동시에 계산할 수 있는 수(기본 4,OBSERV_PROMQL_WINDOW_MAX_CONCURRENT)를 넘어도 오류가 납니다. 해상도를 크게 하거나 범위를 줄이세요. 서버는 해상도를 임의로 바꾸지 않습니다. 서브쿼리 안의 범위 집계(예:max_over_time(count_over_time(x[5m])[1h:2m]))도 같습니다. 상한을 넘으면 근사하지 않고 오류가 납니다. 서브쿼리 하나는 동시 계산 수를 하나만 씁니다. - 서브쿼리 안의
timestamp(지표): 값을 찾아 쓴 저장 값의 시각입니다. Prometheus 와 같습니다. 예) 60초 간격 데이터에 10초 해상도를 쓰면, 같은 저장 값을 쓴 계산 시각들은 모두 그 저장 시각을 돌려줍니다. 지표가 아닌 식의timestamp()(예:timestamp(x + 0))는 계산 시각입니다.
다음 서브쿼리는 오류(HTTP 400)입니다.
- 함수 없이 쓴 서브쿼리 — 예)
sum(x)[1h:5m] rate()·irate()·increase()의 인자로 쓴 서브쿼리 — 예)rate(sum(x)[5m:1m]). 서버는 안쪽 결과가 누적 카운터인지 이미 rate 인 값인지 알 수 없습니다.
안쪽 식에 rate() 를 쓴 서브쿼리(예: max_over_time(rate(x[5m])[1h:1m]))는 계산합니다. rate() 는 rate · irate · increase 의 규칙을 따릅니다.
조회 간격과 시각 처리
캐시는 Prometheus 와 다르게 시각과 간격을 다음 규칙으로 정합니다.
- 간격(
step)을 생략한 시간 범위 쿼리: 서버가 간격을 정합니다. 점이 약 1,000개가 되는 값 이상에서 15초·30초·1분·2분·3분·5분·15분·30분·1시간 중 가장 작은 값을 고릅니다. 예) 1시간 범위는 15초, 24시간 범위는 2분, 7일 범위는 15분입니다. Prometheus 는step이 없으면 오류를 냅니다. - 단일 시점 쿼리(instant query)의 평가 시각: 서버는 평가 시각을 쿼리가 읽는 지표의 저장 간격(지표가 여럿이면 가장 짧은 간격, 보통 15초)의 경계로 내림합니다. 그래서 범위 집계의 창이 최대 한 간격만큼 과거 쪽으로 옮겨질 수 있습니다.
- 단일 시점 쿼리가 과거 값을 찾는 범위: 평가 시각에 값이 없으면, 서버는 5분 앞까지 가장 최근 값을 찾습니다. Prometheus 와 같습니다. 이 규칙은 지표 셀렉터에만 적용되고, 연산이나 함수의 결과에는 적용되지 않습니다. 캐시에는 staleness 표시가 없으므로, 수집이 끊긴 지표도 5분 동안은 마지막 값이 이어집니다.
- 읽지 못한 캐시 파일: 캐시 파일 일부가 손상되어 읽지 못하면, 서버는 읽은 부분만으로 결과를 돌려줍니다. 응답의
warnings에 "결과가 불완전할 수 있다" 는 경고를 넣습니다. 커스텀 대시보드는 이 경고를 패널에 표시합니다. 운영자는 서버 지표openmaru_cache_chunk_read_errors_total로 읽기 실패 수를 확인할 수 있습니다. - 시간 범위 응답의 빈 구간 보간: 시계열 중간의 빈 구간이 60초 이하면, 서버는 앞뒤 값을 직선으로 이어 채웁니다. 간격이 60초보다 길면 한 간격짜리 빈 구간만 채웁니다. 그래서 간격이 1시간인 쿼리에서는 1시간짜리 빈 구간도 채워집니다. 비교 필터(
x > 5등)·and·or·unless·topk·bottomk·count_values결과는 채우지 않습니다.
자주 쓰는 패턴과 주의점
rate · irate · increase
캐시는 요청 수·CPU 시간 같은 누적 카운터 대부분을 이미 초당 비율(rate)로 계산해 저장합니다. 예) container_cpu_usage 는 rate(container_resources_cpu_usage_seconds_total[…]) 입니다. 저장에 쓴 창은 수집 간격의 3배입니다.
서버는 rate() · irate() · increase() 의 인자가 어떤 지표인지 보고 계산 방법을 고릅니다.
| 인자 | rate(x[N]) | increase(x[N]) | irate(x[N]) |
|---|---|---|---|
이미 rate 로 저장된 지표(예: container_cpu_usage, container_http_requests_count) | 창 N 안의 저장된 rate 평균 | 평균 × N(초) | 창 안의 마지막 저장 rate |
그 밖의 지표(누적 카운터 그대로인 container_oom_kills_total 등) | Prometheus 와 같은 계산(카운터 리셋 보정, 창 끝까지 늘려 추정(Prometheus extrapolatedRate)) | Prometheus 와 같음 | Prometheus 와 같음 |
-
이미 rate 로 저장된 지표에 쓰면, 응답의
warnings에 "저장된 rate 를 평균해 계산했다" 는 경고가 붙습니다. 커스텀 대시보드는 이 경고를 패널에 표시합니다. 값은 Prometheus 가 원래 카운터로 계산한rate(x[N])와 가깝지만 같지는 않습니다. 저장된 rate 하나하나가 수집 간격의 3배 창으로 계산한 값이라, 창 N 의 앞부분에 창 밖의 데이터가 조금 섞입니다. -
창 N 이 저장에 쓴 창(수집 간격의 3배, 보통 45초)보다 짧으면 더 짧은 창의 값을 만들 수 없습니다. 서버는 저장된 값을 그대로 쓰고 경고를 붙입니다.
-
rate()를 쓴 값과 쓰지 않은 값은 단위는 같지만 값은 다릅니다. 평균을 내는 시간 범위가 다르기 때문입니다.쿼리 서버가 실제로 계산하는 식 값의 뜻 container_cpu_usage저장된 값 그대로 최근 약 45초(수집 간격의 3배) 동안의 초당 사용량 rate(container_cpu_usage[5m])avg_over_time(container_cpu_usage[5m])최근 5분 동안의 평균 초당 사용량(그래프가 더 매끄러움) irate(container_cpu_usage[5m])last_over_time(container_cpu_usage[5m])가장 최근 저장 값( rate()를 쓰지 않은 값과 같음)increase(container_cpu_usage[5m])avg_over_time(container_cpu_usage[5m]) * 300최근 5분 동안의 증가량 예) 같은 시각에 잰 값:
rate(container_cpu_usage[5m])의 합계는 3.447,container_cpu_usage의 합계는 3.041 입니다. -
이미 rate 로 저장된 지표는 목적에 맞는 식을 직접 쓰기를 권장합니다. 무엇을 계산하는지 쿼리에 드러나고 경고가 붙지 않습니다.
- 지금 값: 지표를 그대로 씁니다. 예)
sum by(app_id)(container_http_requests_count{namespace="{{namespace}}"}) - 창 평균:
avg_over_time(x[5m])를 씁니다(rate(x[5m])와 같은 값). - 창 안 증가량:
avg_over_time(x[5m]) * 300을 씁니다(increase(x[5m])와 같은 값).
- 지금 값: 지표를 그대로 씁니다. 예)
-
지표 이름 정규식(
{__name__=~"a|b"})을 인자로 쓰면 오류입니다. 지표마다 계산 방법이 다르기 때문입니다.
네임스페이스로 좁히기
대부분의 지표는 {namespace="{{namespace}}"} 매처로 네임스페이스를 좁힐 수 있습니다. 변수를 사용하면 헤더 콤보에서 네임스페이스를 바꿀 때 패널이 자동으로 다시 조회됩니다.
응답시간 분위수
지연(latency) 분위수는 히스토그램 기반 지표에 histogram_quantile을 적용하거나, 부하 가중 합계 계열(예: 요청-초 합계)을 요청 수로 나눠 근사합니다. 템플릿의 SLO·RED 예시를 참고하세요.
팁: 새 패널을 만들 때는 커스텀 대시보드의 패널 편집 다이얼로그에서 미리보기 버튼으로 쿼리를 먼저 확인하세요. 오류나 빈 결과가 있으면 안내 메시지로 알려 줍니다.
미지원 항목
다음은 현재 지원되지 않습니다.
| 항목 | 대안 |
|---|---|
@ 수식자(고정 시점) | 지원하지 않음 — offset 을 사용 |
limitk · limit_ratio | 지원하지 않음 — topk · bottomk 를 사용 |
함수 없이 쓴 서브쿼리 · rate() 의 서브쿼리 인자 | 범위 집계·변화량 함수 안에서 사용(서브쿼리 참고) |
rate() · irate() · increase() 의 지표 이름 정규식 인자 | 지표 이름을 하나씩 지정 |
predict_linear · holt_winters | SRE 보고서의 자원 예측 사용 |
시각 마스킹 metric and hour() >= 9 | 지원하지 않음(시간 함수는 레이블이 없어 마스킹 불가) |
지원되지 않는 문법을 쓰면 미리보기·출력 시 오류 메시지가 표시됩니다. 메시지에는 지원하지 않는 기능의 이름이 들어 있습니다.
변수와 함께 쓰기
변수는 여러 패널에 공통으로 적용되는 필터 값입니다. 쿼리 안에서 {{변수이름}}으로 참조합니다.
- query 유형 변수는
label_values(지표, 레이블)로 값 목록을 조회합니다. 예)label_values(namespace). - 종속 변수는 상위 변수를 매처에 넣어 하위 목록을 좁힙니다. 예)
label_values(container_info{namespace="{{namespace}}"}, pod).
변수의 정의·선택 방법은 커스텀 대시보드의 "변수로 필터링하기" 절을 참고하세요.
참고: 일부 특수 지표(예: 복합 키로 저장되는 사용자 추정 지표)는
label_values()의 소스로 적합하지 않을 수 있습니다. 변수 목록이 비면container_http_requests_count처럼 일반적인 지표로 네임스페이스를 열거하세요.
자주 묻는 질문
쿼리가 빈 결과를 반환합니다
- 지표 이름이나 레이블 값에 오타가 없는지 확인하세요.
- 매처가 너무 좁지 않은지(
{namespace="..."}값이 실제로 존재하는지) 확인하세요. - 종속 변수를 쓰는 경우 상위 변수를 먼저 선택해야 합니다.
- 미리보기 버튼으로 조회 결과와 오류 메시지를 확인하세요.
차트의 짧은 빈 구간이 선으로 이어져 보입니다
수집이 잠깐 빠진 짧은 구간은 앞뒤 값을 직선으로 이어 표시합니다. 차트가 짧게 끊겨 보이지 않게 하기 위한 동작입니다. 긴 구간이 비면 차트에도 빈 구간으로 표시됩니다. 어느 길이까지 채우는지는 조회 간격과 시각 처리를 참고하세요.
요청률이 이상하게 높거나 낮게 나옵니다
요청 수 지표에는 비율 계산이 이미 반영되어 있습니다. rate() 로 감싸면 서버가 저장된 rate 를 창 안에서 평균합니다. 창이 길면 짧은 급증이 평평해집니다. rate() 없이 sum by(...) 만 적용하면 저장된 값 그대로 볼 수 있습니다. 응답의 경고(커스텀 대시보드 패널의 경고 아이콘)로 어떤 계산을 했는지 확인하세요.
예측(predict_linear)을 쓰고 싶습니다
Cache PromQL은 예측 함수를 지원하지 않습니다. 미래 사용량 예측은 SRE 보고서의 자원 예측 탭을 사용하세요. 선형회귀·Holt-Winters·ARIMA·SARIMA 알고리즘을 제공합니다.
고급 함수가 동작하지 않습니다
수학 함수·범위 집계 등 고급 함수는 기본적으로 켜져 있지만, 관리자가 서버 옵션으로 비활성화한 환경에서는 "함수가 비활성화되어 있습니다"라는 오류가 날 수 있습니다. 이 경우 관리자에게 문의하세요.