5.1. 인시던트
SLO(서비스 수준 목표) 위반 또는 시스템 이상이 탐지되면 자동으로 생성되는 경보 목록을 확인하고 근본 원인을 분석합니다.
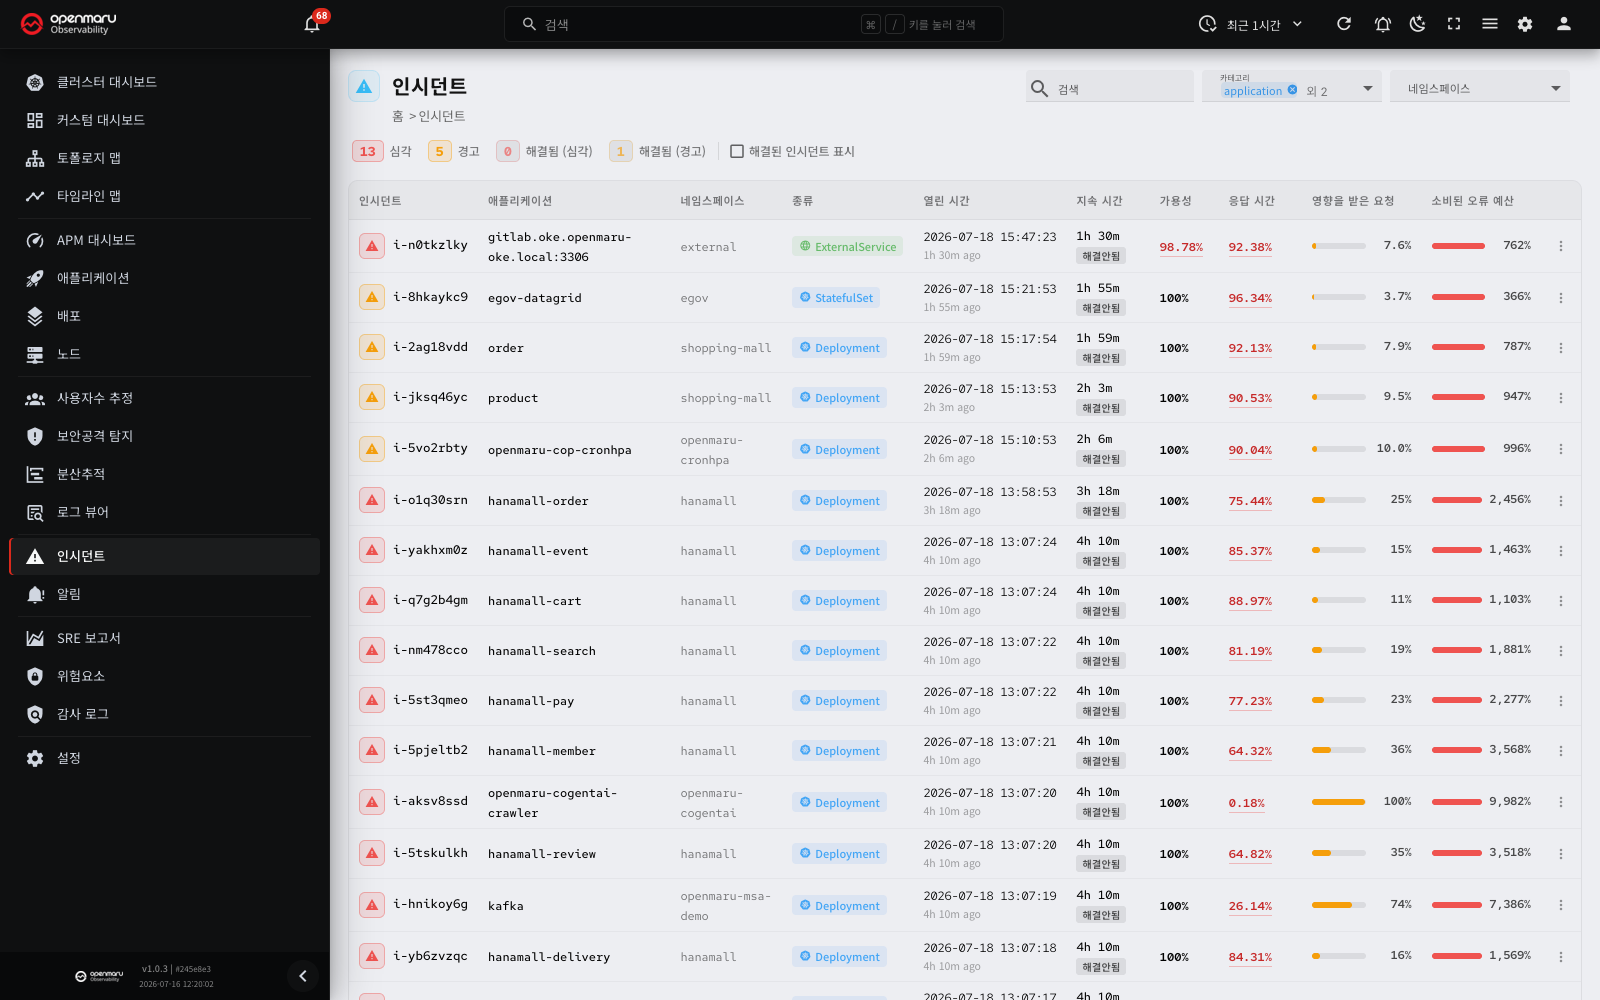
개요
인시던트 메뉴에서는 OPENMARU Observability가 자동으로 탐지한 인시던트(Incident)를 한눈에 파악할 수 있습니다. 인시던트(Incident)는 SLO(Service Level Objective, 서비스 수준 목표)를 위반하거나 애플리케이션 이상이 탐지될 때 자동으로 생성되는 경보입니다.
이 화면에서는 현재 진행 중인 인시던트와 해결된 인시던트를 조회하고, 인시던트별 심각도(Severity), 지속 시간, 영향받은 요청 비율, 오류 예산(Error Budget) 소비량을 확인할 수 있습니다. 각 인시던트를 클릭하면 상세 페이지로 이동하여 RCA(Root Cause Analysis, 근본원인분석)를 통해 인시던트 발생 원인을 파악할 수 있습니다.
화면 구성
인시던트 페이지는 다음 영역으로 구성됩니다.
- 상단 헤더: 애플리케이션 필터
- 상태 요약 스트립: 심각도별 인시던트 개수 및 해결된 인시던트 표시 옵션
- 인시던트 목록 테이블: 전체 인시던트 목록 및 SLO 영향 지표
주요 기능
상태 요약 스트립으로 현황 파악

화면 상단의 상태 요약 스트립에서 심각도별 인시던트 개수를 한눈에 확인할 수 있습니다.
| 상태 | 의미 |
|---|---|
| 심각 | 즉각 조치가 필요한 인시던트 수 |
| 경고 | 주의가 필요한 인시던트 수 |
| 해결됨 (심각) | 심각 상태에서 해결된 인시던트 수 |
| 해결됨 (경고) | 경고 상태에서 해결된 인시던트 수 |
특정 상태 항목을 클릭하면 해당 상태의 인시던트만 목록에 필터링되어 표시됩니다. 다시 클릭하면 필터가 해제됩니다.
팁: 심각을 클릭하면 즉각 대응이 필요한 인시던트를 빠르게 확인할 수 있습니다.
해결된 인시던트 표시
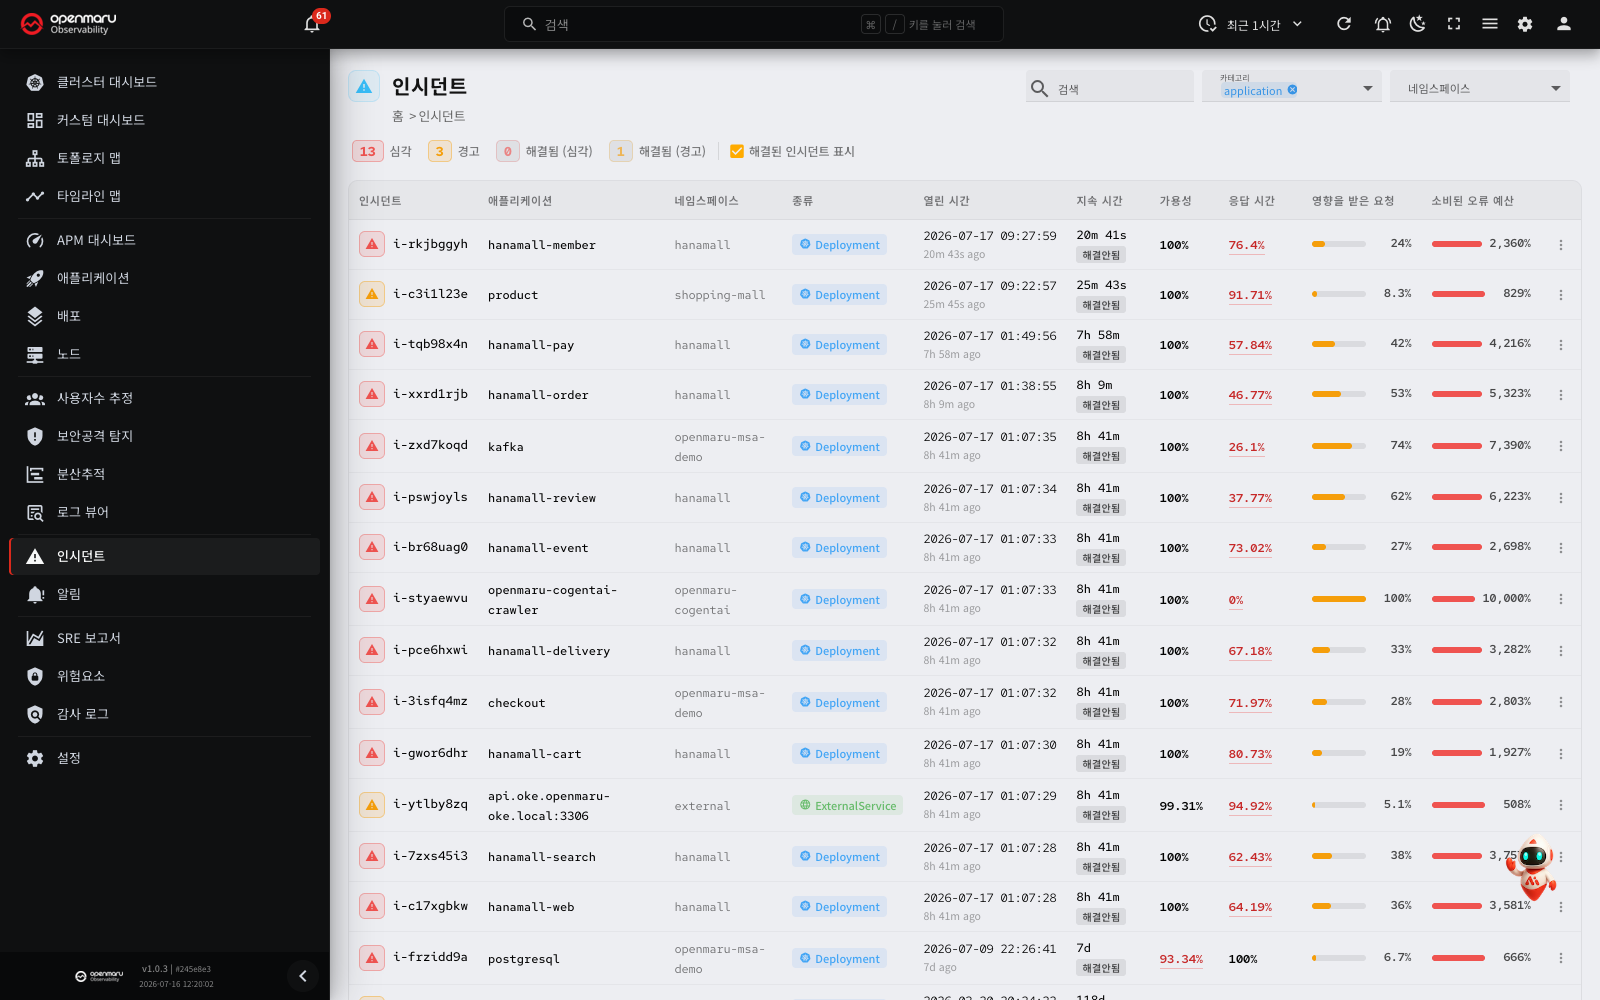
기본적으로 현재 진행 중인(해결되지 않은) 인시던트만 표시됩니다. 해결된 인시던트 표시 체크박스를 활성화하면 해결된 인시던트도 목록에 포함됩니다.
해결된 인시던트는 목록에서 반투명하게 표시되며, 지속 시간 열에 해결됨 배지가 표시됩니다.
참고: 해결된 인시던트 표시 설정은 브라우저에 저장되어, 다음 접속 시에도 마지막 선택이 유지됩니다.
인시던트는 해결 유예 시간이 지나야 해결됩니다
애플리케이션의 SLO 상태가 정상으로 돌아와도 서버는 인시던트를 바로 해결하지 않습니다. 서버는 정해진 시간(인시던트 해결 유예) 동안 기다린 뒤 인시던트를 해결합니다. 같은 장애로 인시던트가 해결되고 다시 열리는 일과, 그때마다 나가는 통보를 줄이기 위한 기능입니다.
| 항목 | 동작 |
|---|---|
| 기본값 | 5분(300초). 최대 3600초입니다. |
| 0 으로 설정 | 유예를 쓰지 않습니다. SLO 상태가 정상이 된 평가에서 바로 해결합니다. |
| 시간을 세는 기준 | SLO 상태가 정상으로 돌아온 평가 시각 |
| 유예 시간 안에 SLO 를 다시 위반 | 같은 인시던트가 이어집니다. 새 인시던트가 열리지 않고, 통보도 나가지 않습니다. 다음에 정상으로 돌아오면 그때부터 다시 셉니다. 심각도가 바뀌면 심각도만 바꾸고 통보합니다. |
| 유예 시간 동안 SLO 가 계속 정상 | 인시던트를 해결하고 해결 통보를 보냅니다. |
| 기록되는 해결 시각 | SLO 상태가 정상으로 돌아온 시각 |
- 유예 중에는 SLO 상태가 정상이어도 목록에 해결안됨으로 남습니다. 그래서 해결 통보는 SLO 가 정상이 되고 유예 시간이 지난 뒤에 받습니다.
- 유예 중에 데이터가 없어 SLO 상태를 판정할 수 없게 되어도, 유예 시간이 지나면 인시던트를 해결합니다.
- 아래 "없어진 워크로드의 인시던트" 의 자동 해결에는 이 유예를 적용하지 않습니다.
유예 시간은 프로젝트마다 하나이며, 설정 > 알림채널 연결 탭의 인시던트 해결 유예 카드에서 바꿉니다. 자세한 내용은 설정 의 "인시던트 해결 유예" 절을 참고합니다. 이 값은 알림 규칙의 해결 유예 시간 (초) 와 다른 설정입니다. 두 설정의 차이는 아래 "타이밍: 경보 대기 시간과 해결 유예 시간" 절에 있습니다.
없어진 워크로드의 인시던트는 자동으로 해결됩니다
Kubernetes 에서 Deployment·StatefulSet·DaemonSet 을 삭제하면, 그 애플리케이션의 인시던트는 최대 약 1시간 뒤 자동으로 해결됨이 됩니다. 삭제한 직후에는 최근 1시간의 수집 데이터에 그 애플리케이션이 남아 있기 때문에 바로 해결되지 않습니다.
- 자동으로 해결될 때는 알림채널(Slack·MS Teams·이메일·Webhook)로 해결 알림을 보내지 않습니다.
- 같은 이름으로 다시 배포한 뒤 다시 문제가 생기면, 새 인시던트가 열립니다.
- 한 클러스터의 수집이 1시간 넘게 끊기면, 그 클러스터 워크로드의 인시던트가 알림 없이 해결될 수 있습니다.
다음 인시던트는 자동으로 해결되지 않습니다.
| 경우 | 결과 |
|---|---|
| 외부 서비스(ExternalService)의 호출이 끊김 | 해결안됨으로 남습니다. |
| 파드는 실행 중이지만 요청이 없는 애플리케이션 | 해결안됨으로 남습니다. 아래 기준에 따라 목록에서 지워집니다. |
참고: 인시던트 목록에는 수동 해결 메뉴가 없습니다. 수동 해결은 알림 메뉴의 알림에서만 할 수 있습니다.
오래된 인시던트는 자동으로 지워집니다
서버는 하루에 한 번 오래된 인시던트를 지웁니다. 기준은 서버의 메트릭 캐시 저장기간(cache-ttl, 기본 60일)입니다.
인시던트 상세 화면의 그래프가 이 데이터로 그려지기 때문입니다.
| 인시던트 상태 | 열린 지 (저장기간 - 1일)이 지나면 |
|---|---|
| 해결됨 | 지웁니다. |
| 해결안됨, 애플리케이션이 지금도 오류 중 | 남깁니다. |
| 해결안됨, 요청이 없어 판단할 수 없거나 애플리케이션이 없음 | 지웁니다. |
기본 설정(저장기간 60일)에서는 열린 지 약 59일이 지난 인시던트를 지웁니다. 저장기간이 1일 이하이면 인시던트를 지우지 않습니다. 남긴 인시던트의 상세 화면은 최근 6시간 데이터로 표시됩니다. 아래 오래된 인시던트의 상세 화면 절을 참고합니다.
알림 이력은 다른 기준을 씁니다. 해결된 알림은 해결된 지 (저장기간 + 2일)이 지나면 지웁니다. 해결되지 않은 알림은 지우지 않습니다.
참고: 알림채널 메시지의 링크로 지워진 인시던트를 열면, 화면에 "failed to get incident" 가 나오고 인시던트 목록으로 돌아갑니다.
저장기간을 늘리려면 서버의 캐시 저장기간 설정(cache-ttl, 환경 변수 CACHE_TTL)을 늘립니다. 이 값은 화면에서 바꿀 수 없습니다.
저장기간을 늘리면 그만큼 메트릭 저장 공간도 더 필요합니다.
애플리케이션 필터

페이지 우측 상단의 애플리케이션 필터를 사용해 특정 애플리케이션 또는 네임스페이스(Namespace)의 인시던트만 표시할 수 있습니다. 인시던트 ID나 키워드를 검색하여 특정 인시던트를 빠르게 찾을 수도 있습니다.
인시던트 목록 테이블
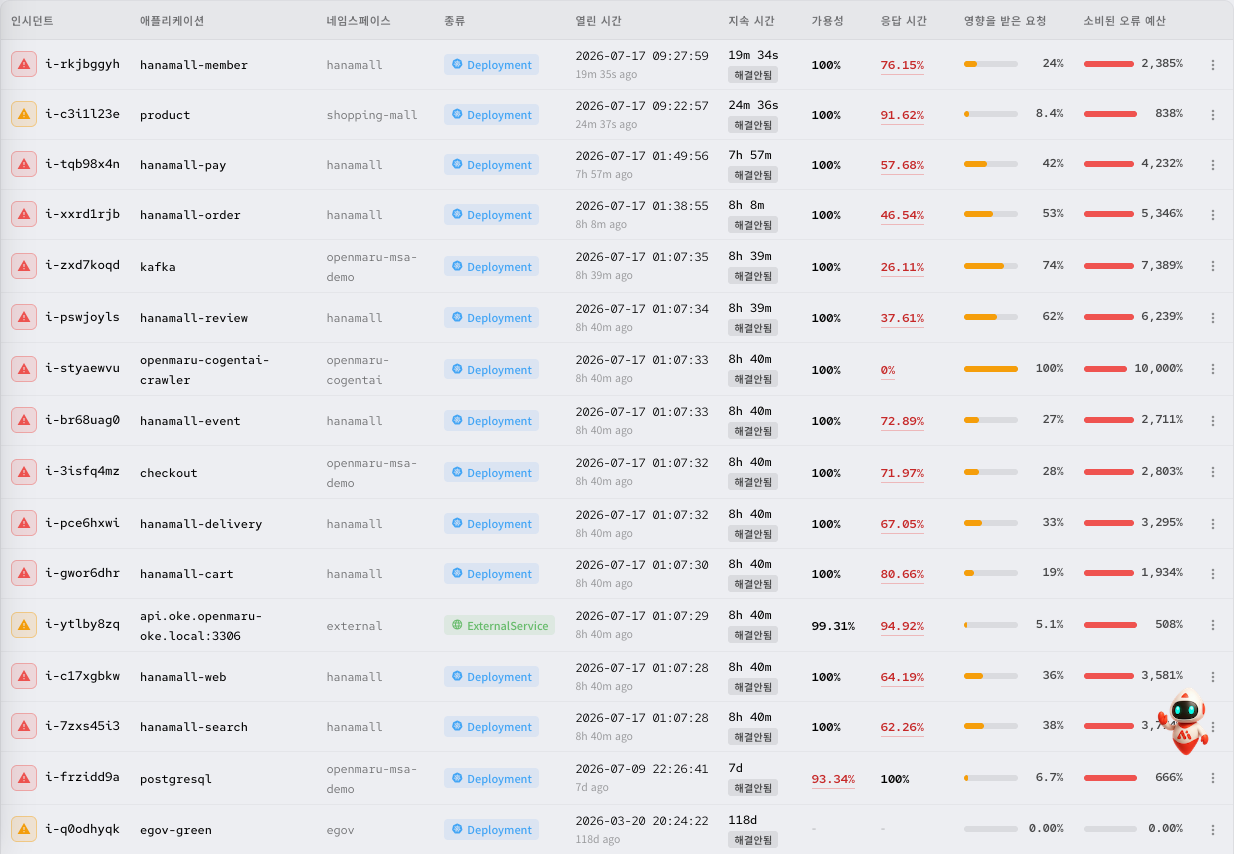
인시던트 목록 테이블에는 다음 정보가 표시됩니다.
| 컬럼 | 설명 |
|---|---|
| 인시던트 | 인시던트 ID (예: i-123). 심각도에 따라 색상이 다르게 표시됩니다. |
| 애플리케이션 | 인시던트가 발생한 애플리케이션 이름 |
| 네임스페이스 | 애플리케이션이 속한 네임스페이스(Namespace) |
| 종류(Kind) | Kubernetes 워크로드 종류 (예: Deployment, StatefulSet) 또는 외부 서비스(ExternalService) |
| 열린 시간 | 인시던트 최초 감지 시각 및 경과 시간 |
| 지속 시간 | 인시던트 지속 시간. 진행 중이면 해결안됨, 종료되었으면 해결됨 배지 표시 |
| 가용성 | 가용성(Availability) SLO 준수율. SLO를 위반한 경우 빨간색으로 강조 표시됩니다. |
| 응답 시간 | 응답 시간(Latency) SLO 준수율. SLO를 위반한 경우 빨간색으로 강조 표시됩니다. |
| 영향을 받은 요청 | 인시던트로 영향받은 요청 비율(막대 그래프) |
| 소비된 오류 예산 | 오류 예산(Error Budget) 소비율(막대 그래프). 100% 초과 시 빨간색으로 표시됩니다. |
참고: 가용성, 응답 시간, 영향을 받은 요청, 소비된 오류 예산 값은 인시던트 데이터를 추가 분석한 후 표시되므로, 로딩 중에는 스피너가 표시될 수 있습니다.
컬럼 헤더를 클릭하면 해당 컬럼 기준으로 오름차순/내림차순 정렬이 가능합니다.
SLO 조정
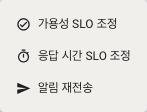
각 인시던트 행의 오른쪽 끝에 있는 더보기(...) 버튼을 클릭하면 해당 애플리케이션의 SLO 임계값을 빠르게 조정할 수 있습니다.
- 가용성 SLO 조정: 가용성(Availability) SLO 임계값 수정
- 응답 시간 SLO 조정: 응답 시간(Latency) SLO 임계값 수정
- 알림 재전송: 미해결 인시던트에 한해 알림을 다시 전송합니다(미해결 상태일 때만 표시).
참고: SLO 임계값 조정은 해당 애플리케이션에만 적용됩니다. 전체 기본값 변경은 설정 > 검사 조건 설정에서 할 수 있습니다.
인시던트 상세
인시던트 목록에서 인시던트 ID 또는 애플리케이션 이름을 클릭하면 해당 인시던트의 상세 페이지로 이동합니다.
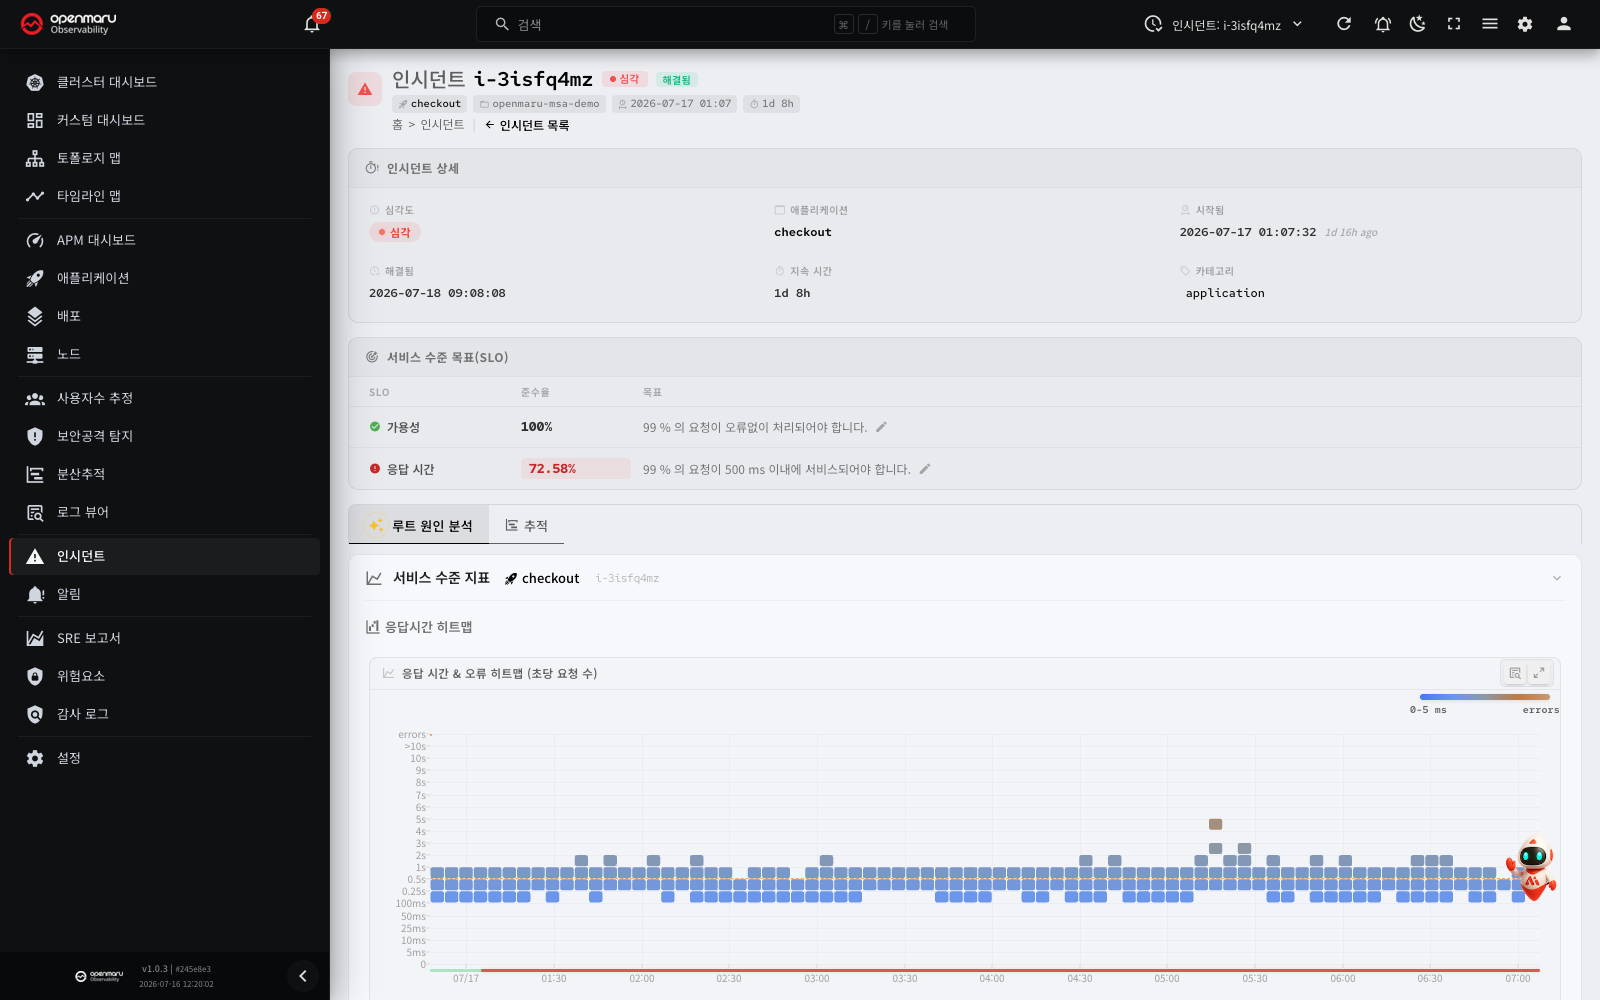
헤더 정보

상세 페이지 상단에는 다음 정보가 표시됩니다.
- 인시던트 ID:
i-접두사가 붙은 고유 식별자 - 심각도 배지: 심각 또는 경고
- 상태 배지: 진행 중이면 아직 지속되고 있음, 종료되었으면 해결됨
- 메타 정보: 애플리케이션 이름, 네임스페이스, 시작 시간, 지속 시간
인시던트 목록 링크를 클릭하면 인시던트 목록 페이지로 돌아갑니다.
오래된 인시던트의 상세 화면
열린 시각의 데이터가 저장기간을 지난 인시던트도, 애플리케이션이 지금 오류 중이면 목록에 남습니다. 이 인시던트의 상세 화면 상단에는 다음 안내가 나옵니다.
"2026-07-21 13:53부터 계속 오류 중입니다. 열린 시각의 데이터는 저장기간이 지나 볼 수 없어, 그래프와 영향을 받은 요청·소비된 오류 예산은 최근 6시간 기준으로 표시합니다."
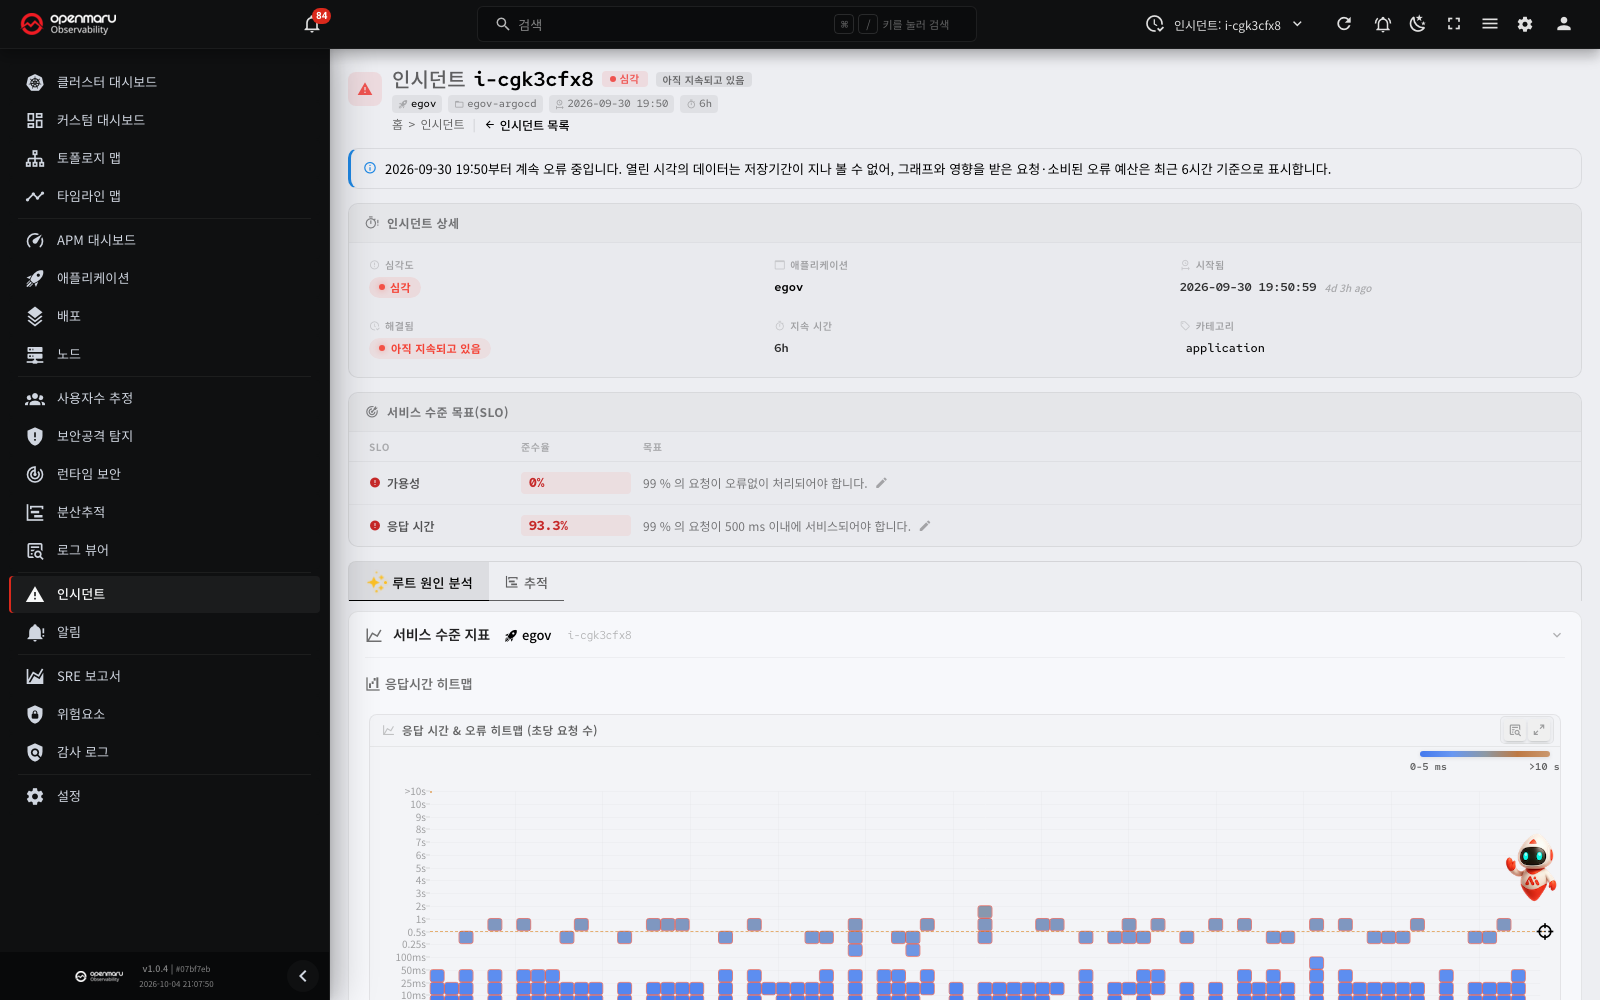
| 항목 | 표시 기준 |
|---|---|
| 목록의 열린 시간·지속 시간, 상세의 시작 시간 | 원래 열린 시각 |
| 그래프(SLO 히트맵 포함), 루트 원인 분석 탭 | 최근 6시간 |
| 가용성·응답 시간·영향을 받은 요청·소비된 오류 예산 (목록과 상세) | 최근 6시간 |
같은 안내는 타임라인 맵에서 여는 인시던트 창에도 나옵니다.
인시던트 상세 정보
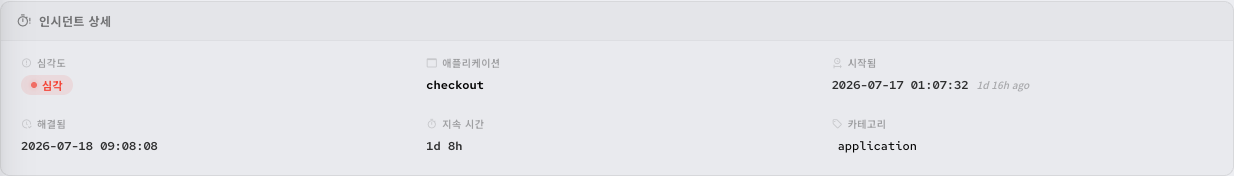
인시던트 상세 섹션에서는 인시던트의 기본 속성을 그리드 형태로 확인할 수 있습니다.
| 항목 | 설명 |
|---|---|
| 심각도 | 심각 또는 경고. 색상 배지로 표시됩니다. |
| 애플리케이션 | 영향받은 애플리케이션. 클릭 시 해당 애플리케이션의 상세 다이얼로그가 열립니다. |
| 시작됨 | 인시던트 최초 감지 시각 및 경과 시간 |
| 해결됨 | 해결 시각 또는 아직 지속되고 있음 상태 표시 |
| 지속 시간 | 총 인시던트 지속 시간 |
| 카테고리 | 애플리케이션 카테고리. 클릭 시 해당 애플리케이션 상세 페이지로 이동합니다. |
서비스 수준 목표(SLO) 섹션
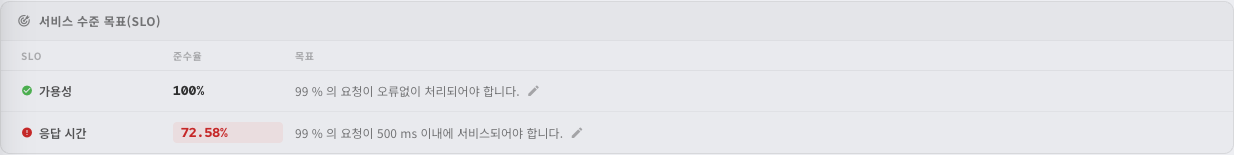
서비스 수준 목표(SLO) 섹션에서는 인시던트가 발생한 SLO 항목을 확인할 수 있습니다. 테이블 형식으로 다음 정보가 표시됩니다.
| 열 | 설명 |
|---|---|
| SLO | SLO 항목 이름(가용성 또는 응답 시간). 위반 여부에 따라 녹색 체크 또는 빨간색 경고 아이콘이 표시됩니다. |
| 준수율 | 실제 SLO 준수율. 위반된 경우 빨간색으로 강조 표시됩니다. |
| 목표 | SLO 목표 조건 (예: "99 % 의 요청이 500 ms 이내에 서비스되어야 합니다."). 연필 아이콘을 클릭하면 SLO 임계값을 직접 수정할 수 있습니다. |
분석 탭

인시던트 상세 페이지 하단에는 두 가지 분석 탭이 제공됩니다.
| 탭 | 설명 |
|---|---|
| 루트 원인 분석(RCA) | 인시던트 원인을 시스템이 자동 분석한 결과. 기본 선택 탭입니다. |
| 추적 | 인시던트 발생 시간대의 추적(Trace) 데이터 |
RCA(근본원인분석) 탭
RCA(Root Cause Analysis, 근본원인분석) 탭은 인시던트 상세 페이지에서 기본으로 선택되는 탭으로, 인시던트 발생 원인을 시스템이 자동으로 분석한 결과를 보여줍니다. 이 탭은 다음 다섯 가지 섹션으로 구성되며, 근본원인분석 요약을 제외한 SLI·전파 경로·인과 타임라인·상세 보고서 네 개 섹션은 접기/펼치기가 가능합니다.
1. 서비스 수준 지표(SLI) 섹션
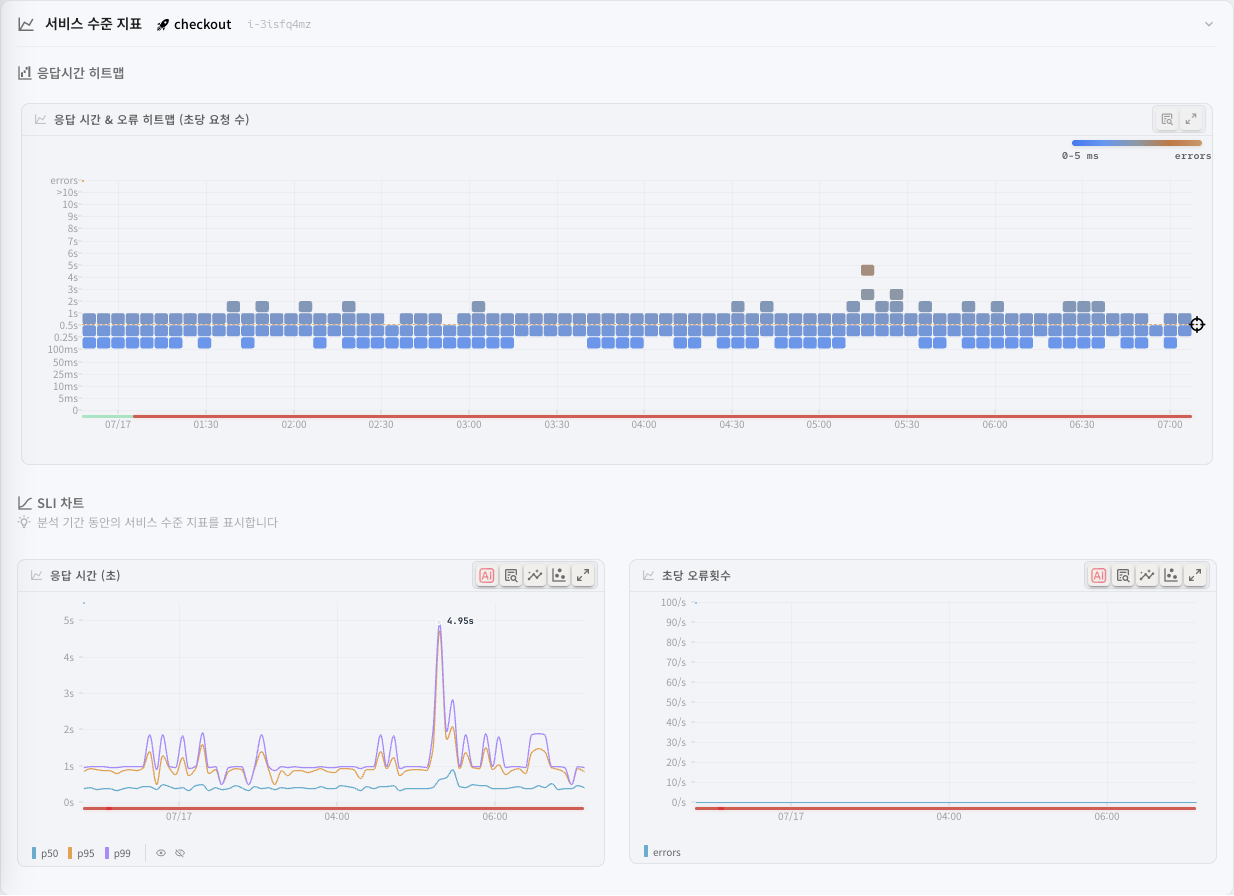
SLI(Service Level Indicator, 서비스 수준 지표) 섹션에서는 인시던트 분석 기간 동안의 서비스 상태를 차트로 확인할 수 있습니다. 섹션 헤더에는 대상 애플리케이션 이름과 인시던트 ID가 표시됩니다.
이 섹션에는 다음 두 가지 하위 영역이 포함됩니다.
응답시간 히트맵
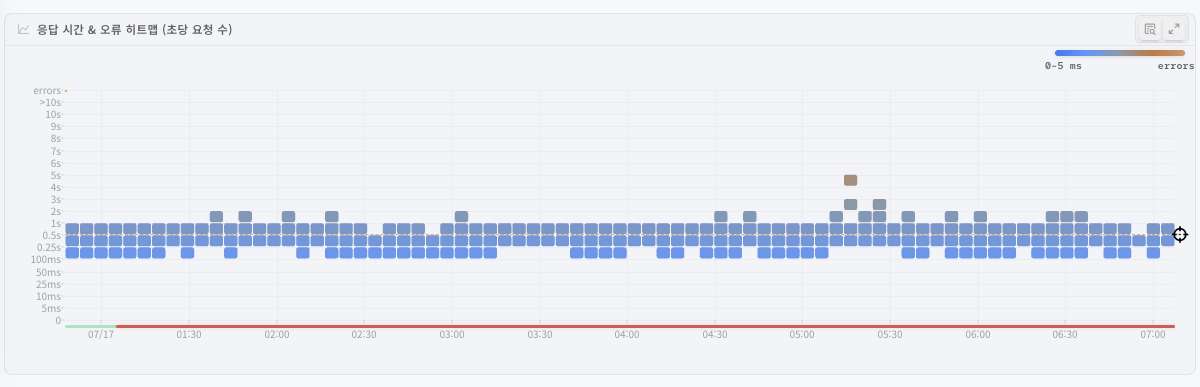
인시던트 기간의 응답 시간 분포를 히트맵(Heatmap)으로 시각화합니다. X축은 시간, Y축은 응답 시간, 색상 농도는 해당 구간의 요청 밀도를 나타냅니다.
히트맵은 애플리케이션이 받은 요청만 그립니다. SLO 준수율을 계산하는 데이터와 같습니다. 애플리케이션이 보낸 호출(예: DB 쿼리)은 분산추적 탭의 발신 요청만 필터로 확인합니다.
칸 하나의 시간 폭은 조회 기간에 따라 다음과 같이 정해집니다.
| 조회 기간 | 칸 시간 폭 |
|---|---|
| 1시간 이하 | 15초 |
| 1시간 초과 | 1분 |
| 6시간 초과 | 5분 |
조회 기간은 인시던트 시작 20분 전부터 시작하고, 길어도 인시던트 시작 6시간 뒤에 끝납니다. 그래서 조회 기간은 최대 약 6시간 20분이고, 칸 시간 폭은 위 세 가지 중 하나입니다.
히트맵에서 영역을 드래그하면 애플리케이션 상세 다이얼로그의 분산추적 탭이 수신 요청만 필터로 열립니다. 선택 범위는 첫 칸의 시작부터 마지막 칸의 끝까지입니다. 헬스체크처럼 짧게 끝나는 받은 요청도 수신 요청만 필터에 나옵니다.
SLI 차트
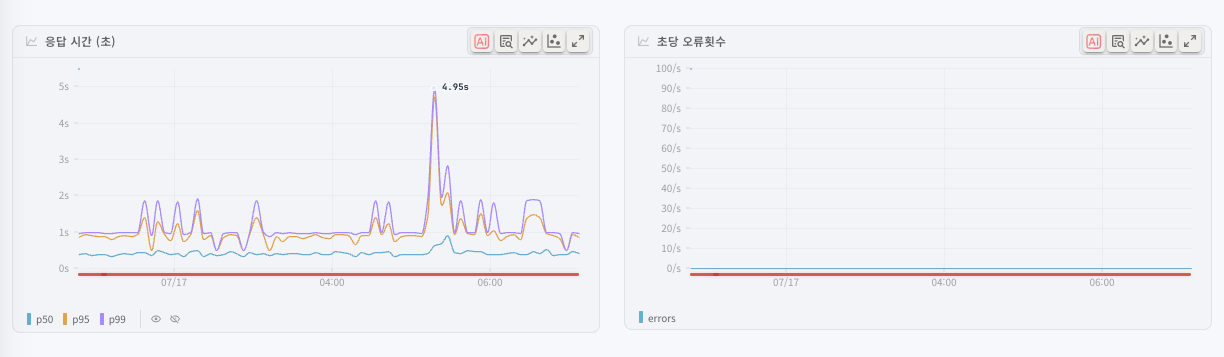
응답 시간 차트와 오류율 차트가 나란히 표시되어, 인시던트 분석 기간 동안 서비스의 성능 변화 추이를 확인할 수 있습니다.
- 응답 시간 (초) 차트: 분석 기간 동안의 요청 응답 시간 추이
- 초당 오류횟수 차트: 분석 기간 동안의 오류 발생 추이
차트 하단에는 분석 기간 동안의 SLI를 표시한다는 안내 메시지가 표시됩니다.
팁: SLI 차트에서 특정 구간을 드래그하여 선택하면 해당 구간에 대한 상세 분석(해당 시간 범위에 국한된 RCA)을 수행할 수 있습니다. 선택한 구간은 차트에 하이라이트로 표시됩니다.
2. 근본 원인 분석 요약
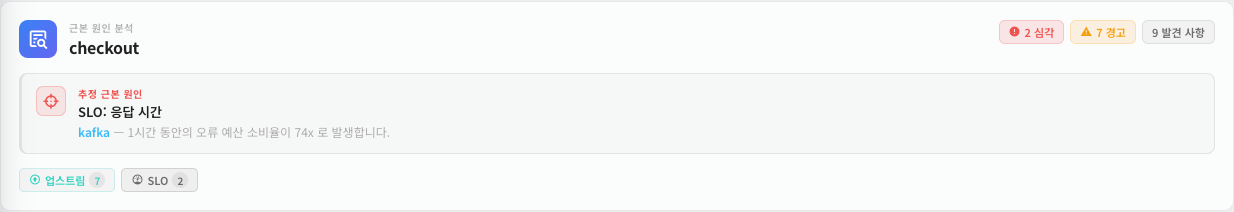
근본 원인 분석 카드에 시스템이 자동으로 분석한 인시던트 원인의 요약 정보가 표시됩니다. 이 섹션은 다음 세 부분으로 구성됩니다.
심각도별 발견 건수
카드 상단 우측에 발견된 원인 항목의 심각도별 개수가 배지로 표시됩니다.
| 배지 | 의미 |
|---|---|
| 심각 | 즉각 조치가 필요한 발견 항목 수 |
| 경고 | 주의가 필요한 발견 항목 수 |
| N 발견 사항 | 전체 발견 항목 수 |
추정 근본 원인

인시던트의 가장 가능성 높은 원인이 추정 근본 원인 강조 카드로 표시됩니다. 다음 정보가 포함됩니다.
- 원인 제목: 근본 원인으로 추정되는 항목 (예: 배포 변경, 리소스 포화, 업스트림 장애 등)
- 애플리케이션 이름: 근본 원인이 발생한 애플리케이션
- 상세 설명: 원인에 대한 추가 설명 (예: 특정 시각의 배포, 오류 발생 건수 등)
카테고리별 분류
발견된 원인이 다음 카테고리별로 분류되어 칩(chip) 형태로 표시됩니다. 각 칩에는 해당 카테고리의 발견 건수가 함께 표시됩니다.
| 카테고리 | 설명 |
|---|---|
| 배포 | 배포 변경사항 관련 원인 (새 버전 배포, 롤아웃 이벤트 등) |
| 업스트림 | 업스트림 서비스의 장애나 SLO 위반이 현재 서비스에 영향을 준 경우 |
| 리소스 | CPU, 메모리, 디스크 등 리소스 포화 관련 원인 |
| 로그 | 로그 이상 패턴 감지 관련 원인 |
| SLO | 다른 서비스의 SLO 위반이 연쇄적으로 영향을 미친 경우 |
| 데이터베이스 | 데이터베이스 관련 이슈 |
3. 이슈 전파 경로
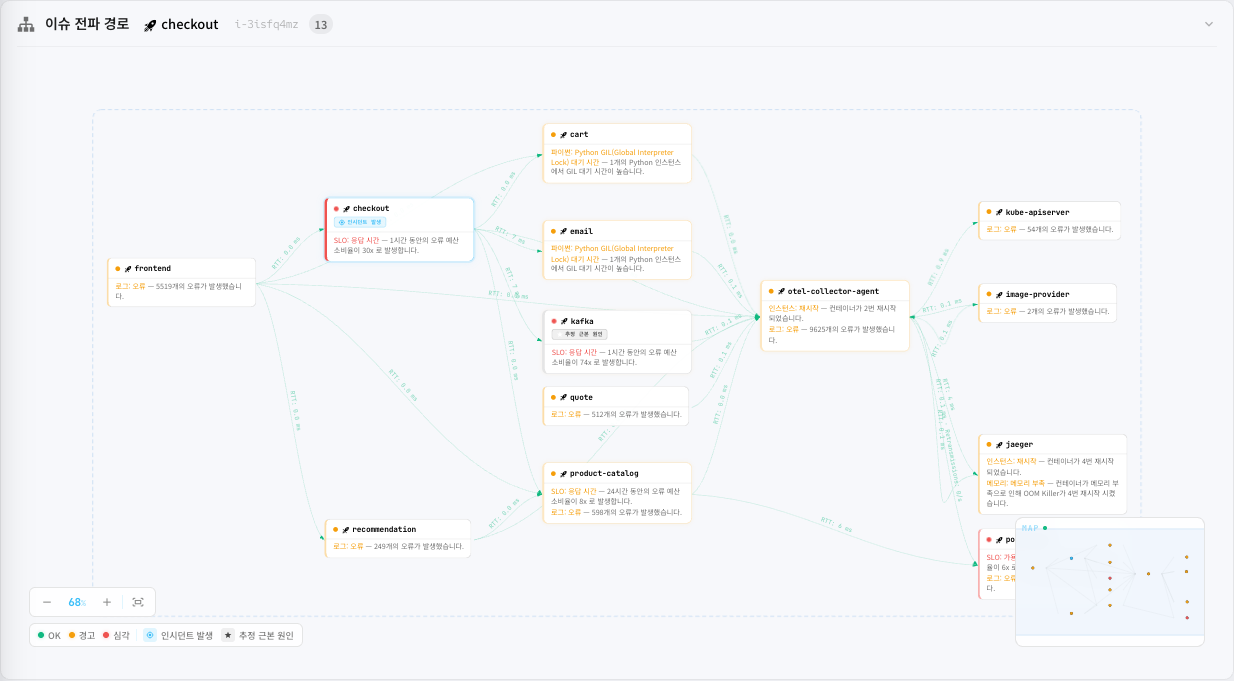
인시던트가 여러 애플리케이션에 걸쳐 영향을 미친 경우, 장애가 전파된 경로를 서비스 간 의존 관계 맵으로 시각적으로 보여줍니다. 섹션 헤더에는 관련 애플리케이션 수가 표시됩니다.
전파 경로 읽는 방법
- 노드(애플리케이션): 각 사각형은 하나의 애플리케이션을 나타냅니다. 노드의 테두리 색상은 해당 애플리케이션의 상태를 나타냅니다(빨간색: 심각, 노란색: 경고, 녹색: 정상).
- 화살표(연결선): 애플리케이션 간의 트래픽 방향을 나타냅니다. 화살표 색상은 해당 연결의 상태를 나타냅니다. 심각(Critical) 또는 경고(Warning) 상태의 연결에는 흐름 애니메이션이 표시됩니다.
- 인시던트 발생 표시: 인시던트가 발생한 애플리케이션(대상 애플리케이션)에는 조준점 아이콘이 표시됩니다.
- 근본 원인 표시: 근본 원인으로 추정되는 애플리케이션에는 별 아이콘이 표시됩니다.
- 인과 관계 경로: 근본 원인에서 인시던트 대상까지의 인과 관계 경로에 포함된 노드와 연결선이 강조 표시됩니다.
- 트래픽 통계: 연결선 위에 트래픽 통계 레이블이 표시됩니다. 특정 애플리케이션에 마우스를 올리면 해당 애플리케이션과 직접 연결된 서비스만 강조되고, 나머지는 흐려집니다.
팁: 애플리케이션 이름을 클릭하면 해당 애플리케이션의 상세 다이얼로그가 열려 메트릭, 로그, 분산추적 등을 추가로 분석할 수 있습니다.
참고: 맵 영역에서 마우스 휠로 확대/축소가 가능하고, 드래그로 화면을 이동할 수 있습니다. 빈 영역을 더블클릭하면 기본 위치로 복원됩니다.
4. 인과 타임라인
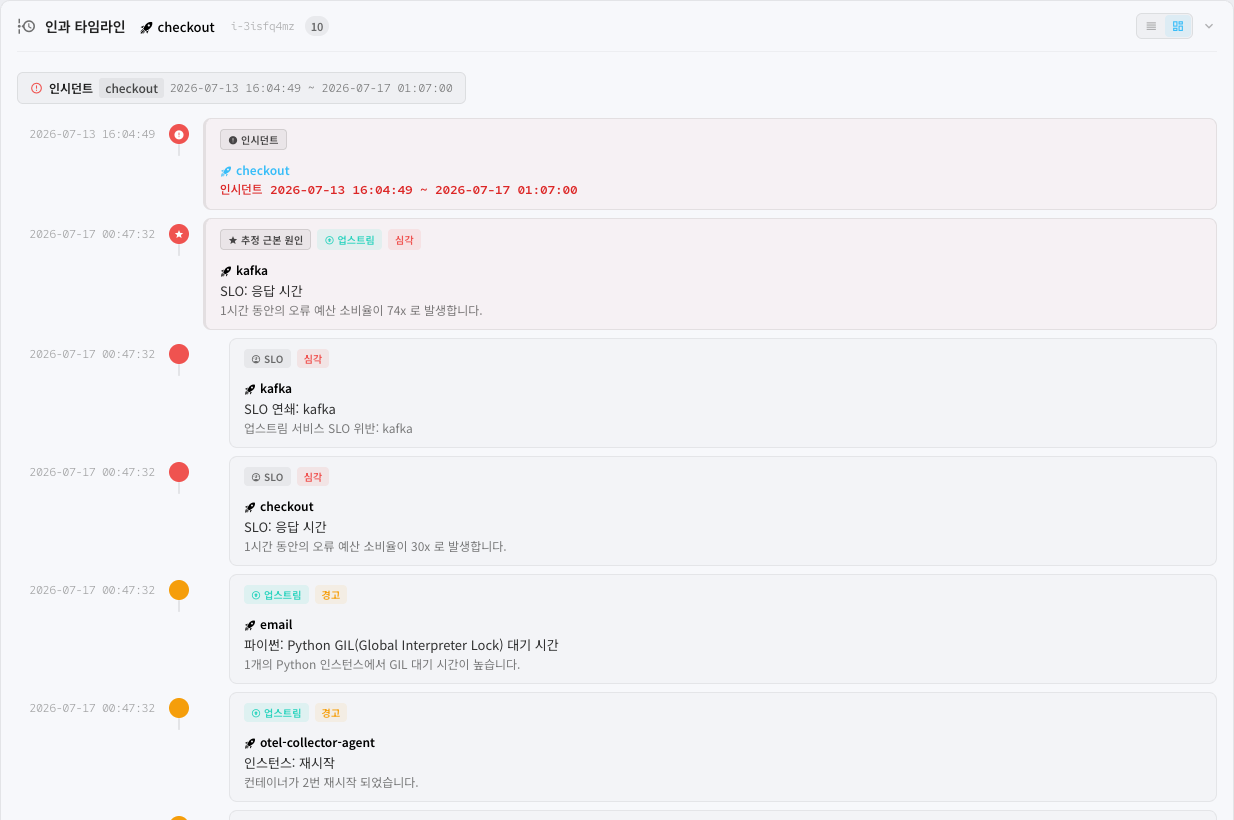
인시던트 발생 전후의 관련 이벤트를 시간 순서로 나열하여, 인시던트로 이어진 인과 관계를 파악할 수 있습니다. 섹션 헤더에는 이벤트 건수가 표시됩니다.
뷰 모드 전환
인과 타임라인은 두 가지 뷰 모드를 제공합니다. 섹션 헤더 우측의 버튼으로 전환할 수 있습니다.
간략 보기
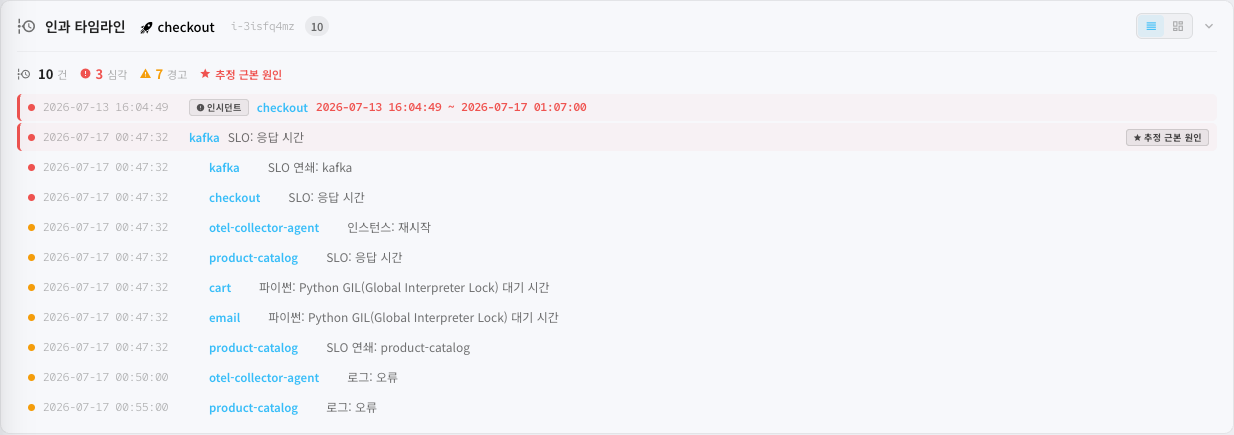
상단에 이벤트 요약 통계가 표시됩니다.
| 통계 항목 | 의미 |
|---|---|
| N 건 | 타임라인에 포함된 전체 이벤트 수 |
| 심각 | 심각 수준의 이벤트 수 |
| 경고 | 경고 수준의 이벤트 수 |
| 추정 근본 원인 | 근본 원인으로 추정된 이벤트 표시 |
통계 아래에 각 이벤트가 한 줄로 간결하게 나열됩니다. 각 행에는 시간, 심각도 점(dot), 애플리케이션 이름, 이벤트 제목이 표시됩니다. 근본 원인 이벤트에는 추정 근본 원인 배지가, 인시던트 시점에는 인시던트 배지가 표시됩니다.
전체 보기
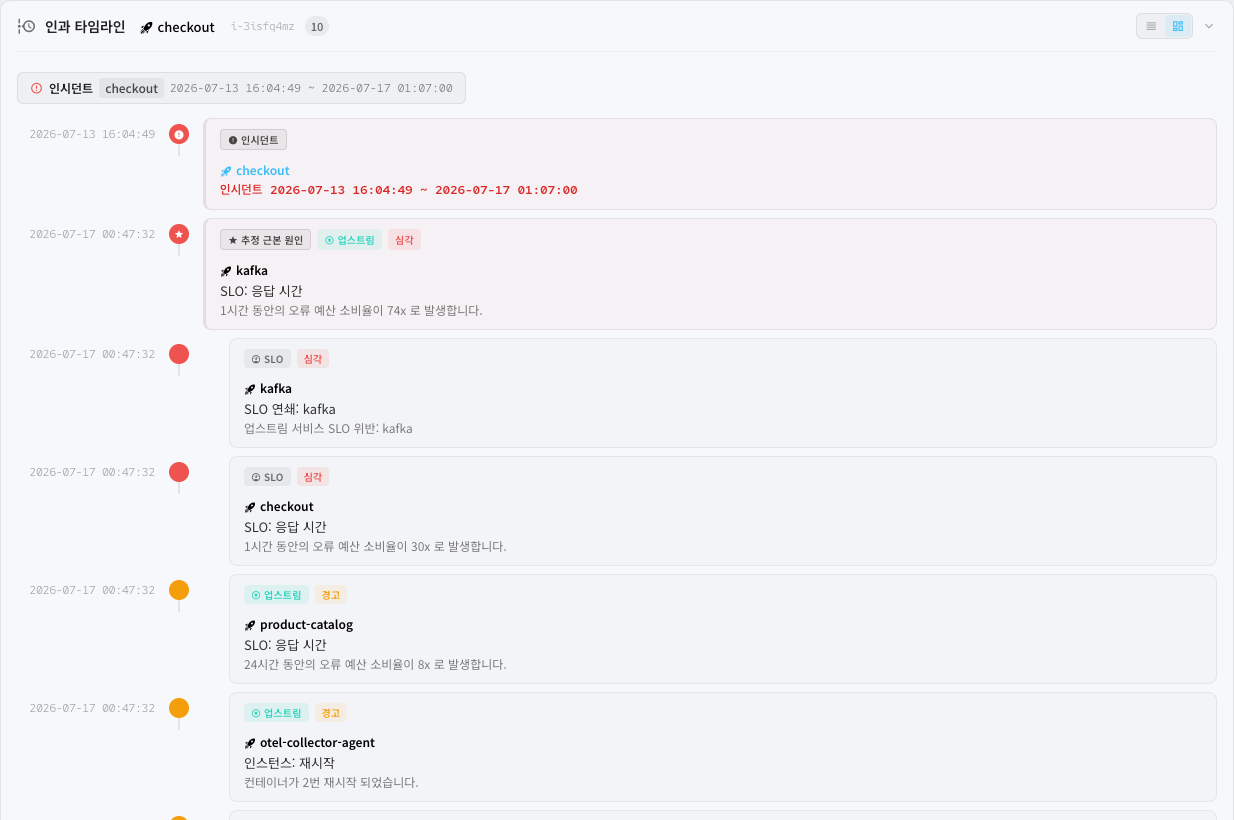
각 이벤트가 카드 형태로 상세하게 표시됩니다. 시간 축을 따라 세로로 나열되며, 각 이벤트 카드에는 다음 정보가 포함됩니다.
- 발생 시각: 이벤트가 감지된 시각
- 심각도 마커: 색상 원형 마커로 심각도 구분 (빨간색: 심각, 노란색: 경고, 녹색: 정보)
- 카테고리 칩: 이벤트의 원인 카테고리 (배포, 데이터베이스, 리소스, 업스트림, 로그, SLO)
- 심각도 칩: 이벤트의 심각도 수준
- 애플리케이션 링크: 관련 애플리케이션 이름 (클릭 시 상세 다이얼로그 열림)
- 이벤트 제목: 발견 항목의 제목 (예: "SLO: 가용성", "배포 변경사항: v2.1.0" 등)
- 상세 설명: 이벤트에 대한 추가 정보
근본 원인으로 추정된 이벤트 카드는 빨간색 좌측 테두리와 깜빡이는 효과로 강조 표시되며, 추정 근본 원인 배지가 표시됩니다.
인시던트 발생 시점은 별도의 인시던트 카드로 타임라인에 삽입되어, 인시던트 전후 이벤트를 시각적으로 구분할 수 있습니다. 인시던트가 아직 진행 중인 경우 종료 시각 대신 진행중 표시가 나타납니다.
팁: 인과 타임라인에서 근본 원인 이벤트의 시각과 인시던트 발생 시각을 비교하면, 원인과 결과 사이의 시간 간격을 파악할 수 있습니다.
5. 상세 RCA 보고서
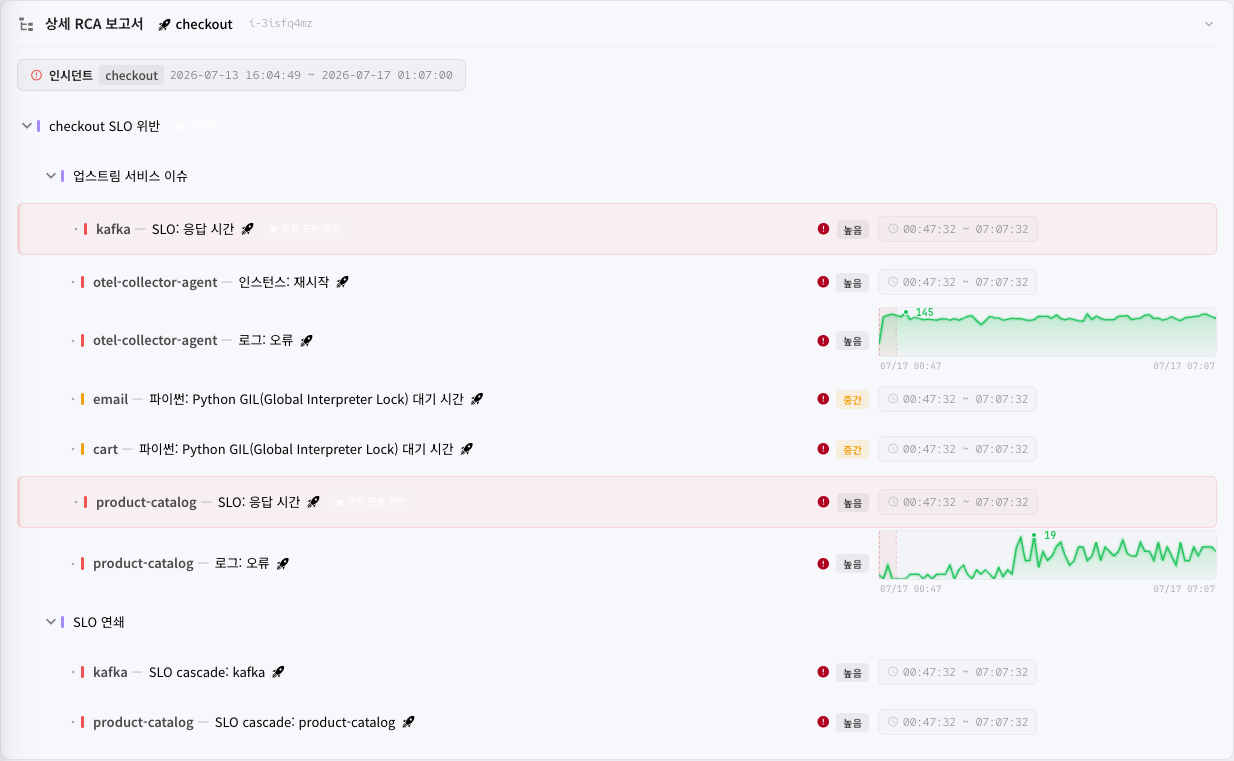
개별 원인 항목에 대한 분석 결과를 트리 구조로 확인할 수 있습니다. 이 섹션에서는 인시던트의 원인을 계층적으로 탐색할 수 있습니다.
인시던트 시간 범위 표시
상세 RCA 보고서 상단에는 인시던트 발생 시간 범위 바가 표시됩니다. 인시던트 대상 애플리케이션 이름과 인시던트 시작~종료 시각이 표시되며, 인시던트가 아직 진행 중인 경우 종료 시각 대신 진행중 표시가 나타납니다.
트리 구조 이해
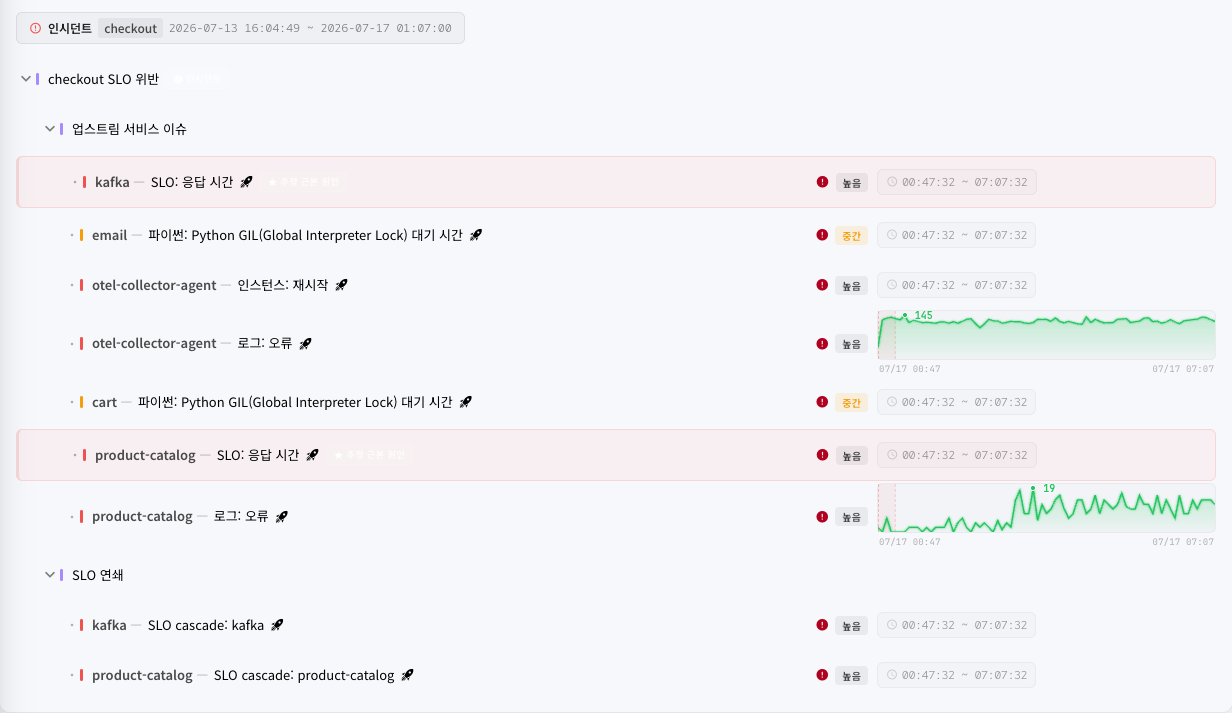
트리의 최상위 노드는 인시던트가 발생한 애플리케이션의 SLO 위반 상태를 나타냅니다. 이 아래로 원인 카테고리별 그룹 노드가 배치되고, 각 그룹 아래에 개별 발견 항목(finding) 노드가 위치합니다.
트리 노드 구성 요소
각 노드에는 다음 정보가 표시됩니다.
| 요소 | 설명 |
|---|---|
| 접기/펼치기 화살표 | 하위 노드가 있는 경우 클릭하여 접기/펼치기 가능 |
| 노드 이름 | 카테고리명 또는 발견 항목 제목 |
| 애플리케이션 링크 | 관련 애플리케이션으로 이동하는 아이콘 (클릭 시 상세 다이얼로그 열림) |
| 추정 근본 원인 배지 | 근본 원인으로 판단된 노드에 빨간색 배지 표시 |
| 인시던트 배지 | 인시던트 대상 노드에 표시 |
| 원인 가능성 아이콘 | 원인일 가능성이 있는 노드에 빨간색 경고 아이콘 표시 |
| 신뢰도 배지 | 원인의 신뢰도 수준 (높음/중간/낮음) |
| 스파크 차트 | 해당 항목의 시계열 데이터를 소형 꺾은선 차트로 시각화. 인시던트 발생 구간이 빨간색 음영으로 표시됩니다. |
| 시간 범위 | 이벤트가 발생한 시간 범위 |
카테고리 그룹 노드
트리에서 카테고리 그룹 노드는 발견된 원인을 유형별로 묶어 보여줍니다.
| 카테고리 | 설명 |
|---|---|
| 배포 변경사항 | 분석 기간 중 발생한 배포, 롤아웃 이벤트 |
| 업스트림 서비스 이슈 | 상위 서비스의 장애나 SLO 위반 |
| 리소스 포화 | CPU, 메모리, 디스크 등 인프라 리소스의 포화 상태 |
| 로그 이상 | 오류/경고 수준의 로그 패턴 급증 |
| SLO 연쇄 | 다른 서비스의 SLO 위반이 연쇄적으로 영향 |
| 데이터베이스 이슈 | 데이터베이스 응답 시간 저하, 연결 문제 등 |
발견 항목(Finding) 노드
최하위 노드인 발견 항목에는 구체적인 원인 정보가 포함됩니다.
- 애플리케이션 이름: 원인이 발생한 애플리케이션
- 리포트 카테고리: 관련 리포트 영역 (예: SLO, CPU, 메모리, 네트워크 등)
- 검사 항목: 임계값을 초과한 검사 조건 항목명
- 스파크 차트: 해당 메트릭의 시계열 추이. 차트 위에 마우스를 올리면 해당 시점의 값과 시각이 툴팁으로 표시됩니다.
각 발견 항목의 스파크 차트에서도 인시던트 발생 구간이 빨간색 음영과 점선으로 표시되어, 원인 이벤트와 인시던트 발생 시점의 상관관계를 시각적으로 확인할 수 있습니다.
노드 상세 정보 확인
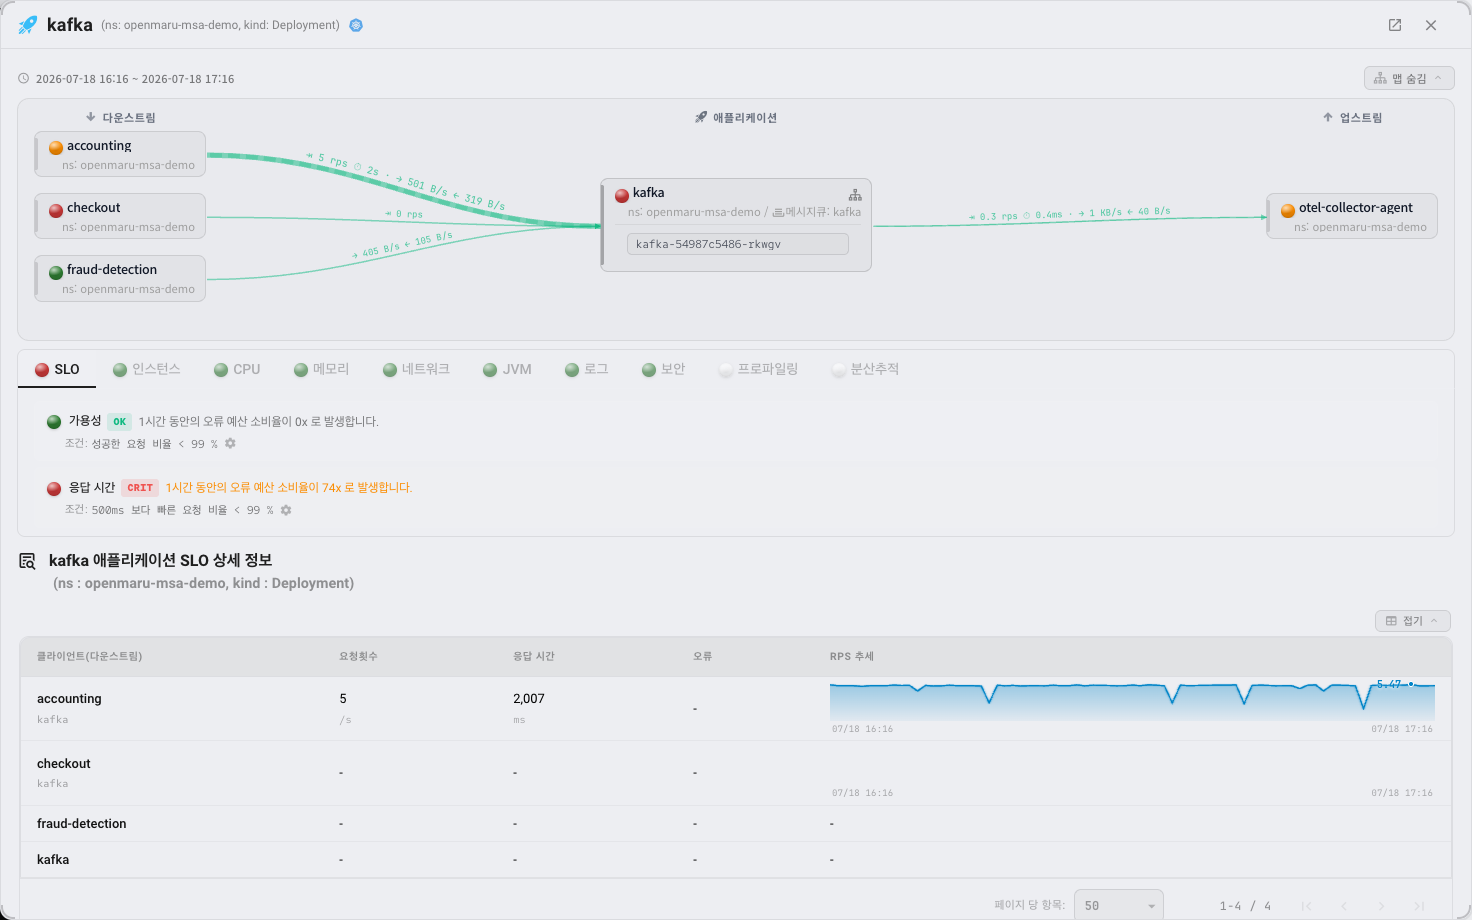
발견 항목 노드를 클릭하면 상세 다이얼로그가 열립니다. 다이얼로그에서 제공하는 정보는 원인 유형에 따라 다릅니다.
로그 패턴 상세
로그 이상 카테고리의 발견 항목을 클릭하면 다음 정보가 포함된 로그 패턴 다이얼로그가 열립니다.
- 심각도: 로그 레벨 (Critical, Error, Warning, Info, Debug)
- N events: 해당 로그 패턴의 총 발생 횟수
- 시계열 차트: 로그 패턴 발생 추이 차트
- Sample: 해당 로그 패턴에 해당하는 실제 로그 메시지 샘플
다이얼로그 하단의 메시지 보기 버튼을 클릭하면 해당 애플리케이션의 로그 탭에서 동일 패턴의 전체 로그 메시지를 확인할 수 있습니다.
메트릭 상세
리소스, SLO 등 메트릭 기반 발견 항목을 클릭하면 해당 메트릭의 상세 위젯(차트)이 다이얼로그로 표시됩니다. 인시던트 전후 기간의 메트릭 변화를 시각적으로 비교할 수 있습니다.
추적(분산추적) 탭
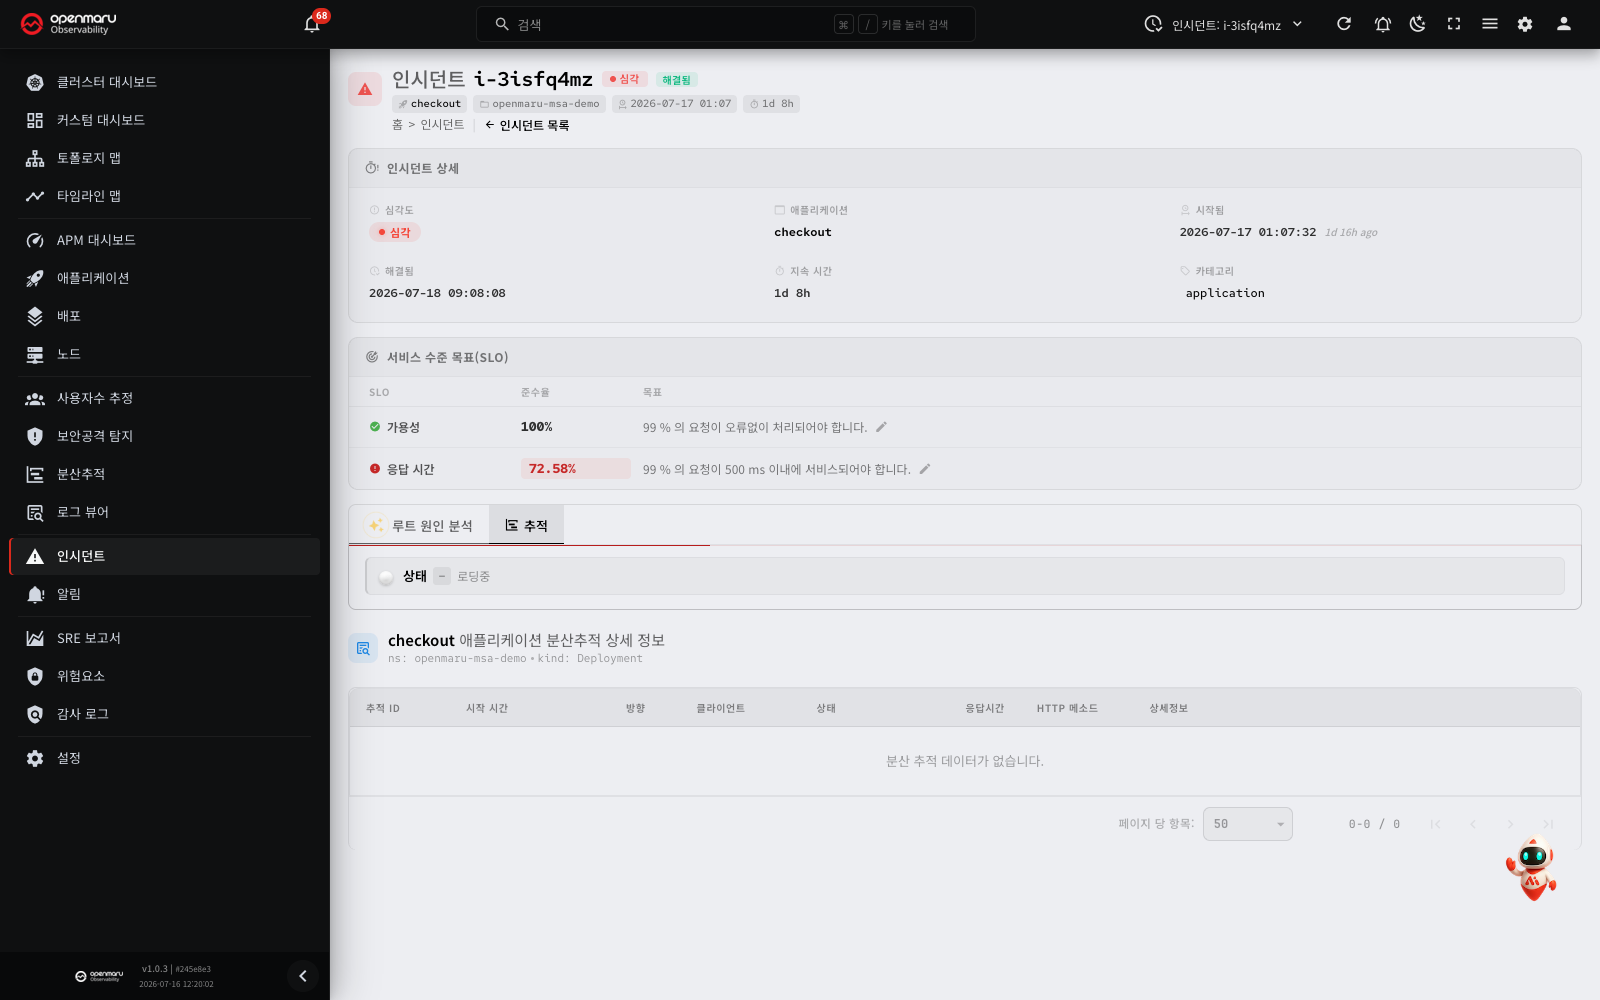
인시던트 상세의 추적 탭에서는 인시던트 발생 시간대의 추적(Trace) 데이터를 확인할 수 있습니다. 인시던트가 발생한 애플리케이션에 대해 인시던트 시간 범위로 자동 필터링된 추적 히트맵과 추적 목록이 표시됩니다.
응답 시간 SLO가 설정된 경우, 해당 임계값을 초과한 추적(Trace)이 자동으로 필터링되어 표시됩니다. 특정 추적을 클릭하면 스팬(Span) 상세 정보를 확인할 수 있습니다.
팁: 추적 탭에서 응답 시간이 급증한 추적(Trace)을 분석하면, RCA에서 추정한 근본 원인을 실제 요청 흐름 수준에서 검증할 수 있습니다.
인시던트 조사 워크플로
인시던트를 효과적으로 조사하려면 다음 단계를 따릅니다.
- 인시던트 목록에서 현황 파악: 상태 요약 스트립에서 심각·경고 인시던트 개수를 확인합니다.
- 대상 인시던트 선택: 심각도 필터 또는 애플리케이션 필터를 사용하여 조사할 인시던트를 선택합니다.
- SLO 위반 내역 확인: 인시던트 상세 페이지에서 가용성(Availability)과 응답 시간(Latency) SLO의 준수율을 확인합니다.
- RCA 요약으로 원인 파악: RCA 탭의 근본원인분석 요약에서 추정 근본 원인과 카테고리별 분류를 확인합니다.
- 전파 경로 분석: 이슈 전파 경로에서 장애가 어떤 서비스에서 시작되어 어디로 전파되었는지 확인합니다.
- 인과 타임라인 검토: 인과 타임라인에서 근본 원인 이벤트와 인시던트 발생 사이의 시간 관계를 파악합니다.
- 상세 분석: 필요에 따라 상세 RCA 보고서에서 개별 원인을 트리 구조로 탐색하거나, 분산추적 탭에서 실제 요청 흐름을 분석합니다.
- 애플리케이션 상세로 이동: 애플리케이션 링크를 클릭하여 관련 메트릭, 로그, 분산추적을 추가로 분석합니다.
알림(Alerts) 메뉴
좌측 사이드바의 인시던트 바로 아래에 알림 메뉴가 있습니다. 인시던트(Incident)가 SLO 위반·이상 탐지로 자동 생성되는 상위 이벤트라면, 알림(Alert)은 개별 검사 항목이나 사용자가 정의한 알림 규칙이 발화(firing)했을 때 생성되는 통지입니다. 알림 메뉴에서는 발화된 알림 목록을 조회하고 해결·일시 중지하거나, 알림을 발생시키는 규칙 자체를 관리합니다.
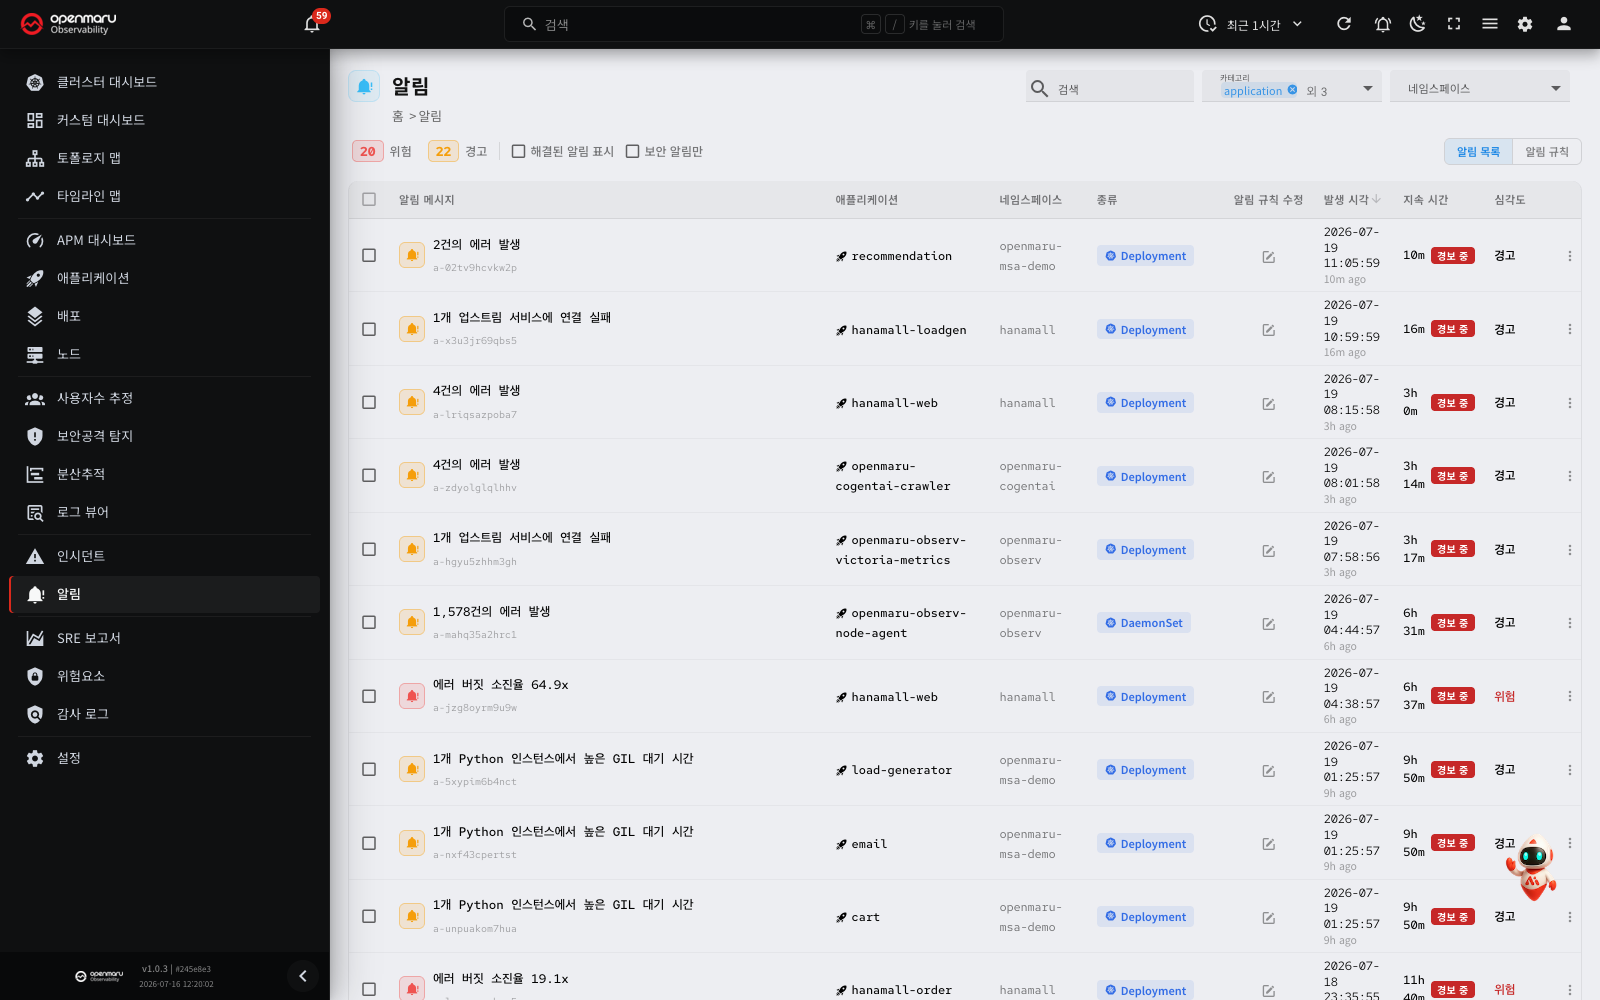
화면은 상단 탭으로 알림 목록과 알림 규칙 두 가지로 나뉩니다.
알림 목록 탭
발화 중이거나 해결된 알림을 표 형태로 보여줍니다.
- 상태 요약 카운터: 상단 좌측에 심각도별(위험/경고) 발화 건수가 표시되며, 클릭하면 해당 심각도만 필터링됩니다.
- 해결된 알림 표시: 기본적으로 발화 중(firing)인 알림만 표시되며, 토글을 켜면 해결된 알림도 함께 표시됩니다.
- 보안 알림만: 보안 공격 탐지로 생성된 알림만 필터링합니다.
- 애플리케이션 필터: 우측 상단의 카테고리·네임스페이스 필터로 특정 앱 그룹의 알림만 조회할 수 있습니다.
목록 테이블의 각 컬럼은 다음과 같습니다.
| 컬럼 | 설명 |
|---|---|
| 알림 메시지 | 알림 요약과 알림 ID(a-...). 앞의 아이콘이 상태를 나타냅니다: 경보 중(mdi-bell-alert), 해결됨(✓ mdi-check-circle), 일시 중지(mdi-bell-off) |
| 애플리케이션 | 알림이 발생한 애플리케이션. 클릭하면 앱 상세로 이동 |
| 네임스페이스 | 애플리케이션이 속한 네임스페이스 |
| 종류 | 워크로드 종류(Deployment, DaemonSet, StatefulSet 등) |
| 알림 규칙 수정 | 이 알림을 발생시킨 규칙의 편집 아이콘. 클릭하면 규칙 편집 화면으로 이동 |
| 발생 시각 | 알림이 최초 발화한 시각과 경과 시간 |
| 지속 시간 | 발화 이후 지속된 시간과 현재 상태(경보 중/해결됨) |
| 심각도 | 경고 또는 위험 |
체크박스로 여러 알림을 선택하면 상단에 일괄 작업 바가 나타나며, 선택한 알림을 한 번에 해결·일시 중지·다시 열기할 수 있습니다.
알림 상세
알림 행을 클릭하면 상세 다이얼로그가 열립니다.
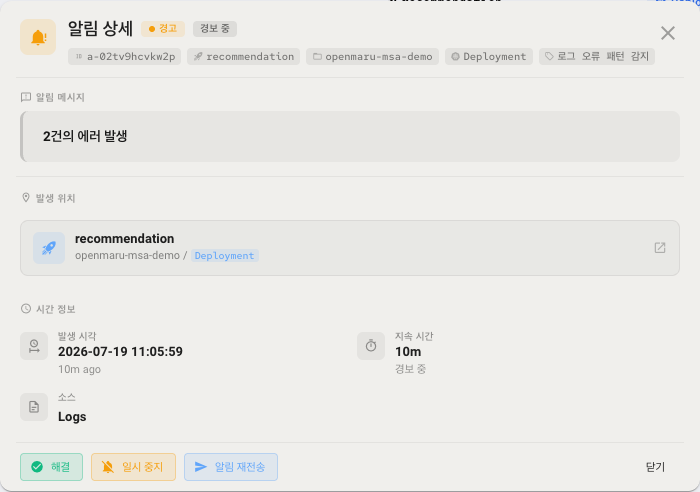
- 헤더: 심각도 배지와 현재 상태(경보 중/해결됨/일시 중지)
- 태그: 알림 ID, 애플리케이션, 네임스페이스, 워크로드 종류, 알림 규칙명
- 알림 메시지: 발화 조건에 대한 사람이 읽을 수 있는 요약
- 발생 위치: 알림이 걸린 애플리케이션(링크 클릭 시 앱 상세로 이동)
- 시간 정보: 발생 시각, 지속 시간, 소스(예:
Logs,SLO). 해결된 알림에는 해결 시각도 표시됩니다. - 액션 버튼: 해결(수동 해결), 일시 중지(지정 시간 동안 알림 억제), 알림 재전송(현재 발화 중인 알림을 Slack/Teams 등 외부 채널과 화면 토스트로 다시 전송)
알림 규칙 탭
상단 탭에서 알림 규칙을 클릭하면 알림을 발생시키는 규칙 목록이 표시됩니다.
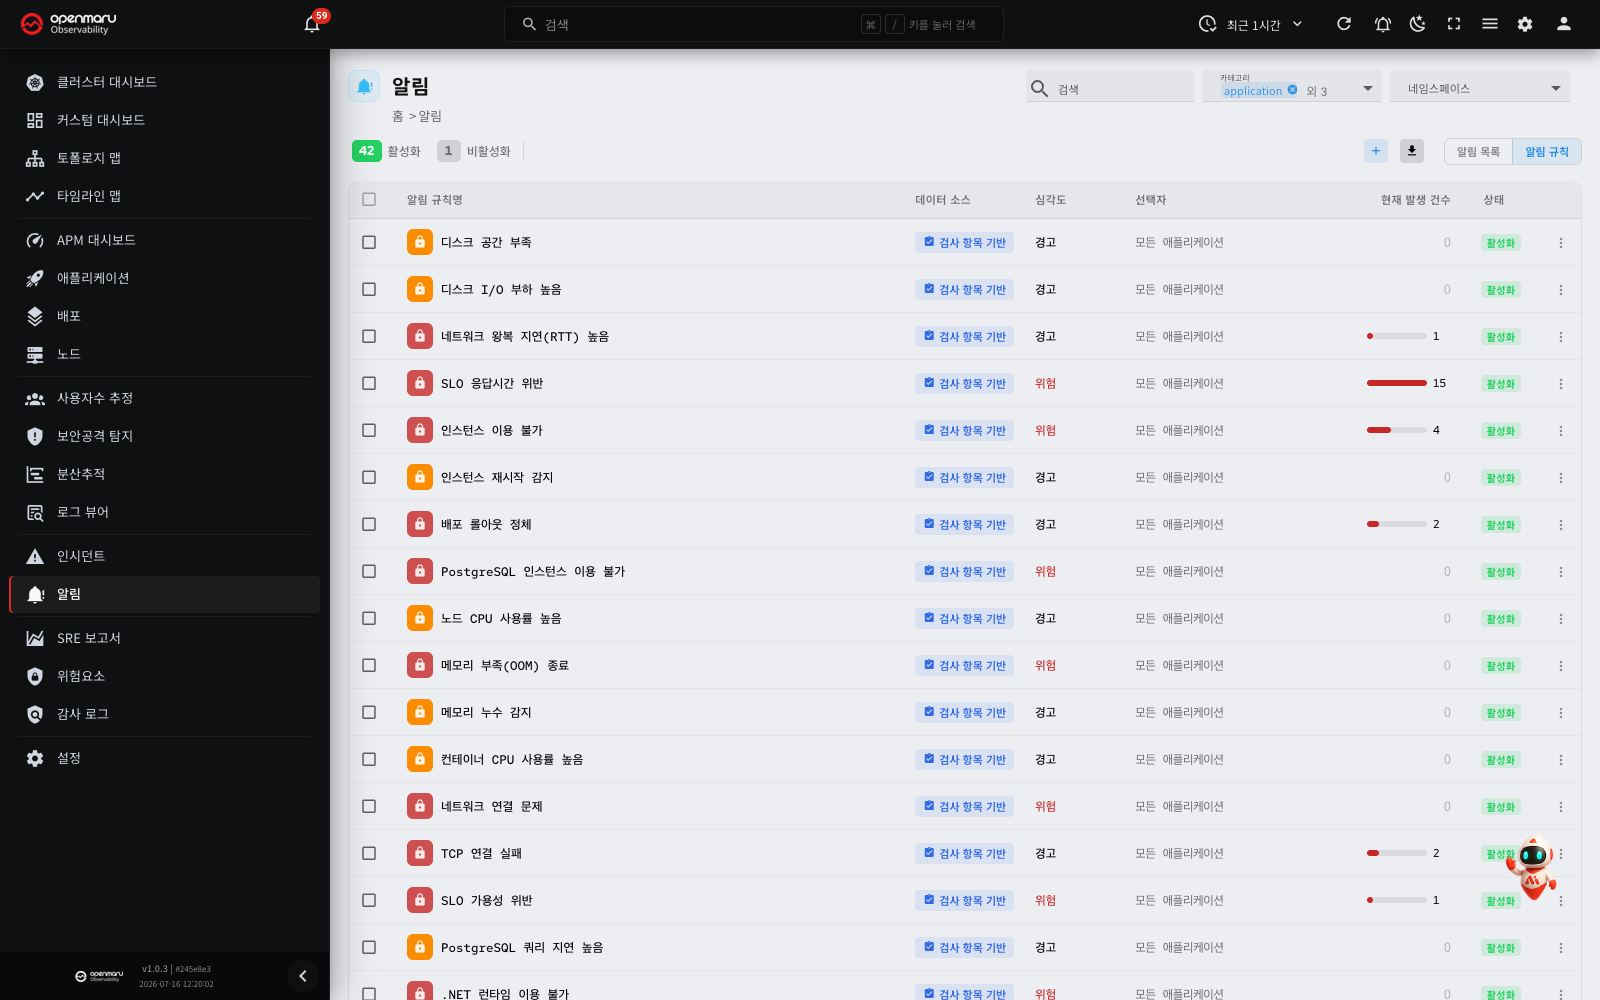
- 상단에 활성화·비활성화 규칙 개수가 표시되고, 우측 상단의 + 버튼(규칙 추가)으로 새 규칙을 추가하거나 내보내기 아이콘으로 규칙을 JSON으로 내보낼 수 있습니다.
- 규칙명 앞의 아이콘으로 종류를 세 가지로 구분합니다.
- 잠금(
mdi-lock) -- 설정 파일 관리(config-managed) 규칙. 설정 파일로 배포되어 화면에서는 편집·삭제할 수 없습니다. - 방패(
mdi-shield-check) -- 기본 제공(builtin) 규칙. 시스템이 최초 설치 시 자동으로 만든 규칙이며, 사용자 정의 규칙과 동일하게 편집·삭제할 수 있습니다(규칙명이 한글로 번역되어 표시된다는 점이 다릅니다). - 벨(
mdi-bell-ring) -- 사용자 정의 규칙. 편집·삭제가 모두 가능합니다.
- 잠금(
| 컬럼 | 설명 |
|---|---|
| 알림 규칙명 | 규칙 이름(Slack/Teams 메시지에 표시). 기본 제공 규칙은 한글로 번역되어 표시 |
| 데이터 소스 | 규칙이 평가하는 소스 유형(검사 항목 기반, 로그 패턴, PromQL, K8s 이벤트 등) |
| 심각도 | 경고 또는 위험 |
| 선택자 | 규칙이 적용되는 대상(모든 애플리케이션 / 카테고리별 / 애플리케이션별) |
| 현재 발생 건수 | 이 규칙으로 현재 발화 중인 알림 수(클릭 시 해당 알림만 필터링) |
| 상태 | 규칙 활성/비활성 토글 |
기본 제공 규칙은 49개입니다.
- 검사 항목 기반 규칙 46개: SLO·CPU·메모리·스토리지·네트워크·인스턴스·배포·DB·런타임·vLLM·DNS·로그·보안 공격 탐지
- 공격 IP 규칙 1개
- 리소스 예측 규칙 2개: CPU·메모리 용량이 7일 안에 고갈될 것으로 예측될 때
서버는 프로젝트에 없는 기본 제공 규칙을 자동으로 추가합니다. 그래서 새 버전에서 추가된 기본 제공 규칙은 기존 프로젝트에도 추가됩니다.
기본 제공 규칙의 임계값은 설정 > 검사 조건 설정에서 프로젝트 수준으로 재정의할 수 있습니다. 그 표에 없는 검사 항목(예: vLLM 검사)은 애플리케이션 상세에서 바꿉니다. 해당 탭 상단의 검사 항목에서 톱니바퀴 아이콘을 클릭하면 설정 창이 열립니다. 이 창에서 애플리케이션 수준 값과 프로젝트 수준 값을 모두 바꿀 수 있습니다.
vLLM 기본 알림 규칙
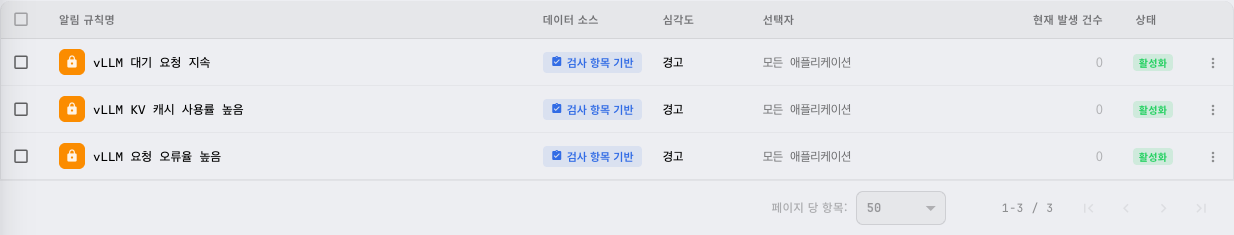
vLLM 엔진이 있는 애플리케이션에는 다음 기본 제공 규칙 3개가 적용됩니다. 세 규칙 모두 심각도는 경고이고, 경보 대기 시간은 5분, 해결 유예 시간은 1분입니다. 조건이 5분 동안 계속되어야 알림이 발생합니다. 조건이 풀린 뒤 1분 동안 다시 참이 되지 않아야 알림이 해결됩니다.
| 알림 규칙명 | 검사 항목 | 조건(기본 기준값) | 판정하지 않는 경우 |
|---|---|---|---|
| vLLM 요청 오류율 높음 | vLLM 요청 오류 | 최근 5분 동안 오류로 끝난 요청 비율 > 5% | 최근 5분 평균 요청률이 0.05 req/s(5분에 약 15건) 미만 |
| vLLM KV 캐시 사용률 높음 | vLLM KV 캐시 사용률 | vLLM 인스턴스의 KV 캐시 사용률 > 90% | KV 캐시가 없는 엔진(임베딩·리랭크) |
| vLLM 대기 요청 지속 | vLLM 대기 요청 | vLLM 인스턴스의 대기 요청 수 > 0 | -- |
- 오류율은 엔진 오류로 끝난 요청만 셉니다. 사용자가 취소한 요청(abort)은 세지 않습니다. 그래서 vLLM 탭의 완료·실패 요청 (초당) 차트에 실패가 보여도 이 알림은 발생하지 않을 수 있습니다.
- 요청이 적은 엔진의 오류는 SLO 가용성 위반 규칙으로 확인합니다.
- 첫 토큰 시간(TTFT)이 느린 경우는 SLO 응답시간 위반 규칙으로 확인합니다. vLLM 애플리케이션의 응답 시간 SLO 는 첫 토큰 시간으로 판정합니다.
- 애플리케이션 상세 vLLM 탭의 상태 표시등은 이 검사 결과에 따라 초록(정상) 또는 노랑(경고)으로 표시됩니다.
Python 런타임·DB 연결 기본 알림 규칙
Python 애플리케이션과 PostgreSQL·MySQL 을 쓰는 애플리케이션에는 다음 기본 제공 규칙 4개가 적용됩니다. 네 규칙 모두 심각도는 경고이고, 해결 유예 시간은 1분입니다.
| 알림 규칙명 | 검사 항목 | 조건(기본 기준값) | 경보 대기 시간 |
|---|---|---|---|
| Python 이벤트 루프 오래 막힘 | Python 이벤트 루프 막힘 | 최근 5분 이벤트 루프 최장 실행 시간의 최댓값 > 2초 | 1분 |
| Python GC 오래 멈춤 | Python GC 최장 멈춤 | 최근 5분 가장 긴 GC 멈춤의 최댓값 > 0.5초 | 1분 |
| Python GC 시간 비율 높음 | Python GC 시간 비율 | 최근 5분 동안 프로세스당 GC 시간 비율의 평균 > 5% | 5분 |
| DB 연결 사용률 높음 | DB 연결 사용률 | PostgreSQL·MySQL 목적지의 동시 질의 수 ÷ 열린 연결 수 > 90% | 5분 |
- 이벤트 루프와 가장 긴 GC 멈춤은 최근 5분의 최댓값으로 판정합니다. 그래서 한 번의 긴 막힘도 약 1분 뒤 알림이 됩니다. 막힘이 없어지고 5분이 지나면 조건이 풀리고, 해결 유예 1분 뒤 알림이 해결됩니다.
- 이벤트 루프 알림 문구에는 같은 5분의 가장 긴 GC 멈춤 값을 함께 적습니다. 예:
1개 Python 인스턴스에서 긴 이벤트 루프 막힘 (GC 최장 멈춤 1.10초). 두 값이 같으면 GC 가 루프를 막았다고 볼 수 있습니다. - 이벤트 루프를 쓰지 않는 앱에서 이벤트 루프 알림이 나오면, 애플리케이션 상세 파이썬 탭에서 그 앱의 검사 기준값을 크게 올려 알림을 끕니다.
- DB 연결 사용률은 앱 쪽에서 본 값입니다. DB 서버 쪽 연결 수는 PostgreSQL 커넥션 풀 고갈·MySQL 커넥션 풀 고갈 규칙이 봅니다.
- 검사 조건과 판정 방법은 애플리케이션 장의 파이썬 탭·네트워크 탭 설명을 참고하세요.
알림 규칙 설정
+ 버튼을 클릭하면 알림 규칙 생성 다이얼로그가 열립니다. 규칙을 편집하면 알림 규칙 수정 다이얼로그가 열립니다.
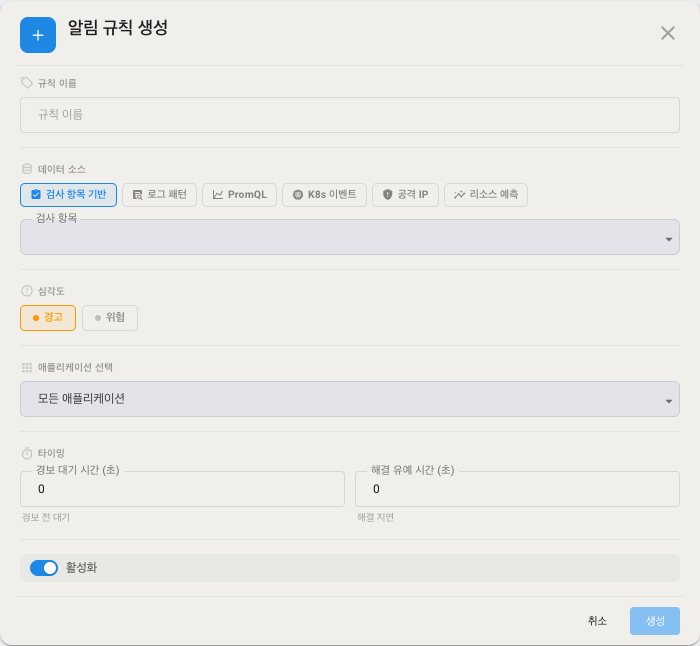
| 설정 항목 | 설명 |
|---|---|
| 규칙 이름 | 알림 메시지에 표시되는 식별 이름(예: 주문 서비스 응답 지연) |
| 데이터 소스 | 규칙이 평가할 소스를 선택합니다: 검사 항목 기반(내장 검사의 상태), 로그 패턴(로그의 에러/경고 집계), PromQL(메트릭 쿼리 표현식), K8s 이벤트(FailedScheduling 등 이벤트 집계), 공격 IP(보안 탐지), 리소스 예측(자원 고갈 예측) |
| 심각도 | 경고(주의 필요) 또는 위험(즉각 대응 필요) |
| 애플리케이션 선택 | 모든 애플리케이션 / 카테고리별 / 애플리케이션별(glob 패턴) |
| 타이밍 | 경보 대기 시간 (초)·해결 유예 시간 (초)(아래 참조) |
| 활성화 | 규칙의 활성/비활성 |
타이밍: 경보 대기 시간과 해결 유예 시간
타이밍 영역에는 시간 설정이 두 개 있습니다. 두 설정은 불필요한 알림(알림 피로)과, 알림이 열리고 닫히기를 반복하는 플래핑(flapping)을 줄입니다. 새 규칙은 두 값이 모두 0 으로 시작합니다.
- 경보 대기 시간 (초)(For): 조건이 이 시간 동안 계속 참이어야 알림이 발생합니다. 기다리는 중에 조건이 풀리면 대기를 취소합니다. 잠깐 튄 값으로 알림이 나가는 것을 막습니다.
0이면 조건이 참인 첫 평가에서 알림이 발생합니다. - 해결 유예 시간 (초)(KeepFiringFor): 조건이 풀린 뒤에도 발생 중인 알림을 이 시간 동안 열어 둡니다. 서버는 조건이 마지막으로 참이었던 평가 시각부터 시간을 셉니다. 그사이 조건이 다시 참이 되면 같은 알림이 이어지고, 통보는 나가지 않습니다. 이 시간 동안 조건이 계속 거짓이면 알림을 해결하고 해결 통보를 보냅니다.
0이면 조건이 풀린 평가에서 바로 해결합니다.
| 경보 대기 | 해결 유예 | 동작 |
|---|---|---|
| 0초 | 0초 | 조건이 참인 첫 평가에서 발생, 조건이 풀린 평가에서 바로 해결 |
| 300초 | 0초 | 조건이 5분 계속되면 발생, 조건이 풀린 평가에서 바로 해결 |
| 0초 | 300초 | 조건이 참인 첫 평가에서 발생, 마지막으로 참이었던 시각부터 5분 뒤 해결 |
| 300초 | 300초 | 조건이 5분 계속되면 발생, 마지막으로 참이었던 시각부터 5분 뒤 해결 |
해결 유예 시간은 다음과 같이 동작합니다.
- 발생 중인 알림에만 적용합니다. 경보 대기 시간을 아직 채우지 못한 알림은 조건이 풀리면 바로 버립니다.
- 알림의 해결 시각은 조건이 마지막으로 참이었던 시각으로 기록됩니다. 그래서 해결 시각은 해결 통보를 받은 시각보다 최대 해결 유예 시간만큼 앞섭니다.
- 서버는 규칙을 약 15초마다 평가합니다. 그래서 실제 유예는 설정값보다 최대 약 15초 깁니다.
- 사용자가 알림을 해결하거나, 규칙을 지우거나 끄거나, 애플리케이션이 없어지면 유예 없이 바로 해결합니다.
- 데이터 소스가 검사 항목 기반·PromQL·K8s 이벤트인 규칙은 유예 중에 평가가 멈춰도(예: 검사 항목에 데이터가 없음) 유예 시간이 지나면 알림을 해결합니다.
기본 제공 규칙은 다음 해결 유예 시간으로 만들어집니다. 규칙을 편집해 바꿀 수 있습니다.
| 해결 유예 시간 | 기본 제공 규칙 |
|---|---|
| 5분 | SLO 가용성·응답시간 위반, 인스턴스·DB·런타임 이용 불가, OOM, DB 복제 상태·지연, 보안 공격 탐지 |
| 1분 | 노드·컨테이너 CPU, 메모리 누수, 인스턴스 재시작, 네트워크, DB 지연·연결 수, JVM safepoint, Python GIL, vLLM 3개, DNS |
| 0(없음) | 디스크 공간, 디스크 I/O, 배포 멈춤, 로그 오류 패턴, 공격 IP, 리소스 예측 2개 |
알림 규칙의 해결 유예와 인시던트 해결 유예
알림 규칙의 해결 유예 시간 (초) 와 인시던트 해결 유예는 서로 다른 설정입니다.
| 구분 | 알림 규칙의 해결 유예 시간 | 인시던트 해결 유예 |
|---|---|---|
| 대상 | 그 규칙에서 발생한 알림 | 프로젝트의 모든 인시던트 |
| 설정 위치 | 알림 규칙마다(타이밍) | 설정 > 알림채널 연결 탭(프로젝트마다 하나) |
| 기본값 | 새 규칙 0. 기본 제공 규칙 0·1분·5분 | 5분(300초) |
| 끄는 방법 | 0 으로 설정 | 0 으로 설정 |
| 시간을 세는 기준 | 조건이 마지막으로 참이었던 평가 시각 | SLO 상태가 정상으로 돌아온 평가 시각 |
| 기록되는 해결 시각 | 조건이 마지막으로 참이었던 시각 | SLO 상태가 정상으로 돌아온 시각 |
두 기능은 따로 동작합니다. 같은 장애로 알림과 인시던트가 함께 열려 있으면, 알림은 알림 규칙의 해결 유예 시간에 따라 해결되고 인시던트는 인시던트 해결 유예에 따라 해결됩니다. 그래서 두 해결 통보의 시각이 다를 수 있습니다.
알림 채널 연결
발화된 알림을 Slack, MS Teams, Webhook 등 외부 채널로 통보하려면 설정 > 알림채널 연결에서 채널을 구성합니다. 채널별로 인시던트·배포·알림 수신 여부와 알림 언어(한국어/영어)를 선택할 수 있습니다. 자세한 내용은 설정 -- 알림채널 연결을 참조하세요.
관련 문서
- 애플리케이션 -- 애플리케이션별 상세 메트릭 및 SLO 현황
- 설정 -- 검사 조건 설정 -- SLO 임계값 및 검사 조건 설정
- 설정 -- 알림채널 연결 -- Slack/MS Teams/Webhook 알림 채널 구성
- 타임라인 맵 -- 시간 순서로 인시던트와 배포 이벤트 파악
- 분산추적 -- 추적 히트맵으로 응답 시간 이상 탐지
- 차트 가이드 -- 차트 읽는 법 및 공통 조작법