5.4. LLM 애플리케이션 추적
분산추적 화면에서 CogentAI 같은 LLM 애플리케이션의 호출 관계, 토큰, 입력·출력 메시지를 확인하는 방법을 설명합니다.
개요
LLM(Large Language Model, 대규모 언어 모델) 애플리케이션은 질문 하나를 처리할 때 여러 구성 요소를 거칩니다. 에이전트가 모델을 여러 번 부르고, 모델이 고른 도구를 실행하고, 그 결과를 다시 모델에 보냅니다. 응답이 느리거나 답이 틀리면 어느 단계에서 문제가 생겼는지 알아야 합니다.
분산추적 화면은 이 과정을 추적(Trace) 하나로 보여 줍니다. 이 장에서는 CogentAI 의 실제 추적으로 다음 정보를 확인하는 방법을 설명합니다.
- 구성 요소 사이의 호출 관계 (트리와 폭포수 차트)
- LLM 호출마다 사용한 입력·출력 토큰과 모델
- 모델 서버의 시간 분해 (대기열, 첫 토큰까지, 생성)
- 모델에 보낸 입력 메시지와 모델이 돌려준 출력 메시지
- 모델이 고른 도구(MCP) 호출
- 사용자에게 되물은 뒤 이어진 연관 추적
분산추적 화면의 기본 사용법은 분산추적을 참고하세요.
참고: 이 장의 화면은 2026-10-05 22:21 에 기록된 CogentAI 추적
27211112464e7cd0561267a95857b93e입니다. 사용자가 "애플리케이션 전체 모니터링 현황 보여줘" 라고 질문한 요청이며, 응답 시간 76.3초, 스팬 111개, 서비스 6개, LLM 호출 5번으로 구성됩니다.
무엇을 볼 수 있나
CogentAI 구성 요소
CogentAI 의 구성 요소는 각각 OpenTelemetry 로 추적 데이터를 보냅니다. 추적에서는 다음 서비스 이름으로 보입니다.
| 구성 요소 | 서비스 이름 | 추적에 남는 정보 |
|---|---|---|
| 요청 처리 서버 | openmaru-cogentai | 질문 하나의 시작과 끝(cogentai.request), 가드레일·RAG·에이전트 호출 단계, MySQL·Redis 호출 |
| 가드레일 | openmaru-guardrails | 질문 검사 요청 (POST /v1/guardrails/check) |
| RAG(검색 증강 생성) | openmaru-cogentai | 문서 검색 단계 (rag.search, rag.retrieve, rag.embed.*, rag.hybrid, rag.rerank 등) |
| 에이전트 | openmaru-hermes | 모델 호출(openai.chat)과 도구 호출(MCP send tools/call <도구 이름>) |
| LLM 게이트웨이 | openmaru-cogentai-litellm | 모델 호출 중계(chat <모델 별칭>), 실제 모델 이름 |
| 모델 서버 | openmaru-vllm | 모델 실행(llm_request)과 시간 분해 |
| MCP 도구 서버 | openmaru-cogentai-mcp-apm 등 | 요청 처리 서버가 부른 도구 실행 (tools/call <도구 이름>) |
LLM 스팬 판별
토큰 사용량 속성(gen_ai.usage.input_tokens 등)이 있는 스팬을 LLM 호출 스팬으로 봅니다. 화면은 LLM 호출 스팬에 주황색 LLM 배지를 붙이고, 배지에 입력과 출력 토큰의 합계를 표시합니다(예: LLM · 92.3k tok).
같은 모델 호출은 에이전트, LLM 게이트웨이, 모델 서버가 각자 스팬으로 기록합니다. 그래서 LLM 배지는 호출 하나에 세 번 보입니다. 아래 LLM 호출 상자는 이 세 스팬을 호출 하나로 합쳐서 보여 줍니다.
CogentAI 요청 찾기
CogentAI 에 들어온 질문 하나는 루트 스팬 이름이 cogentai.request 인 추적 하나입니다.
- 좌측 사이드바에서 분산추적 메뉴를 클릭합니다.
- 추적 탭을 클릭합니다.
- 필터 추가를 클릭합니다.
- 필드에서 루트 스팬 이름을 고르고, 값에
cogentai.request를 입력합니다. - 적용 버튼을 클릭합니다.
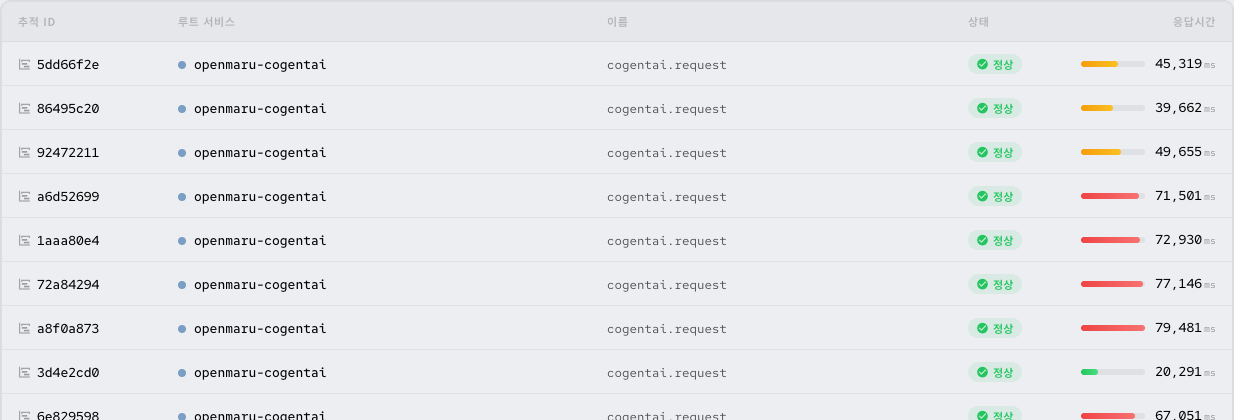
목록에는 질문마다 한 행이 표시됩니다. 응답시간 열로 오래 걸린 질문을 찾습니다. 행의 추적 ID, 루트 서비스 또는 이름을 클릭하면 추적 다이얼로그가 열립니다.
추적 ID 옆에 링크 아이콘이 있으면 그 추적은 다른 추적과 이어져 있습니다. 자세한 내용은 되묻기로 이어진 연관 추적을 참고하세요.
호출 관계 트리 읽기
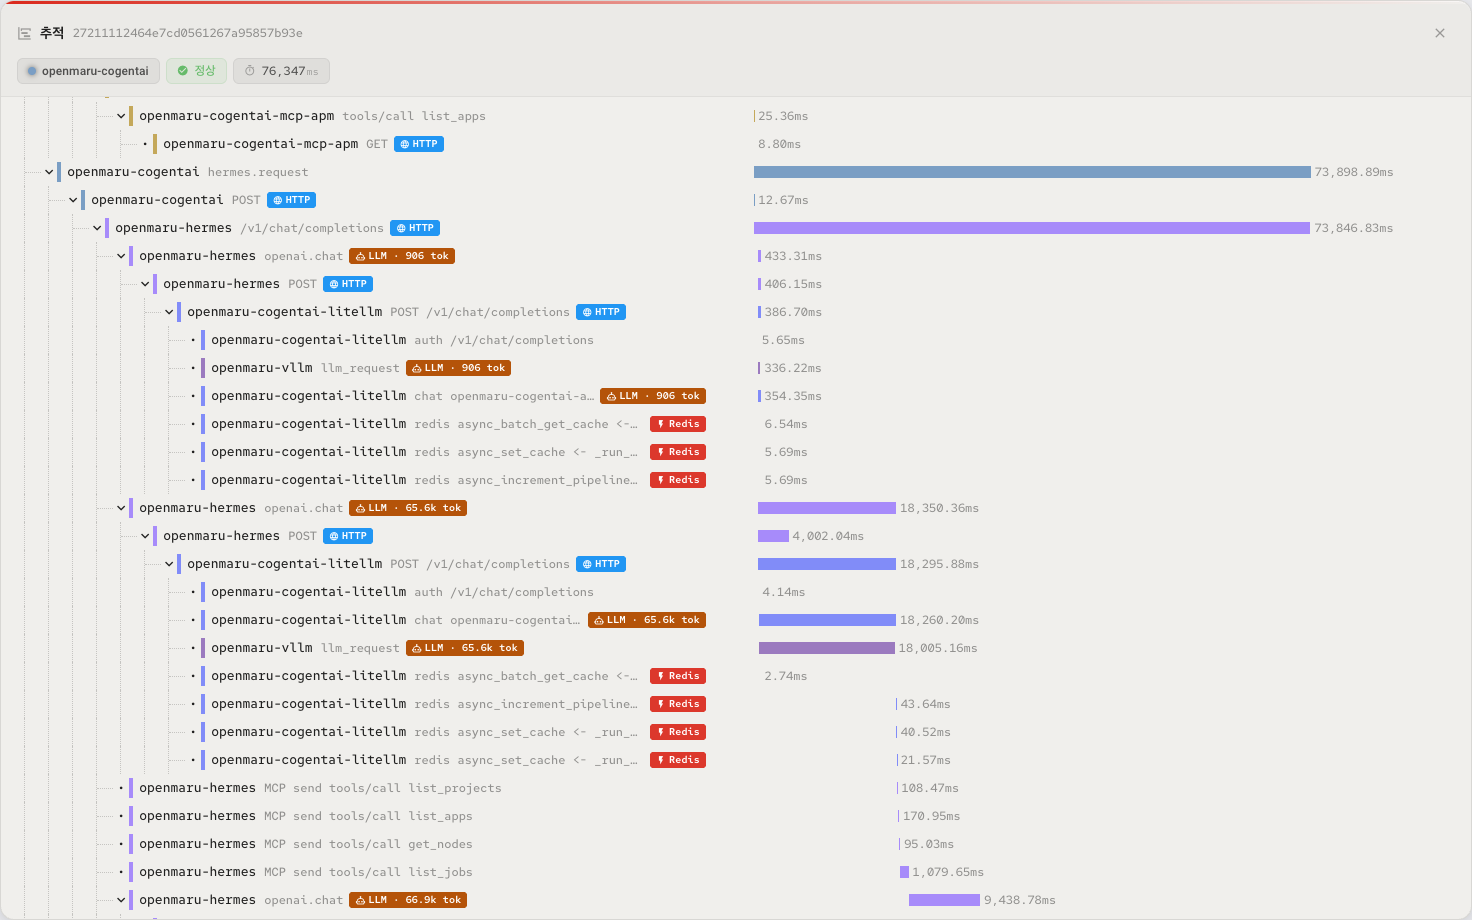
추적 다이얼로그의 서비스 & 작업 영역은 스팬을 호출 관계 순서대로 트리로 표시합니다. 자식 스팬은 부모 스팬 아래에 들여쓰기로 표시됩니다. 오른쪽 폭포수 차트의 가로 막대는 각 스팬의 시작 시점과 소요 시간을 나타냅니다.
위 화면은 에이전트 단계(hermes.request)입니다. 트리에서 다음 호출 관계를 읽을 수 있습니다.
- 요청 처리 서버(
openmaru-cogentai)가 에이전트(openmaru-hermes)에 요청을 보냅니다. - 에이전트가 모델을 부릅니다(
openai.chat). 이 호출은 LLM 게이트웨이(openmaru-cogentai-litellm)를 거쳐 모델 서버(openmaru-vllm)로 갑니다. - LLM 게이트웨이의
chat스팬과 모델 서버의llm_request스팬은 같은 부모 아래에 나란히 표시됩니다. - 모델이 도구 호출을 결정하면, 에이전트가 도구를 부릅니다(
MCP send tools/call list_projects등). - 에이전트는 도구 결과를 받은 뒤 모델을 다시 부릅니다. 이 추적에서 에이전트는 모델을 4번 불렀습니다.
막대 길이를 비교하면 시간이 어디에 쓰였는지 알 수 있습니다. 이 추적에서는 모델 호출 막대가 길고, 도구 호출 막대는 짧습니다. 시간 대부분을 모델 호출이 차지합니다.
주요 단계만 보기
스팬이 100개를 넘으면 트리가 몇 화면으로 길어집니다. 서비스 & 작업 머리글 오른쪽의 주요 단계만 보기를 클릭하면 루트 스팬 바로 아래 단계만 남기고 그 아래 스팬을 접습니다.
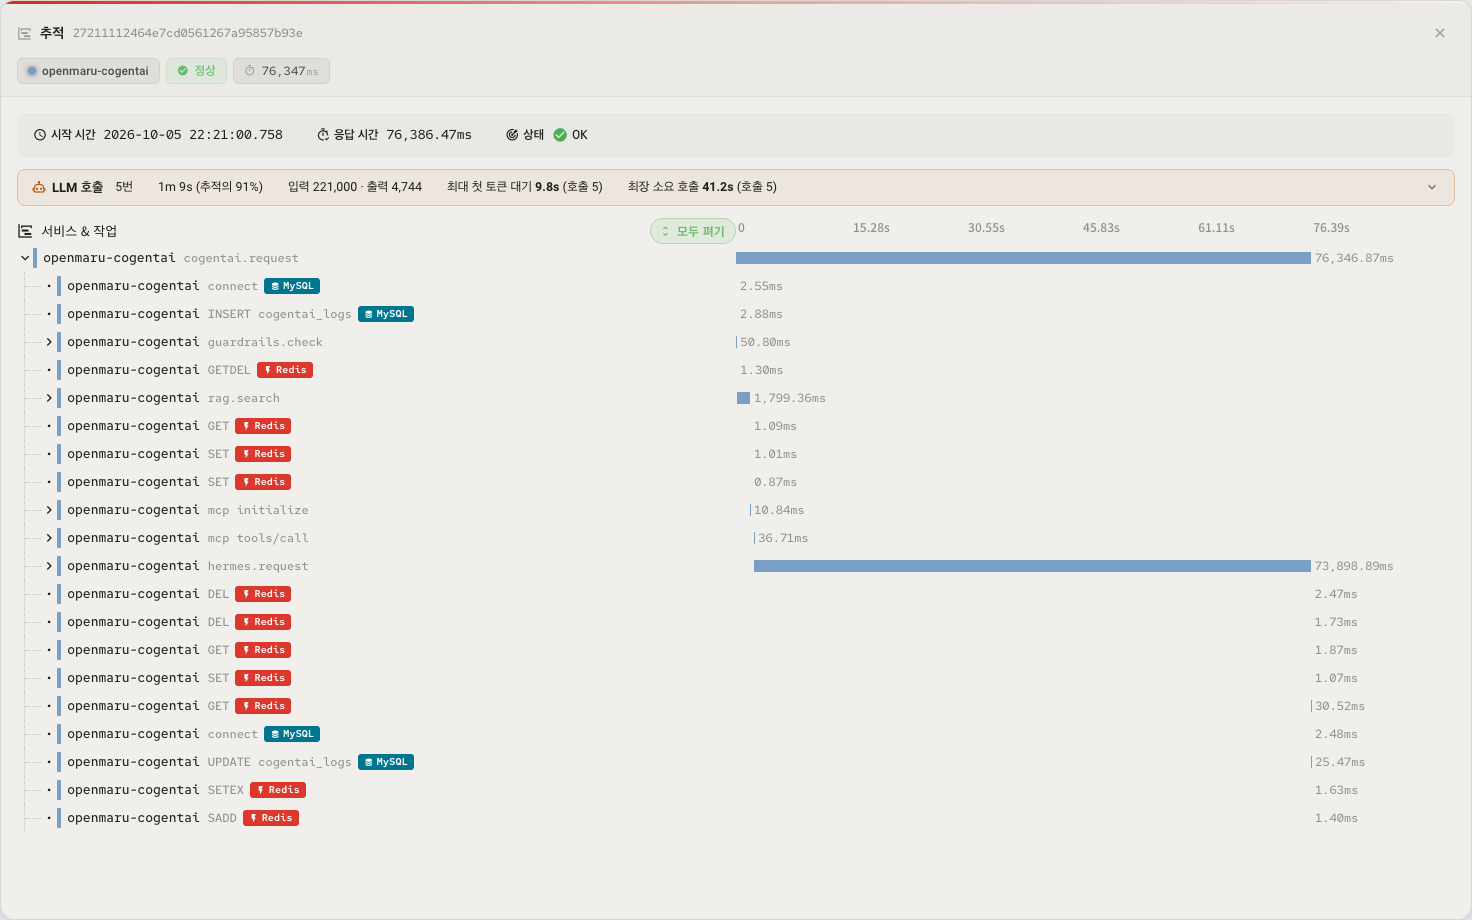
접힌 상태에서는 질문 하나가 거친 단계를 한 화면에서 볼 수 있습니다. 이 추적은 가드레일 검사(guardrails.check), 문서 검색(rag.search), 도구 준비(mcp initialize, mcp tools/call), 에이전트(hermes.request) 순서로 진행되었습니다. 에이전트 단계가 전체 76.3초 중 73.9초를 차지합니다.
접힌 행의 이름을 클릭하면 그 단계가 한 단계씩 펼쳐집니다. 모두 펴기를 클릭하면 모든 스팬을 다시 펼칩니다.
LLM 호출 상자
추적에 LLM 호출이 있으면 폭포수 차트 위에 LLM 호출 상자가 표시됩니다. 상자는 처음에 접혀 있고, 머리글에 추적 전체의 요약을 표시합니다.
| 머리글 항목 | 설명 |
|---|---|
| 호출 수 | 추적 안의 LLM 호출 수 (예: 5번) |
| 시간 | LLM 호출이 차지한 시간과 추적 전체에서의 비율. 겹치는 호출은 두 번 세지 않습니다. |
| 입력 · 출력 | 모든 호출의 입력 토큰과 출력 토큰 합계 |
| 최대 첫 토큰 대기 | 첫 출력 토큰이 나올 때까지 가장 오래 기다린 호출과 그 시간 |
| 최장 소요 호출 | 가장 오래 걸린 호출과 그 시간 |
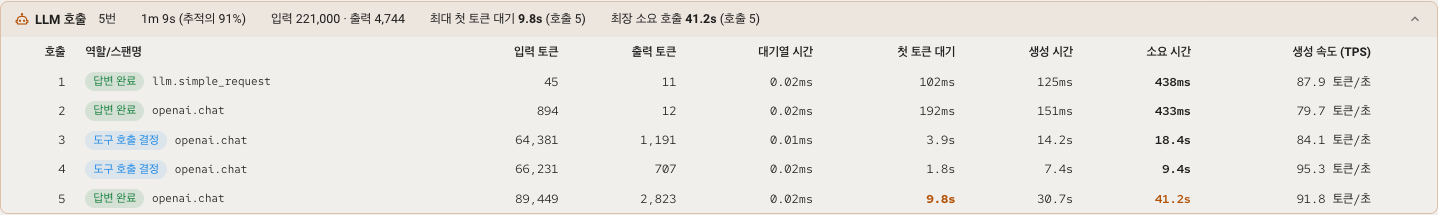
머리글을 클릭하면 호출마다 한 행인 표가 펼쳐집니다.
| 열 | 설명 |
|---|---|
| 호출 | 호출 순서 번호 |
| 역할/스팬명 | 호출의 역할과 호출한 쪽의 스팬 이름. 역할은 모델의 종료 이유로 정합니다. |
| 입력 토큰 / 출력 토큰 | 이 호출의 토큰 수 |
| 대기열 시간 | 모델 서버의 대기열에서 기다린 시간 |
| 첫 토큰 대기 | 첫 출력 토큰이 나올 때까지의 시간. 대기열 시간이 들어 있고, 나머지는 대부분 입력을 읽는 시간입니다. 모델 서버의 시간 속성이 없는 호출은 LLM 게이트웨이의 첫 응답 조각까지 시간을 표시합니다. |
| 생성 시간 | 출력 토큰을 만든 시간 (추론 포함) |
| 소요 시간 | 호출 전체 시간 |
| 생성 속도 (TPS) | 출력 토큰 수 ÷ 생성 시간 |
역할 배지는 다음과 같습니다.
| 역할 | 종료 이유 | 뜻 |
|---|---|---|
| 도구 호출 결정 | tool_call, tool_calls | 모델이 답 대신 도구 호출을 돌려주었습니다. 에이전트가 도구를 실행하고 모델을 다시 부릅니다. |
| 답변 완료 | stop | 모델이 답을 끝까지 만들었습니다. |
| 길이 제한으로 끊김 | length | 출력 토큰 상한에 닿아 답이 중간에서 끊겼습니다. |
그 밖의 종료 이유는 값을 그대로 표시합니다. 종료 이유가 기록되지 않은 호출은 – 를 표시합니다.
위 화면에서 다음 사실을 읽을 수 있습니다.
- 호출 1(
llm.simple_request)은 문서 검색 단계에서 부른 짧은 호출입니다. - 호출 2 는 에이전트가 대화 제목을 만들려고 부른 호출입니다(입력 메시지에서 확인).
- 호출 3, 4 는 도구 호출 결정입니다. 모델이 도구를 고르는 데 각각 18.4초, 9.4초가 걸렸습니다.
- 호출 5 가 최종 답입니다. 입력이 89,449 토큰이라 첫 토큰까지 9.8초가 걸렸고, 2,823 토큰을 만드는 데 30.7초가 걸렸습니다.
첫 토큰 대기와 소요 시간이 가장 긴 값은 주황색으로 표시됩니다. 입력 토큰이 많을수록 첫 토큰 대기가 길어집니다. 첫 토큰 대기가 길면 입력(대화 기록, 검색 문서, 도구 정의)의 크기를 먼저 확인하세요.
표의 행을 클릭하면 그 호출의 스팬 상세가 열립니다. 모델 서버의 시간 속성이 있는 스팬(vLLM llm_request)이 열립니다.
같은 호출을 하나로 합치는 기준
에이전트와 LLM 게이트웨이는 응답 ID(gen_ai.response.id)를, 모델 서버는 요청 ID(gen_ai.request.id)를 기록합니다. 두 값은 같은 호출이면 같습니다(예: chatcmpl-a3e39e27408fc03f). 화면은 이 값이 같은 스팬을 호출 하나로 합칩니다.
임베딩과 재정렬(rerank) 호출은 답을 만드는 호출이 아니라서 표에 넣지 않습니다.
LLM 스팬 상세
툴팁
LLM 배지가 있는 스팬에 마우스를 올리면 툴팁에 토큰(입력 / 출력)과 모델 행이 표시됩니다.
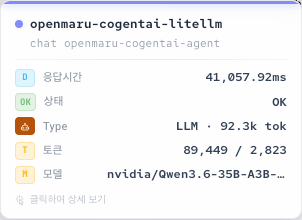
같은 호출이라도 스팬마다 모델 이름이 다를 수 있습니다. 에이전트 스팬은 에이전트가 요청한 모델 별칭(openmaru-cogentai-agent)을 표시합니다. LLM 게이트웨이 스팬은 실제로 응답한 모델(nvidia/Qwen3.6-35B-A3B-NVFP4)을 표시합니다. 모델 서버 스팬에는 모델 속성이 없어서 – 가 표시됩니다.
스팬 상세
LLM 배지, 정보 버튼 또는 가로 막대를 클릭하면 스팬 상세 다이얼로그가 열립니다. 위쪽 요약에 토큰과 모델이 표시되고, 속성 목록에 LLM 속성이 표시됩니다.
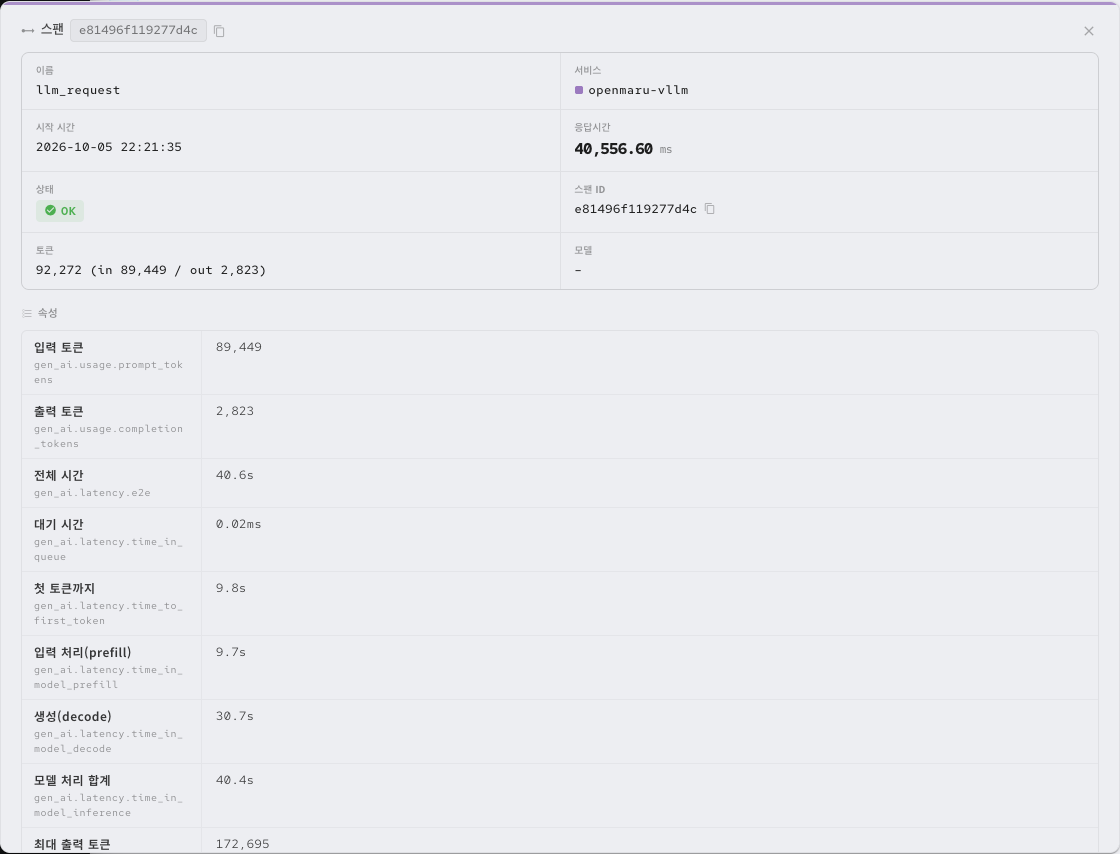
자주 쓰는 LLM 속성은 한국어 이름과 원래 키를 함께 표시합니다.
| 화면 이름 | 속성 키 | 설명 |
|---|---|---|
| 요청 모델 / 응답 모델 | gen_ai.request.model, gen_ai.response.model | 요청한 모델 이름과 실제로 응답한 모델 이름 |
| 종료 이유 | gen_ai.response.finish_reasons | stop, tool_call, length 등 |
| 입력 토큰 / 출력 토큰 / 전체 토큰 | gen_ai.usage.* | 토큰 수. 모델 서버는 prompt_tokens, completion_tokens 키를 씁니다. |
| 첫 응답 조각까지 | gen_ai.response.time_to_first_chunk | LLM 게이트웨이가 첫 응답 조각을 받을 때까지의 시간 |
| 비용 | litellm.cost.total | LLM 게이트웨이가 계산한 비용 |
| 입력 메시지 / 출력 메시지 | gen_ai.input.messages, gen_ai.output.messages | 모델에 보낸 메시지와 모델이 돌려준 메시지 |
모델 서버(vLLM) 스팬은 호출 시간을 다음과 같이 나누어 기록합니다.
| 화면 이름 | 속성 키 | 위 화면의 값 |
|---|---|---|
| 전체 시간 | gen_ai.latency.e2e | 40.6s |
| 대기 시간 | gen_ai.latency.time_in_queue | 0.02ms |
| 첫 토큰까지 | gen_ai.latency.time_to_first_token | 9.8s |
| 입력 처리(prefill) | gen_ai.latency.time_in_model_prefill | 9.7s |
| 생성(decode) | gen_ai.latency.time_in_model_decode | 30.7s |
| 모델 처리 합계 | gen_ai.latency.time_in_model_inference | 40.4s |
이 표의 대기 시간은 LLM 호출 상자의 대기열 시간과 같은 값입니다. 대기 시간이 길면 모델 서버에 요청이 밀려 있습니다. 입력 처리 시간이 길면 입력이 큽니다. 생성 시간이 길면 출력이 길거나 생성 속도가 느립니다.
입력·출력 메시지 보기
에이전트와 LLM 게이트웨이 스팬은 모델에 보낸 메시지(입력 메시지)와 모델이 돌려준 메시지(출력 메시지)를 속성으로 기록합니다. 값은 JSON 이고, 화면은 구문 강조를 적용해 표시합니다.
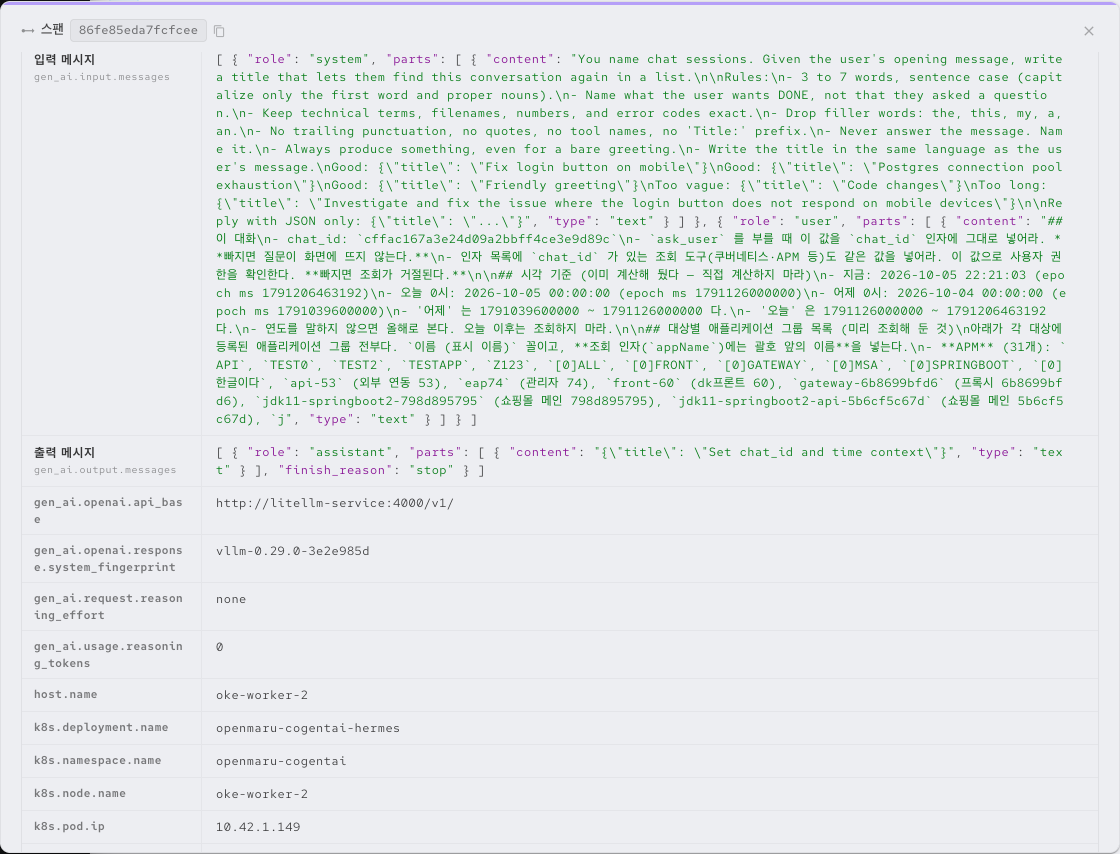
위 화면은 호출 2 의 메시지입니다. 입력 메시지는 역할(role)별로 나뉩니다.
system: 모델에 주는 지시입니다. 이 호출은 "대화 제목을 만든다" 는 지시를 보냈습니다.user: 사용자 질문과 요청 처리 서버가 덧붙인 정보입니다.assistant: 모델이 앞에서 돌려준 답과 도구 호출입니다.tool: 도구 실행 결과입니다.
출력 메시지에는 모델이 만든 답과 종료 이유(finish_reason)가 있습니다. 호출 2 는 {"title": "Set chat_id and time context"} 를 돌려주었습니다.
메시지로 다음을 확인할 수 있습니다.
- 모델이 엉뚱한 답을 했을 때 모델이 실제로 받은 지시와 질문
- 검색 문서(RAG 결과)가 입력에 들어갔는지
- 입력 토큰이 많은 이유 (긴 지시, 긴 대화 기록, 많은 도구 정의)
각 속성 행의 복사 버튼을 클릭하면 화면에 보이는 값이 아니라 수집된 원래 값을 키=값 형식으로 복사합니다.
도구(MCP) 호출 보기
모델이 도구 호출을 결정하면, 그 호출의 출력 메시지에 "type": "tool_call" 항목이 들어갑니다. 항목마다 도구 이름(name)과 인자(arguments)가 있습니다.
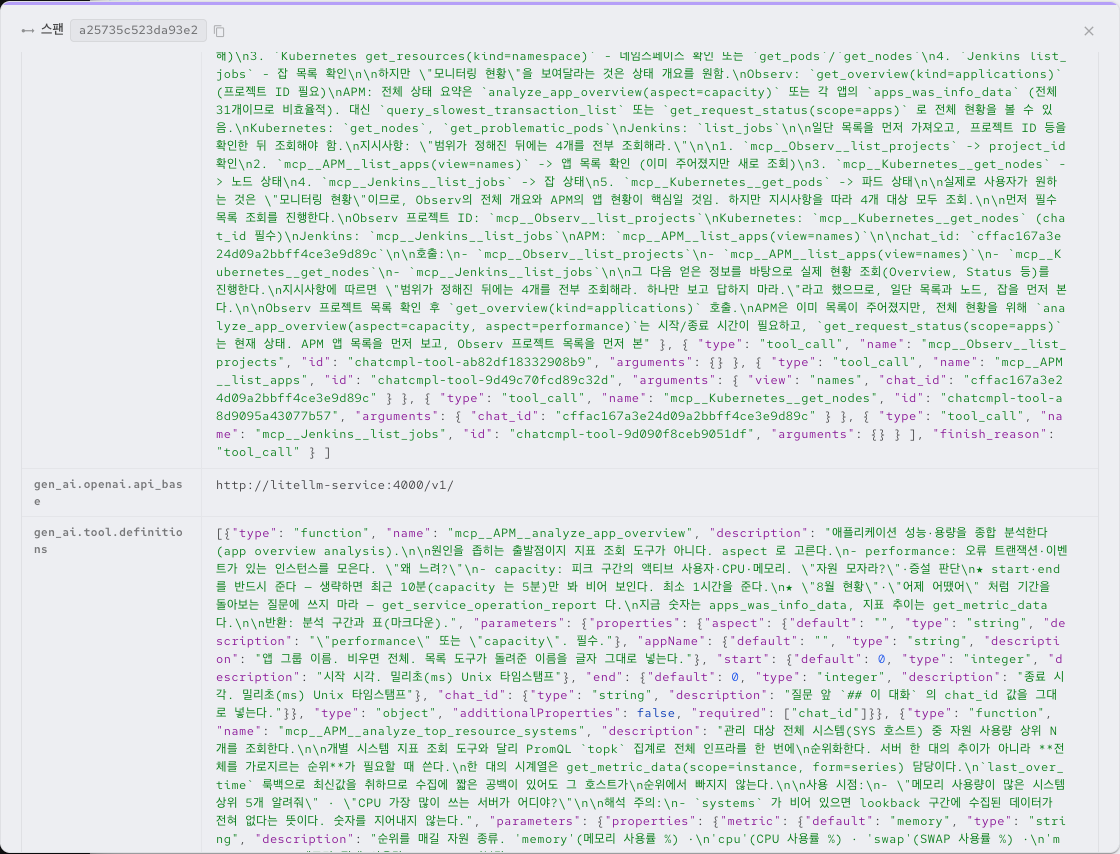
위 화면은 호출 3 의 출력 메시지 끝부분입니다. 모델이 추론(reasoning)을 마친 뒤 도구 4개(mcp__Observ__list_projects, mcp__APM__list_apps, mcp__Kubernetes__get_nodes, mcp__Jenkins__list_jobs)를 고르고, 종료 이유 tool_call 로 끝났습니다.
에이전트는 고른 도구를 차례로 부릅니다. 트리에서는 MCP send tools/call <도구 이름> 스팬으로 보입니다. 이 스팬에는 스팬 이름의 도구 이름, 소요 시간, mcp.method.name·jsonrpc.request.id, 실행 환경 속성만 있습니다. 도구 인자와 결과는 이 스팬에 남지 않습니다.
도구 인자와 결과는 메시지에서 확인합니다.
| 확인할 내용 | 볼 곳 |
|---|---|
| 모델이 고른 도구와 인자 | 도구 호출을 결정한 호출의 출력 메시지 (tool_call 항목) |
| 도구 실행 결과 | 다음 호출의 입력 메시지 ("role": "tool" 메시지) |
| 사용할 수 있는 도구 목록 | 에이전트 스팬의 gen_ai.tool.definitions 속성 |
되묻기로 이어진 연관 추적
CogentAI 는 답하기 전에 사용자에게 되물을 수 있습니다. 사용자가 답하면, 답을 처리하는 요청은 새 추적으로 기록됩니다. 이 추적의 루트 스팬은 Span Link 로 앞 추적을 가리킵니다. 루트 스팬 속성 cogentai.turn.kind 는 ask_user_answer 입니다.
이어진 추적은 다음 위치에서 확인합니다.
- 추적 목록: 추적 ID 옆에 링크 아이콘이 표시됩니다. 아이콘을 클릭하면 이어진 추적을 한 화면에서 봅니다.
- 추적 화면: 링크로 이어진 추적 N개 안내와 연관 추적 보기 버튼이 표시됩니다.
- 루트 스팬 상세: 연결된 추적 영역에 앞 추적의 ID 가 표시됩니다. ID 를 클릭하면 그 추적이 열립니다.
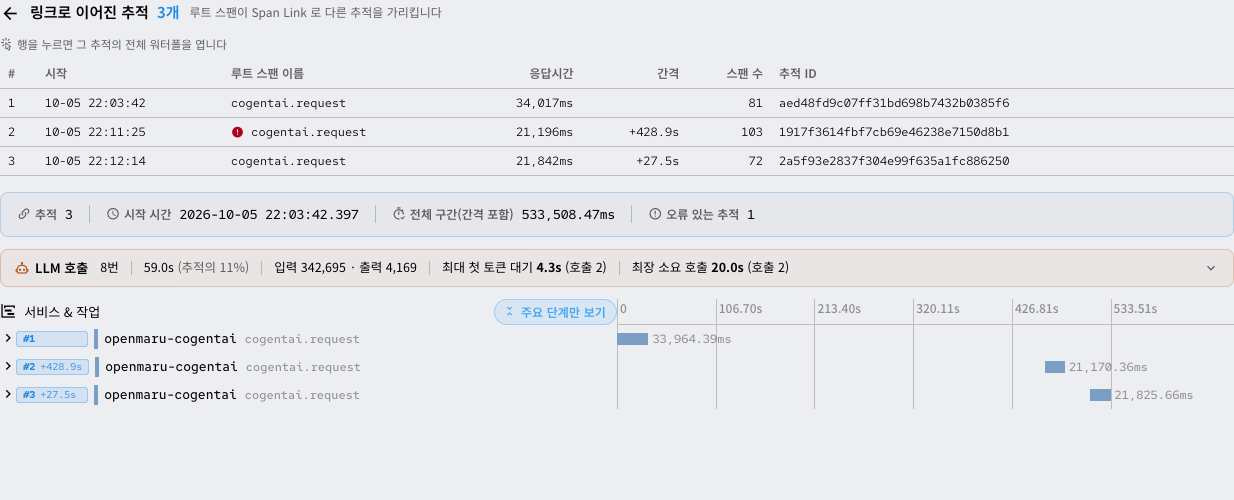
링크로 이어진 추적 화면은 이어진 추적을 시작 시각 순서로 표시합니다.
| 영역 | 설명 |
|---|---|
| 추적 표 | 순서, 시작 시각, 루트 스팬 이름, 응답시간, 앞 추적과의 간격, 스팬 수, 추적 ID. 행을 클릭하면 그 추적의 전체 폭포수 차트가 열립니다. |
| 요약 | 추적 수, 시작 시간, 전체 구간(간격 포함), 오류 있는 추적 수 |
| LLM 호출 상자 | 모든 추적의 LLM 호출. 호출이 어느 추적에 속하는지 추적 열(#1, #2 …)에 표시됩니다. |
| 폭포수 차트 | 추적마다 #번호와 앞 추적과의 간격(예: +428.9s)을 붙여 한 시간축에 표시합니다. |
간격은 앞 추적이 끝난 때부터 다음 추적이 시작된 때까지의 시간입니다. 위 화면에서 #2 는 #1 이 끝나고 428.9초 뒤에, #3 은 #2 가 끝나고 27.5초 뒤에 시작되었습니다. 간격에는 사용자가 답을 입력한 시간이 들어 있습니다. 따라서 간격은 CogentAI 의 처리 시간이 아닙니다.
주의점
- 개인정보: 입력·출력 메시지에는 사용자 질문과 모델의 답이 그대로 기록됩니다. 분산추적 화면에 접근할 수 있는 사용자는 이 내용을 볼 수 있습니다. 질문에 개인정보가 들어갈 수 있는 환경이면 추적 화면의 접근 권한을 확인하세요.
- 잘린 메시지: 약 64KiB 보다 긴 메시지는 수집할 때 잘립니다. 잘린 값은 JSON 형식이 깨져서 들여쓰기 없이 한 덩어리로 표시됩니다. 한글은 그대로 표시됩니다. 에이전트 스팬의 입력 메시지는 긴 지시 때문에 앞부분(
system,user)만 남는 경우가 많습니다. 이때 같은 호출의 LLM 게이트웨이 스팬에는 도구 결과(tool)까지 남을 수 있습니다. - 도구 인자와 결과: 도구 호출 스팬(
MCP send tools/call)에는 인자와 결과가 남지 않습니다. 메시지에서 확인하세요. 메시지가 잘리면 확인하지 못할 수 있습니다. - 모델 이름: 에이전트 스팬은 모델 별칭을, LLM 게이트웨이 스팬은 실제 모델 이름을 표시합니다. 모델을 확인할 때는 LLM 게이트웨이 스팬을 보세요.
- 토큰 합계: LLM 배지는 같은 호출의 스팬마다 표시됩니다. 추적 전체의 토큰 수는 배지를 더하지 말고 LLM 호출 상자의 머리글에서 확인하세요.